
وقتی با هزاران تیکت پشتیبانی، توییت یا مقالهی خبری بدون برچسب روبهرو میشوید، مطالعهی دستی آنها ناممکن است. مدلسازی موضوعی (Topic Modeling) راهکاری بدون نظارت است که درونمایههای اصلی متنها را کشف میکند و الگوهای پنهان داده را بدون نیاز به دادهی برچسبخورده آشکار میسازد.
در این درس، دو رویکرد اصلی را بررسی میکنیم: رویکرد کلاسیک و بیزیِ LDA که برای اسناد طولانی و تخصیص چند موضوع به یک سند عالی است، و رویکرد مدرنِ BERTopic که با تکیه بر ترنسفورمرها و درک معنایی، برای متنهای کوتاه مانند شبکههای اجتماعی عملکرد فوقالعادهای دارد. در پایان یاد میگیرید کدام الگوریتم برای دادههای شما مناسبتر است و چطور نتایج را بسنجید.
برای اجرای کدهای این آموزش، مدلهای اولیهی LDA روی پردازندهی معمولی (CPU) اجرا میشوند؛ اما برای دانلود وزنهای ترنسفورمر در BERTopic از مخزن Hugging Face یا نصب کتابخانهها از PyPI، ممکن است به دلیل اختلالات و کندی دسترسی اینترنت به میرورهای پایدار نیاز داشته باشید.
در LDA: اسناد ترکیبی از موضوعاتاند و موضوعات، توزیعی روی کلمات. در BERTopic: اسناد در فضای امبدینگ خوشهبندی میشوند و این خوشهها همان موضوعاتاند. هدفی یکسان با دو شیوهی تجزیهی متفاوت.
صورت مسئله
فرض کنید 10,000 تیکت پشتیبانی، 50,000 مقالهی خبری یا 200,000 توییت دارید و میخواهید بدون خواندن تکتک متنها بفهمید این مجموعه دربارهی چیست. هیچ دستهبندی برچسبخوردهای ندارید؛ حتی نمیدانید اصلاً چند دستهبندی وجود دارد.
مدلسازی موضوعی (Topic Modeling) این مسئله را بدون نظارت حل میکند. مجموعهی متنی (Corpus) را به آن میدهید و در خروجی، مجموعهای کوچک از موضوعات منسجم و برای هر سند، توزیعی روی این موضوعات تحویل میگیرید.
دو خانوادهی الگوریتمی بر این حوزه مسلطاند. الگوریتم LDA محصول سال 2003، هر سند را ترکیبی از موضوعات نهفته و هر موضوع را توزیعی روی کلمات در نظر میگیرد. فرایند استنتاج آن بیزی است. این روش هنوز در محیطهای پروداکشن به کار میرود؛ بهویژه جاهایی که به تخصیص همزمان چند موضوع به یک سند (عضویت چندگانه یا Mixed-membership) و توزیعهای احتمالاتی قابلتفسیر در سطح کلمات نیاز دارید.
در سوی دیگر، BERTopic محصول سال 2020، اسناد را با BERT انکود میکند، ابعاد بردارها را با UMAP کاهش میدهد، با HDBSCAN خوشهبندی میکند و کلمات کلیدی هر موضوع را با روش TF-IDF مبتنی بر کلاس (c-TF-IDF) بیرون میکشد. این روش روی متنهای کوتاه، محتوای شبکههای اجتماعی و هر جایی که شباهت معنایی مهمتر از همپوشانی ظاهری کلمات باشد، دست بالا را دارد. در این روش به هر سند فقط یک موضوع اختصاص مییابد که این برای متنهای طولانی نوعی محدودیت به شمار میرود.
این درس درک شهودی هر دو روش را میسازد و مشخص میکند کدامیک برای یک مجموعهی متنی مشخص مناسبتر است.
مفاهیم پایه
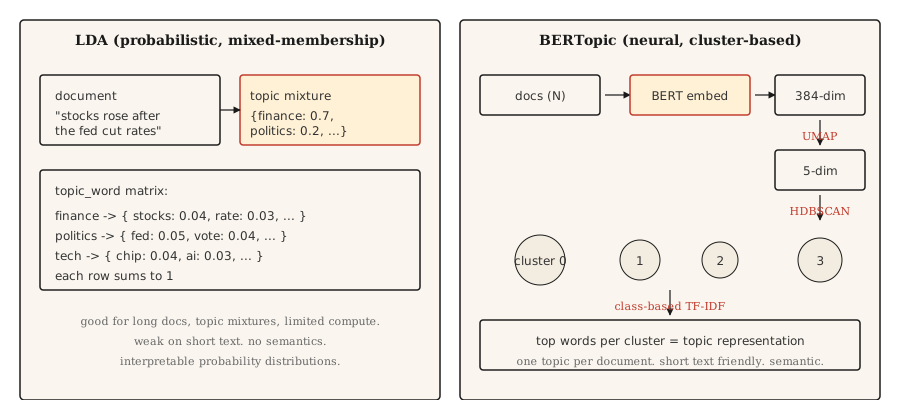
فرایند زایشی در LDA. هر موضوع یک توزیع روی کلمات است. هر سند نیز ترکیبی از موضوعات به حساب میآید. برای تولید یک کلمه در سند، ابتدا موضوعی بر اساس ترکیب موضوعی آن سند نمونهبرداری میشود و سپس کلمهای از توزیع همان موضوع بیرون میآید. فرایند استنتاج، معکوسِ همین روند است: با داشتن کلمات مشاهدهشده، توزیع موضوعی هر سند و توزیع کلمات هر موضوع استنباط میشود. محاسبات ریاضی این فرایند با نمونهبرداری گیبس تجمیعشده (Collapsed Gibbs Sampling) یا روش بیزی متغیری (Variational Bayes) انجام میگیرد.
خروجیهای کلیدی LDA:
doc_topic: ماتریسی با ابعاد(n_docs, n_topics)که جمع هر سطر آن برابر با 1 است (ترکیب موضوعی هر سند).topic_word: ماتریسی با ابعاد(n_topics, vocab_size)که جمع هر سطر آن برابر با 1 است (توزیع کلمات هر موضوع).
پایپلاین BERTopic.
- انکود هر سند با یک ترنسفورمر متنی (مانند
all-MiniLM-L6-v2) برای تولید بردارهای 384 بُعدی. - کاهش ابعاد با UMAP به حدود 5 بُعد؛ چون امبدینگهای BERT برای خوشهبندی بیشازحد پربُعدند.
- خوشهبندی با الگوریتم مبتنی بر چگالی HDBSCAN که خوشههایی با اندازههای متغیر و برچسب «دادهی پرت» (Outlier) تولید میکند.
- محاسبهی TF-IDF مبتنی بر کلاس روی اسنادِ هر خوشه برای استخراج کلمات برتر.
خروجی، یک موضوع بهازای هر سند است (بههمراه برچسب 1- برای دادههای پرت). البته با استفاده از بردار احتمالات HDBSCAN میتوان عضویت نرم (احتمالاتی) را هم به دست آورد.
پیادهسازی
گام 1: اجرای LDA با scikit-learn
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.decomposition import LatentDirichletAllocation
import numpy as np


def fit_lda(documents, n_topics=5, max_features=1000):
    cv = CountVectorizer(
        max_features=max_features,
        stop_words="english",
        min_df=2,
        max_df=0.9,
    )
    X = cv.fit_transform(documents)
    lda = LatentDirichletAllocation(
        n_components=n_topics,
        random_state=42,
        max_iter=50,
        learning_method="online",
    )
    doc_topic = lda.fit_transform(X)
    feature_names = cv.get_feature_names_out()
    return lda, cv, doc_topic, feature_names


def print_top_words(lda, feature_names, n_top=10):
    for idx, topic in enumerate(lda.components_):
        top_idx = np.argsort(-topic)[:n_top]
        words = [feature_names[i] for i in top_idx]
        print(f"topic {idx}: {' '.join(words)}")
به چند نکته دقت کنید: کلمات توقف (Stopwords) حذف شدهاند؛ پارامترهای min_df و max_df واژههای بسیار نادر یا همهجاحاضر را فیلتر میکنند؛ و از CountVectorizer استفاده شده نه TfidfVectorizer؛ چون LDA فراوانی خام کلمات را میخواهد.
گام 2: اجرای BERTopic (نسخهی پروداکشن)
from bertopic import BERTopic

topic_model = BERTopic(
    embedding_model="sentence-transformers/all-MiniLM-L6-v2",
    min_topic_size=15,
    verbose=True,
)

topics, probs = topic_model.fit_transform(documents)
info = topic_model.get_topic_info()
print(info.head(20))
valid_topics = info[info["Topic"] != -1]["Topic"].tolist()
for topic_id in valid_topics[:5]:
    print(f"topic {topic_id}: {topic_model.get_topic(topic_id)[:10]}")
فیلتر Topic != -1 دستهی دادههای پرت BERTopic (اسنادی که HDBSCAN نتوانسته در هیچ خوشهای جای دهد) را کنار میگذارد. پارامتر min_topic_size حداقل اندازهی هر خوشه را در HDBSCAN تعیین میکند؛ پیشفرض کتابخانه 10 است، اما در این مثال برای مقیاس دادههای آموزشی صریحاً روی 15 تنظیم شده است. برای مجموعههای متنی با بیش از 10,000 سند، این عدد را به 50 یا 100 برسانید.
گام 3: ارزیابی
هر دو روش فهرستی از کلمات موضوعی تحویل میدهند. مسئله این است که آیا این کلمات در کنار هم منسجماند یا نه.
- انسجام موضوعی (c_v Coherence). این معیار، شاخص NPMI (اطلاعات متقابل نقطهای نرمالشده) را میان جفتکلمات برتر در پنجرههای لغزان محاسبه میکند، امتیازها را بهصورت بردارهای موضوعی تجمیع مینماید و این بردارها را با شباهت کسینوسی میسنجد. هرچه این عدد بالاتر باشد، بهتر است. برای محاسبه از
gensim.models.CoherenceModelباcoherence="c_v"استفاده کنید. - تنوع موضوعی (Topic Diversity). نسبت کلمات یکتا میان واژههای برتر همهی موضوعات. هرچه بالاتر باشد بهتر است (موضوعات با هم همپوشانی ندارند).
- بررسی کیفی. کلمات برتر هر موضوع را بخوانید. آیا واقعاً به یک مفهوم یا چیز واقعی اشاره دارند؟ قضاوت انسانی همچنان آخرین خط دفاعی ارزیابی است.
چه زمانی کدام را انتخاب کنیم؟
| شرایط | انتخاب |
|---|---|
| متنهای کوتاه (توییت، نظر، تیتر خبر) | BERTopic |
| اسناد بلند با موضوعات درهمآمیخته | LDA |
| نبود GPU / منابع پردازشی محدود | LDA یا NMF |
| نیاز به توزیع موضوعی چندگانه در سطح سند | LDA |
| یکپارچهسازی با مدلهای زبانی (LLM) برای نامگذاری موضوعات | BERTopic (پشتیبانی مستقیم) |
| استقرار روی دستگاههای لبه با منابع محدود | LDA |
| بیشترین انسجام معنایی | BERTopic |
مهمترین ملاحظهی عملیاتی، طول سند است. مدلهای امبدینگ مبتنی بر BERT متن را پس از طول معینی قطع (Truncate) میکنند؛ اما شمارش واژهها در LDA روی هر طولی کار میکند. برای اسنادی که طولشان از پنجرهی زمینهی مدل امبدینگ بیشتر است، یا متن را تکهتکه (Chunk) و سپس تجمیع کنید، یا به سراغ LDA بروید.
کاربرد در عمل
استک سال 2026:
- BERTopic. انتخاب پیشفرض برای متنهای کوتاه و هر مسئلهای که معنا در آن مهم است.
gensim.models.LdaModel. پیادهسازی کلاسیک LDA برای پروداکشن؛ بالغ و امتحانپسداده.sklearn.decomposition.LatentDirichletAllocation. پیادهسازی سادهی LDA برای آزمایش و تجربه.- NMF. تجزیهی ماتریس نامنفی (Non-negative Matrix Factorization)؛ جایگزینی پرسرعت برای LDA با کیفیتی قابلمقایسه روی متنهای کوتاه.
- Top2Vec. رویکردی مشابه با BERTopic، با جامعهی کاربری کوچکتر اما عملکردی خوب در برخی بنچمارکها.
- FASTopic. روشی تازهتر و پرسرعتتر از BERTopic روی مجموعههای متنی بسیار بزرگ.
- برچسبگذاری با LLM. اجرای هر روش خوشهبندی دلخواه و سپس پرامپت دادن به یک مدل برای نامگذاری هر خوشه.
تحویل به پروداکشن
این محتوا را در outputs/skill-topic-picker.md ذخیره کنید:
---
name: topic-picker
description: Pick LDA or BERTopic for a corpus. Specify library, knobs, evaluation.
version: 1.0.0
phase: 5
lesson: 15
tags: [nlp, topic-modeling]
---

Given a corpus description (document count, avg length, domain, language, compute budget), output:

1. Algorithm. LDA / NMF / BERTopic / Top2Vec / FASTopic. One-sentence reason.
2. Configuration. Number of topics: `recommended = max(5, round(sqrt(n_docs)))`, clamped to 200 for corpora under 40,000 docs; permit >200 only when the corpus is genuinely large (>40k) and note the increased compute cost. `min_df` / `max_df` filters and embedding model for neural approaches also belong here.
3. Evaluation. Topic coherence (c_v) via `gensim.models.CoherenceModel`, topic diversity, and a 20-sample human read.
4. Failure mode to probe. For LDA, "junk topics" absorbing stopwords and frequent terms. For BERTopic, the -1 outlier cluster swallowing ambiguous documents.

Refuse BERTopic on documents longer than the embedding model's context window without a chunking strategy. Refuse LDA on very short text (tweets, reviews under 10 tokens) as coherence collapses. Flag any n_topics choice below 5 as likely wrong; flag >200 on corpora under 40k docs as likely over-splitting.تمرینها
- ساده. مدل LDA را با 5 موضوع روی مجموعهی دادهی 20 Newsgroups برازش دهید. 10 کلمهی برتر هر موضوع را چاپ کنید و بهصورت دستی به هر موضوع یک برچسب بدهید. آیا الگوریتم دستهبندیهای واقعی را پیدا کرده است؟
- متوسط. مدل BERTopic را روی همان زیرمجموعهی 20 Newsgroups برازش دهید. تعداد موضوعات پیدا شده، کلمات برتر و انسجام کیفی آنها را با LDA مقایسه کنید. کدام روش دستههای واقعی را تمیزتر تفکیک میکند؟
- سخت. انسجام c_v را برای هر دو روش LDA و BERTopic روی مجموعهی متنی خود محاسبه کنید. هر روش را با 5، 10، 20 و 50 موضوع اجرا کنید. نمودار انسجام برحسب تعداد موضوعات را رسم کنید و گزارش دهید کدام روش در برابر تغییر تعداد موضوعات پایدارتر است.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوهای عامیانه | معنای دقیق فنی |
|---|---|---|
| موضوع (Topic) | چیزی که مجموعهی متنی دربارهی آن است | یک توزیع احتمالاتی روی کلمات (در LDA) یا خوشهای از اسناد مشابه (در BERTopic). |
| عضویت چندگانه (Mixed membership) | سند شامل چند موضوع مختلف است | LDA به هر سند، یک توزیع روی تمام موضوعات اختصاص میدهد. |
| UMAP | کاهش ابعاد | یادگیری خمینه (Manifold learning) با حفظ ساختار محلی؛ استفادهشده در BERTopic. |
| HDBSCAN | خوشهبندی مبتنی بر چگالی | خوشههایی با اندازههای متفاوت پیدا میکند و برچسب «نویز» (1-) برای دادههای پرت میسازد. |
| انسجام c_v (c_v coherence) | معیاری برای ارزیابی کیفیت موضوع | محاسبهی NPMI میان کلمات برتر موضوع در پنجرههای لغزان، تبدیل آنها به بردارهای زمینه و مقایسهی این بردارها با شباهت کسینوسی. |
برای مطالعهی بیشتر
- Blei, Ng, Jordan (2003). Latent Dirichlet Allocation — مقالهی اصلی LDA.
- Grootendorst (2022). BERTopic: Neural topic modeling with a class-based TF-IDF procedure — مقالهی BERTopic.
- Röder, Both, Hinneburg (2015). Exploring the Space of Topic Coherence Measures — مقالهای که c_v و معیارهای مشابه را معرفی کرد.
- مستندات BERTopic — مرجع پروداکشن با مثالهایی فوقالعاده.