
طراحی چتباتی که در مکالمات چندمرحلهای زمینه را حفظ کند، دچار توهم نشود و عملیات واقعی مانند تغییر بلیت یا تراکنش مالی را درست انجام دهد، یکی از چالشهای اصلی سیستمهای مکالمهای است. بسیاری از تیمها تصور میکنند یک پرامپت طولانی برای مدلهای زبانی کافی است، اما در محیط پروداکشن با انحراف از موضوع، توهم و آسیبپذیریهای امنیتی مواجه میشوند.
در این درس سیر تکاملی سیستمهای گفتگو را بررسی میکنیم: از ماشینهای وضعیت مبتنی بر قاعده مثل ELIZA و سیستمهای مبتنی بر بازیابی، تا شبکههای عصبی و ایجنتهای مدرن LLM که میتوانند ابزارها را فراخوانی کنند. در نهایت یاد میگیرید چطور یک معماری مسیریابی هیبریدی پیاده کنید که برای اقدامات حساس از قوانین قطعی و برای پاسخهای پیچیده از ایجنتها بهره میبرد.
بخش عملی این درس بر پایهی کدهای بدون وابستگی سنگین طراحی شده و پیادهسازی گامهای پایهای بدون نیاز به کارت گرافیک خارجی روی CPU قابل اجراست. همچنین برای بخشهای متصل به مدلهای زبانی، در صورت استفاده از APIها میتوانید با رعایت الگوهای امنیتی استاندارد از ارائهدهندگان سازگار بهره ببرید.
ELIZA با تطبیق الگو پاسخ میداد. DialogFlow نیتها را نگاشت میکرد. GPT از روی وزنها جواب میداد. Claude ابزارها را اجرا و راستیآزمایی میکند. هر دوره، فاجعهبارترین نقص دورهی پیش از خود را حل کرد.
صورت مسئله
کاربری میگوید: «میخواهم پروازم را تغییر دهم.» سیستم باید سر دربیاورد کاربر چه میخواهد، چه اطلاعاتی کم است، چطور باید آنها را به دست آورد و چگونه عملیات را نهایی کند. بعد کاربر میگوید: «صبر کن، اگر به جایش کنسل کنم چه؟» و سیستم باید زمینه (Context) گفتگو را به یاد داشته باشد، تسک را عوض کند و وضعیت (State) را حفظ کند.
مکالمه برای یک سیستم یادگیری ماشین (Machine Learning) کار سختی است. ورودی نامحدود و باز است. خروجی باید در نوبتهای متوالی انسجامش را حفظ کند. شاید سیستم لازم باشد روی دنیای واقعی اثر بگذارد (تغییر پرواز، کسر وجه از کارت). در این میان، هر قدم اشتباه جلوی چشم کاربر اتفاق میافتد.
معماری چتباتها چهار پارادایم را پشت سر گذاشته است؛ هر پارادایم از راه رسید چون نسخهی قبلی به شکلی کاملاً مشهود شکست خورد. در این درس، این مسیر را به ترتیب بررسی میکنیم. معماری پروداکشن در سال 2026، ترکیبی از دو پارادایم آخر است.
مفهوم
نیمقرن فیلمنامهنویسی، 1950 تا 2001
پارادایم اول پنج سال دوام نیاورد؛ پنجاه سال ماندگار شد. شناخت این مسیر مهم است، چون تکتک سیستمهای آن دوره عملاً یک ماشین بودند: ورودی را تطبیق بده، یک پاسخ آماده تحویل بده، اندکی وضعیت را بهروزرسانی کن. پنجاه سال قاعدهنویسی روی چنین ماشینی هیچوقت به یک راهکار جامع منجر نشد. همین محدودیت بود که باعث شد پارادایمهای دوم تا چهارم شکل بگیرند.
1950. تورینگ با مطرح کردن یک جایگزین عملیاتی، پرسش «آیا ماشینها میتوانند فکر کنند؟» را دور زد: اگر یک ارزیاب پشت تلهتایپ نتواند تفاوت ماشین را از انسان تشخیص دهد، بحث فلسفی دیگر فایدهای ندارد. مکالمه، پیش از آنکه این حوزه حتی نامی داشته باشد، به بنچمارک اصلی آن تبدیل شد.
1956. این رشته نام پیدا کرد: در یک کارگاه تابستانی در دارتموث، اصطلاح «هوش مصنوعی» (Artificial Intelligence) بر پایهی این حدس شکل گرفت که هر ویژگی هوش «در اصل میتواند آنچنان دقیق توصیف شود که بتوان ماشینی برای شبیهسازی آن ساخت». در پروپوزال اولیه، دو ماه برای پیشرفت چشمگیر زمان در نظر گرفته شده بود.
1966. الایزا (ELIZA) ترفند بازتابی را معرفی کرد؛ همان ترفندی که در گام 1 پیاده میکنید: قواعد تجزیه، تکههایی از ورودی را بیرون میکشند و قواعد بازترکیب، آنها را در قالب پرسش برمیگردانند. در مجموع حدود 200 الگو، بدون هیچ وضعیت داخلی و بدون هیچ درکی؛ با این حال کاربران با آن درددل میکردند. وایزنباوم باقی دوران حرفهای خود را با نگرانی از این گذشت که چقدر سازوکار ساده و محدودی توانسته بود توجه مردم را جلب کند.
1972. پَری (PARRY) در استنفورد برای مدلسازی پارانویا ساخته شد و قطعهای را که ELIZA کم داشت اضافه کرد: وضعیت داخلی. متغیرهای عددی برای ترس، خشم و بیاعتمادی در هر نوبت بهروزرسانی میشدند و تعیین میکردند کدام اسکریپت اجرا شود؛ در نتیجه ورودیهای یکسان، بسته به روند گفتگوی قبلی، پاسخهای متفاوتی تولید میکردند. در یک آزمایش کور با بررسی متن گفتگوها، دقت روانپزشکان در تشخیص PARRY از بیماران واقعی در حد حدس تصادفی بود. این سیستم، جد مستقیم شرطیسازی پرسوناست؛ یعنی یک پرامپت (Prompt) سیستمی که در قالب سه متغیر اعشاری (Float) پیاده شده بود. در همان سال، این دو بات روی آرپانت (ARPANET) روبهروی هم قرار گرفتند: اسکریپت یک رواندرمانگر در حال مصاحبه با ماشین وضعیت یک پارانوئید؛ نخستین گفتگوی بات با بات روی یک شبکه.
1995. آلیس (ALICE) فرمول ELIZA را با استفاده از AIML مقیاسپذیر کرد؛ زبانی بر پایهی XML برای جفتهای الگو-قالب. حدود 40,000 دستهبندی دستنویس و سه بار برندهی جایزهی لوبنر (Loebner Prize). این سیستم قانون مقیاسپذیری سیستمهای مبتنی بر قاعده را اثبات کرد: قواعد بیشتر، پوشش را بالا میبرد اما هرگز به عمومیتیافتگی منجر نمیشود. هر قاعدهی جدید، تعهدی است که یک نفر باید از آن نگهداری کند.
2001. اسمارتچایلد (SmarterChild) این فرمول را در اختیار 30 میلیون کاربر پیامرسان قرار داد و جستجوهای بکاند (آبوهوا، بورس، سانس فیلمهای سینما) را درون قالبها تزریق کرد. اگر دقیق نگاه کنید، این همان فراخوانی ابزار (Tool Calling) است که لباس سال 2001 را پوشیده: نیت را تجزیه کن، یک سرویس را فراخوانی کن، نتیجه را درون پاسخ رندر کن.
پنجاه سال، یک سازوکار و تعداد روزافزون قوانین. این پارادایم نه به این دلیل که کسی نادرستیاش را اثبات کرد، بلکه به این خاطر کنار رفت که هزینهی نگهداری ماشینهای وضعیت دستنویس با گسترش پوشش به صورت خطی رشد میکرد؛ در حالی که توقعات کاربران متناسب با چیزهایی بالا میرفت که همین هفتهی پیش دیده بودند.
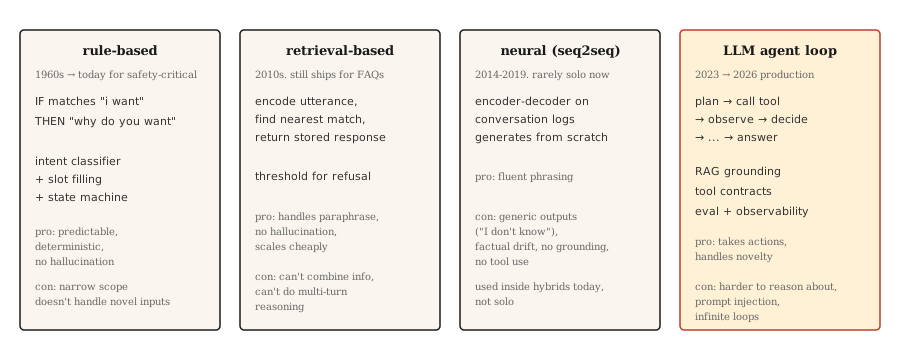
مبتنی بر قاعده (ELIZA، AIML، DialogFlow). الگوهای دستنویس ورودی کاربر را تطبیق میدهند و پاسخ تولید میکنند. دستهبندهای نیت مسیر را به جریانهای از پیش تعریفشده هدایت میکنند. ماشینهای وضعیت پر کردن فیلد (Slot-Filling) اطلاعات لازم را جمعآوری میکنند. در دامنهی محدود تعریفشدهاش فوقالعاده کار میکند، اما خارج از آن بلافاصله شکست میخورد. هنوز هم در حوزههای حساس (احراز هویت بانکی، رزرو پرواز) که در آنها توهم (Hallucination) مطلقاً قابلتحمل نیست استفاده میشود.
بازیابیمحور (Retrieval-based). سیستمی شبیه به پایگاه دانش سوالات متداول (FAQ). تمام جفتهای (عبارت، پاسخ) را انکود و ذخیره کنید. در زمان اجرا (Runtime)، پیام کاربر را انکود کرده و نزدیکترین پاسخ ذخیرهشده را بازیابی کنید؛ درست شبیه ویژگی کلاسیک «مقالات مشابه» در Zendesk. بازنویسیها را بهتر از سیستمهای مبتنی بر قاعده مدیریت میکند. تولید متنی در کار نیست، پس توهمی هم رخ نمیدهد.
عصبی (seq2seq). مدلهای انکودر-دیکودر (Encoder-Decoder) که روی تاریخچهی گفتگوها آموزش دیدهاند. پاسخها را از صفر تولید میکنند. روان صحبت میکنند اما مستعد پاسخهای کلیشهای و مبهم («نمیدانم») و انحراف فکتها هستند؛ هیچوقت هم با اطمینان روی موضوع اصلی نمیمانند. دلیل اینکه باتهای گوگل، فیسبوک و مایکروسافت در سالهای 2016 تا 2019 ناامیدکننده از آب درآمدند همین بود.
ایجنتهای LLM. یک مدل زبانی بزرگ پیچیده درون حلقهای که برنامهریزی میکند، ابزارها را فرا میخواند و نتایج را ارزیابی میکند. این یک چتبات با یک پرامپت طولانی نیست؛ بلکه یک حلقهی ایجنت (Agent Loop) است: برنامهریزی کن ← ابزار را فراخوانی کن ← نتیجه را ببین ← قدم بعدی را مشخص کن. اتکای بازیابیمحور (RAG) جلوی توهم را میگیرد. فراخوانی ابزارها به آن امکان میدهد کارهای واقعی انجام دهد. معماری سال 2026 این است.
این چهار پارادایم جایگزینهای مرحلهبهمرحله نیستند. یک چتبات پروداکشن در سال 2026 درخواست را از میان هر چهار پارادایم هدایت میکند: مبتنی بر قاعده برای احراز هویت و اقدامات حساس، بازیابی برای سوالات پرتکرار، تولید عصبی برای لحن طبیعی گفتگو، و ایجنت برای پرسشهای مبهم و باز.
پیادهسازی
گام 1: تطبیق الگوی مبتنی بر قاعده
import re


class RulePattern:
    def __init__(self, pattern, response_template):
        self.regex = re.compile(pattern, re.IGNORECASE)
        self.template = response_template


PATTERNS = [
    RulePattern(r"my name is (\w+)", "Nice to meet you, {0}."),
    RulePattern(r"i (need|want) (.+)", "Why do you {0} {1}?"),
    RulePattern(r"i feel (.+)", "Why do you feel {0}?"),
    RulePattern(r"(.*)", "Tell me more about that."),
]


def rule_based_respond(user_input):
    for pattern in PATTERNS:
        m = pattern.regex.match(user_input.strip())
        if m:
            return pattern.template.format(*m.groups())
    return "I don't understand."
سیستم ELIZA در 20 خط. ترفند بازتاب («من غمگینم» ← «چرا احساس غمگینی میکنی؟») همان دموی معروف رواندرمانگر وایزنباوم در سال 1966 است. هنوز هم آموزنده است.
گام 2: بازیابیمحور (FAQ)
این تکه کد نیازمند pip install sentence-transformers است (که torch را هم نصب میکند). فایل اجرایی code/main.py در این درس از شباهت ژاکارد (Jaccard similarity) کتابخانهی استاندارد استفاده میکند تا بدون وابستگی خارجی اجرا شود.
from sentence_transformers import SentenceTransformer
import numpy as np


FAQ = [
    ("how do i reset my password", "Go to Settings > Security > Reset Password."),
    ("how do i cancel my order", "Go to Orders, find the order, click Cancel."),
    ("what is your return policy", "30-day returns on unused items, original packaging."),
]


encoder = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
faq_questions = [q for q, _ in FAQ]
faq_embeddings = encoder.encode(faq_questions, normalize_embeddings=True)


def faq_respond(user_input, threshold=0.5):
    q_emb = encoder.encode([user_input], normalize_embeddings=True)[0]
    sims = faq_embeddings @ q_emb
    best = int(np.argmax(sims))
    if sims[best] < threshold:
        return None
    return FAQ[best][1]
رد پاسخ بر اساس آستانه (Threshold)، تصمیم کلیدی در طراحی است. اگر بهترین تطابق بهاندازهی کافی نزدیک نبود، مقدار None برگردانید و بگذارید سیستم کار را به سطوح بالاتر ارجاع دهد.
گام 3: تولید عصبی (Baseline)
از یک انکودر-دیکودر کوچک با تیونینگ دستوری (FLAN-T5) یا یک مدل مکالمهای فاینتیونشده استفاده کنید. این مدلها به تنهایی در سال 2026 برای پروداکشن غیرقابل استفادهاند (تناقضگویی، انحراف از بحث، ادعاهای غیرواقعی)، اما در سیستمهای هیبریدی برای لحن طبیعی عبارات به کار میروند. مدلهای صرفاً دیکودر شبیه به DialoGPT برای تولید پاسخهای منسجم نیازمند جداکنندههای صریح نوبت و مدیریت پایان متن (EOS) هستند؛ اما یک پایپلاین text2text در FLAN-T5 برای یک مثال آموزشی بیدردسر کار میکند.
from transformers import pipeline

chatbot = pipeline("text2text-generation", model="google/flan-t5-small")

response = chatbot("Respond politely to: Hi there!", max_new_tokens=40)
print(response[0]["generated_text"])
گام 4: حلقهی ایجنت LLM
ساختار پروداکشن سال 2026:
def agent_loop(user_message, tools, llm, max_steps=5):
    history = [{"role": "user", "content": user_message}]
    for _ in range(max_steps):
        response = llm(history, tools=tools)
        tool_call = response.get("tool_call")
        if tool_call:
            tool_name = tool_call.get("name")
            args = tool_call.get("arguments")
            if not isinstance(tool_name, str) or tool_name not in tools:
                history.append({"role": "assistant", "tool_call": tool_call})
                history.append({"role": "tool", "name": str(tool_name), "content": f"error: unknown tool {tool_name!r}"})
                continue
            if not isinstance(args, dict):
                history.append({"role": "assistant", "tool_call": tool_call})
                history.append({"role": "tool", "name": tool_name, "content": f"error: arguments must be a dict, got {type(args).__name__}"})
                continue
            fn = tools[tool_name]
            result = fn(**args)
            history.append({"role": "assistant", "tool_call": tool_call})
            history.append({"role": "tool", "name": tool_name, "content": result})
        else:
            return response["content"]
    return "I could not complete the task in the step budget."
سه نکتهی مهم: ابزارها توابع قابلاجرایی هستند که LLM میتواند آنها را فراخوانی کند. حلقه زمانی متوقف میشود که مدل به جای فراخوانی ابزار، پاسخ نهایی را برگرداند. سقف مراحل (Step budget)، از ایجاد حلقههای بیپایان در وظایف مبهم جلوگیری میکند.
در پروداکشن واقعی این بخشها نیز اضافه میشوند: اتکای بازیابیمحور (تزریق اسناد مرتبط پیش از هر بار فراخوانی LLM)، گاردریلها (رد اقدامات مخرب بدون تأیید کاربر)، مشاهدهپذیری (لاگ کردن تکتک مراحل) و ارزیابیها (بررسیهای خودکار برای اطمینان از مطابقت رفتار ایجنت با مشخصات تعیینشده).
گام 5: مسیریابی ترکیبی (Hybrid Routing)
def hybrid_chat(user_input):
    if is_destructive_action(user_input):
        return structured_flow(user_input)

    faq_answer = faq_respond(user_input, threshold=0.6)
    if faq_answer:
        return faq_answer

    return agent_loop(user_input, tools, llm)


def is_destructive_action(text):
    danger_words = ["delete", "cancel", "charge", "refund", "transfer"]
    return any(w in text.lower() for w in danger_words)
الگو مشخص است: قوانین قطعی برای هر اقدام مخرب، بازیابی برای پاسخهای آمادهی سوالات متداول، و ایجنتهای LLM برای بقیهی موارد. این همان چیزی است که در سال 2026 روی سیستمهای پشتیبانی مشتری مستقر است.
کاربردها
استک سال 2026:
| مورد استفاده | معماری |
|---|---|
| رزرو، پرداخت، احراز هویت | ماشینهای وضعیت مبتنی بر قاعده + پر کردن فیلد |
| سوالات متداول پشتیبانی | بازیابی از میان پاسخهای دستچینشده |
| چت راهنمای باز و عمومی | ایجنت LLM همراه با RAG و فراخوانی ابزار |
| ابزارهای داخلی / دستیار محیط توسعه | ایجنت LLM همراه با فراخوانی ابزار (جستجو، خواندن، نوشتن) |
| باتهای همدم / شخصیتمحور | مدل تیونشده با پرامپت سیستمی تعیین پرسنوا و بازیابی دانش |
در پروداکشن همیشه از مسیریابی ترکیبی استفاده کنید. هیچ معماری واحدی همهی درخواستها را بهخوبی مدیریت نمیکند. لایهی مسیریابی معمولاً یک دستهبند نیت سبک است.
الگوهای نقصی که هنوز در پروداکشن دیده میشوند
-
توهم با اعتمادبهنفس بالا. ایجنت ادعا میکند کاری را انجام داده، در حالی که انجام نداده است. راهکار: راستیآزمایی خروجیها، لاگ کردن فراخوانی ابزارها، و جلوگیری از ادعای انجام کار توسط LLM بدون بازگشت موفق از سوی ابزار.
-
تزریق پرامپت (Prompt Injection). کاربر متنی وارد میکند که پرامپت سیستم را نادیده میگیرد و بازنویسی میکند. این نقص، رتبه LLM01 را در فهرست OWASP Top 10 برنامههای LLM در سال 2025 به خود اختصاص داده است. دو نوع دارد: تزریق مستقیم (متنی که در چت Paste میشود) و تزریق غیرمستقیم (پنهانشده در اسناد، ایمیلها یا خروجی ابزارهایی که ایجنت میخواند).
نرخ حملات بر اساس سناریو تغییر میکند. نرخ موفقیت اندازهگیریشده در بنچمارکهای عمومی ابزارخوانی و کدنویسی روی مدلهای پیشرو بین ~0.5 تا 8.5 درصد متغیر است. در سناریوهای پرخطر خاص (حملات تطبیقی علیه ایجنتهای کدنویسی، ارکستراسیون آسیبپذیر) این عدد به ~84 درصد هم رسیده است. از CVEهای محیط واقعی میتوان به EchoLeak اشاره کرد (CVE-2025-32711 با نمرهی CVSS 9.3)؛ نقص امنیتی خروج اطلاعات بدون نیاز به کلیک در Microsoft 365 Copilot که از طریق یک ایمیل تحت کنترل مهاجم فعال میشد.
راهکارها: با ورودی کاربر در سرتاسر حلقه مثل دادهی غیرقابل اعتماد رفتار کنید؛ قبل از فراخوانی ابزار، ورودیها را پاکسازی کنید؛ خروجی ابزارها را از پرامپت اصلی جدا نگهدارید؛ از الگوی «برنامهریزی، راستیآزمایی، اجرا» (PVE) استفاده کنید که در آن ایجنت اول برنامهریزی میکند و سپس پیش از اجرا، هر اقدام را با برنامه میسنجد (این کار مانع از اجرای دستورات جدیدِ تزریقشده از خروجی ابزارها میشود)؛ برای اقدامات مخرب، تأیید کاربر را الزامی کنید؛ اصل حداقل دسترسی را روی دامنهی اختیارات ابزارها پیاده کنید.
هیچ پرامپتنویسی محتاطانهای این خطر را بهطور کامل از بین نمیبرد. لایههای دفاعی مجزا در زمان اجرا (مثل LLM Guard، اعتبارسنجی بر اساس لیست مجاز، و تشخیص ناهنجاری معنایی) الزامی هستند.
-
خزش دامنه (Scope Creep). ایجنت به دلیل دریافت اطلاعات جانبی از خروجی یک ابزار، از مسیر وظیفهی اصلی منحرف میشود. راهکار: محدودسازی دقیق تعاریف ورودی و خروجی ابزارها، متمرکز نگهداشتن پرامپت سیستم، و سنجش مداوم نرخ انحراف از هدف.
-
حلقههای بیپایان. ایجنت مرتباً همان ابزار را فراخوانی میکند. راهکار: سقف مراحل، حذف درخواستهای تکراری ابزارها، و استفاده از قضاوت مدل زبانی روی این پرسش که «آیا پیشرفتی حاصل شده یا نه».
-
سرریز پنجرهی زمینه. مکالمات طولانی، پیامهای ابتدایی را از پنجرهی زمینه بیرون میرانند. راهکار: خلاصهسازی پیامهای قدیمیتر، بازیابی پیامهای قبلیِ مرتبط از طریق شباهت، یا استفاده از مدلهایی با پنجرهی زمینهی طولانی.
ذخیرهی خروجی
محتوای زیر را در فایل outputs/skill-chatbot-architect.md ذخیره کنید:
---
name: chatbot-architect
description: Design a chatbot stack for a given use case.
version: 1.0.0
phase: 5
lesson: 17
tags: [nlp, agents, chatbot]
---

Given a product context (user need, compliance constraints, available tools, data volume), output:

1. Architecture. Rule-based, retrieval, neural, LLM agent, or hybrid (specify which paths go where).
2. LLM choice if applicable. Name the model family (Claude, GPT-4, Llama-3.1, Mixtral). Match to tool-use quality and cost.
3. Grounding strategy. RAG sources, retrieval method (see lesson 14), tool contracts.
4. Evaluation plan. Task success rate, tool-call correctness, off-task rate, hallucination rate on held-out dialogs.

Refuse to recommend a pure-LLM agent for any destructive action (payments, account deletion, data modification) without a structured confirmation flow. Refuse to skip the prompt-injection audit if the agent has write access to anything.تمرینها
- ساده. تابع پاسخدهی مبتنی بر قاعدهی بالا را با 10 الگو برای بات سفارش کافه پیادهسازی کنید. حالتهای خاص را بیازمایید: سفارش دوبل، تغییر سفارش، لغو سفارش و نیت نامشخص.
- متوسط. یک سیستم هیبریدی متشکل از پایگاه دانش و مدل پشتیبان (Fallback) بسازید. 50 سوال و جواب آماده برای یک محصول SaaS بسازید و مدل پشتیبان را با بازیابی روی سایت مستندات متصل کنید. نرخ پاسخ ندادن و دقت را روی 100 سوال پشتیبانی واقعی بسنجید.
- دشوار. حلقهی ایجنت بالا را با سه ابزار پیادهسازی کنید (جستجو، خواندن دادهی کاربر، ارسال ایمیل). یک تست ارزیابی با 50 سناریوی مختلف، شامل تلاشهایی برای تزریق پرامپت، اجرا کنید. نرخ انحراف از تسک، نرخ تسکهای ناموفق و هرگونه موفقیت در تزریق را گزارش دهید.
اصطلاحات کلیدی
| اصطلاح | معنای رایج | معنای دقیق فنی |
|---|---|---|
| نیت (Intent) | کاربر چه میخواهد | برچسب دستهبندیشده (مانند book_flight یا reset_password) که به یک کنترلکننده هدایت میشود. |
| فیلد (Slot) | یک بخش از اطلاعات | پارامتری که بات به آن نیاز دارد (مانند تاریخ یا مقصد). فرآیند پر کردن فیلد زنجیرهای از درخواستهای پیدرپی است. |
| RAG | بازیابی به همراه تولید متن | بازیابی اسناد مرتبط و سپس استناد دادن پاسخهای LLM به آنها. |
| فراخوانی ابزار (Tool call) | اجرای تابع | مدل یک درخواست ساختیافته حاوی نام تابع و آرگومانها صادر میکند. محیط اجرا آن را اجرا کرده و نتیجه را برمیگرداند. |
| حلقهی ایجنت (Agent loop) | برنامهریزی، اقدام، راستیآزمایی | کنترلکنندهای که فراخوانیهای LLM و ابزارها را تا زمان تکمیل تسک به صورت متناوب مدیریت میکند. |
| تزریق پرامپت (Prompt injection) | حمله کاربر به پرامپت | ورودی مخربی که تلاش میکند پرامپت سیستم را نادیده بگیرد و کنترل مدل را در دست بگیرد. |
برای مطالعهی بیشتر
- تورینگ (1950). Computing Machinery and Intelligence — مقالهای که مکالمه را به بنچمارک استاندارد این حوزه تبدیل کرد.
- وایزنباوم (1966). ELIZA — A Computer Program For the Study of Natural Language Communication — مقالهی اصلی چتباتهای مبتنی بر قاعده.
- کولبی، وبر و هیلف (1971). Artificial Paranoia — معماری متغیرهای حالت روحی در PARRY، نخستین چتبات دارای وضعیت.
- توپیلان و دیگران (2022). LaMDA: Language Models for Dialog Applications — مقالهی مهم گوگل دربارهی چتباتهای عصبی، درست پیش از فراگیر شدن ایجنتهای LLM.
- یائو و دیگران (2022). ReAct: Synergizing Reasoning and Acting in Language Models — مقالهای که نام الگوی حلقهی ایجنت را مطرح کرد.
- راهنمای Anthropic دربارهی ساخت ایجنتهای کارآمد — راهنمای پروداکشن سال 2024 که در سال 2026 همچنان معتبر است.
- گرشاکه و دیگران (2023). Not what you've signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection — مقالهی مرجع دربارهی تزریق غیرمستقیم پرامپت.
- فهرست OWASP Top 10 برای برنامههای کاربردی LLM سال 2025 — بخش LLM01 Prompt Injection — رتبهبندیای که تزریق پرامپت را به دغدغهی امنیتی شماره یک تبدیل کرد.
- راهنمای AWS — ایمنسازی ایجنتهای Amazon Bedrock در برابر تزریق غیرمستقیم پرامپت — دفاعهای کاربردی در لایهی ارکستراسیون از جمله PVE و جریانهای تأیید کاربر.
- اکولیک (CVE-2025-32711) — نمونهی استاندارد آسیبپذیری نشت دادهها بدون کلیک ناشی از تزریق غیرمستقیم پرامپت؛ نمونهای مرجع که نشان میدهد چرا ایجنتهای دارای دسترسی نوشتن به لایههای دفاعی در زمان اجرا نیاز دارند.