
معیارهای سنتی ارزیابی متن مانند تطابق دقیق (Exact Match) یا F1-Score تفاوتهای ظریف معنایی را تشخیص نمیدهند و بررسی دستی توسط انسان نیز در ابعاد بزرگ ناممکن است. استفاده از مدل زبانی در نقش داور (LLM-as-judge) راهحل استاندارد برای سیستمهای تولید مبتنی بر بازیابی (RAG) به شمار میرود، اما در صورت عدم کالیبراسیون و شناخت سوگیریها، آمارهای گمراهکنندهای تولید میکند.
در توسعهی کاربردی سیستمهای هوش مصنوعی، فریمورکهایی مانند RAGAS و DeepEval فرآیند سنجش دقت زمینه، وفاداری و سنجههای سفارشی را خودکار میکنند و اجازه میدهند ارزیابی کیفی به بخشی از خط لولهی آزمون مداوم (CI/CD) تبدیل شود.
برای اجرای تستها در مقیاس بالا با سرویسهای ابری خارجی، محدودیتهای پرداخت ارزی یا عدم پایداری ترافیک بینالملل ممکن است چالشبرانگیز باشد. با این حال، استفاده از مدلهای سبک یا گیتویهای سازگار با APIهای استاندارد، ارزیابی خودکار خطوط لولهی RAG را در محیطهای محلی و توسعه کاملاً امکانپذیر میکند.
معیارهای تطابق دقیق (Exact-match) و امتیاز F1 شباهتهای معنایی را نادیده میگیرند. بازبینی انسانی هم مقیاسپذیر نیست. استفاده از مدل زبانی در نقش داور (LLM-as-judge) راهحل پروداکشن است؛ البته به شرطی که آنقدر کالیبره شده باشد که بتوانید به اعدادش اعتماد کنید.
صورت مسئله
سیستم RAG شما این پاسخ را میدهد: "June 29th, 2007." پاسخ مرجع طلایی (Gold reference) این است: "June 29, 2007." معیار تطابق دقیق امتیاز 0 میدهد؛ امتیاز F1 حدود 75% میشود؛ اما یک انسان به آن امتیاز 100% میدهد.
حالا این وضعیت را در 10,000 نمونهی آزمایشی ضرب کنید. دوباره آن را در تکتک تغییرات سیستم بازیابی (Retriever)، قطعهبندی متون (Chunking)، پرامپت یا خود مدل ضرب کنید. شما به ارزیابیکنندهای نیاز دارید که معنا را بفهمد، در مقیاس بالا با هزینهای اندک اجرا شود، افتهای عملکرد (Regression) را لاپوشانی نکند و حالتهای شکست را درست و دقیق نشان دهد.
در سال 2026، سه فریمورک طلایهدار حل این مسئله هستند:
- RAGAS. مخفف Retrieval-Augmented Generation ASsessment. چهار معیار RAG (وفاداری، مرتبط بودن پاسخ، دقت زمینه و بازخوانی زمینه) را با موتور استنتاج زبان طبیعی (NLI) و داوری LLM ارزیابی میکند. با پشتوانهی پژوهشی و بسیار سبک.
- DeepEval. ابزاری معادل pytest برای مدلهای زبانی. دارای معیارهای G-Eval، انجام وظیفه (Task-completion)، توهم (Hallucination) و سوگیری (Bias). کاملاً سازگار با CI/CD.
- G-Eval. هم یک متد است و هم یک معیار در DeepEval: داوری با مدل زبانی همراه با زنجیرهی تفکر (Chain-of-thought)، معیارهای اختصاصی و امتیاز 0 تا 1.
هر سه ابزار بر داوری LLM متکی هستند. این درس درک شهودی از این متد و لایهی اعتمادسازی پیرامون آن را برایتان میسازد.
مفاهیم پایه
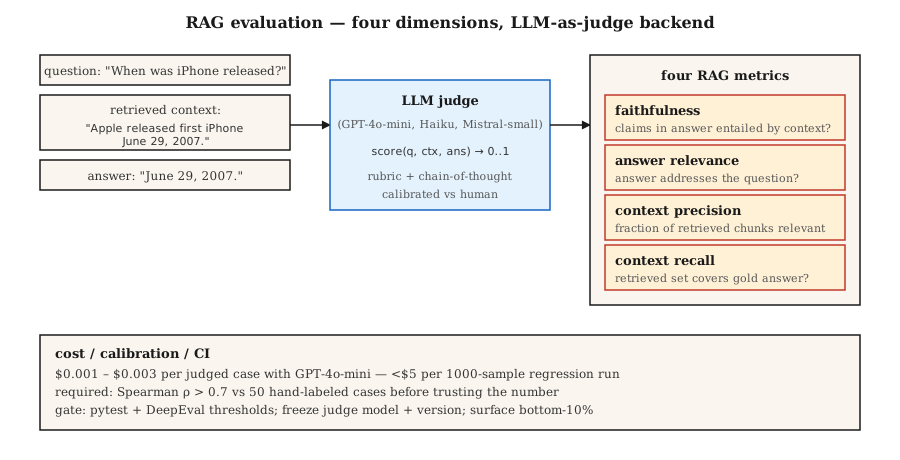
مدل زبانی در نقش داور (LLM-as-judge). جایگزین کردن یک معیار ثابت با یک مدل زبانی که خروجیها را بر اساس یک شیوهنامهی نمرهدهی (Rubric) میسنجد. با ورودی (query, context, answer)، به مدل داور پرامپت میدهید: «میزان وفاداری را با امتیازی بین 0 تا 1 بسنج.» و مدل امتیاز را برمیگرداند.
چرا کار میکند: مدلهای زبانی قضاوت انسانی را با کسری ناچیز از هزینهی آن شبیهسازی میکنند. مدل GPT-4o-mini با هزینهی حدود 0.003$ به ازای هر نمونه، اجرای تستهای رگرسیون روی 1000 نمونه را با هزینهای زیر 5$ ممکن میکند.
چرا بیصدا به مشکل میخورد:
- سوگیری داور (Judge bias). داورها پاسخهای طولانیتر، پاسخهای مدلهای همخانوادهی خودشان و پاسخهای هماهنگ با سبک پرامپت را ترجیح میدهند.
- خطای پارس کردن JSON. ساختار نامعتبر JSON خروجی را به نمرهی NaN تبدیل میکند و نمونه بیصدا از میانگین کل کنار گذاشته میشود. کاربران RAGAS خوب این درد را میشناسند. با try/except و ثبت شفاف حالت شکست جلویش را بگیرید.
- تغییر رفتار با نسخههای جدید مدل (Drift). ارتقای نسخهی مدل داور، تمام متریکها را دگرگون میکند. مدل داور و نسخهی دقیق آن را قفل (Freeze) کنید.
چهارگانهی RAG.
| معیار | پرسش | موتور پشت صحنه |
|---|---|---|
| وفاداری (Faithfulness) | آیا تکتک ادعاهای پاسخ از دل زمینهی بازیابیشده برآمدهاند؟ | استلزام مبتنی بر NLI |
| مرتبط بودن پاسخ (Answer relevance) | آیا پاسخ واقعاً به پرسشِ مطرحشده میپردازد؟ | تولید پرسشهای فرضی بر اساس پاسخ و مقایسهی آنها با پرسش اصلی |
| دقت زمینه (Context precision) | چند درصد از چانکهای بازیابیشده واقعاً مرتبط بودند؟ | داوری با مدل زبانی |
| بازخوانی زمینه (Context recall) | آیا سیستم همهی دادههای لازم را بازیابی کرده است؟ | داوری با مدل زبانی در برابر پاسخ مرجع طلایی |
G-Eval. یک معیار سفارشی تعریف کنید: «آیا در پاسخ به منبع درست استناد شده است؟» فریمورک بهطور خودکار آن را به گامهای ارزیابی مبتنی بر زنجیرهی تفکر بسط میدهد و امتیازی بین 0 تا 1 تعیین میکند. عالی برای ابعاد کیفی مختص دامنه که RAGAS نمیپوشاند.
کالیبراسیون (Calibration). تا زمانی که همبستگی نمرات داور را با برچسبهای انسانی نسنجیدهاید، هرگز به عدد خام اعتماد نکنید. 100 نمونه را دستی برچسبگذاری کنید. نمودار داور در برابر انسان را رسم کنید. ضریب همبستگی اسپیرمن (Spearman rho) را به دست آورید. اگر مقدار rho کمتر از 0.7 باشد، شیوهنامهی نمرهدهی داورتان جای کار دارد.
پیادهسازی
گام 1: وفاداری با NLI (به سبک RAGAS)
from typing import Callable
from transformers import pipeline

nli = pipeline("text-classification",
               model="MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli",
               top_k=None)

# `llm` هر موجودیت قابل فراخوانی است: prompt str -> generated str.
# Example: llm = lambda p: client.messages.create(model="claude-haiku-4-5", ...).content[0].text
LLM = Callable[[str], str]


def atomic_claims(answer: str, llm: LLM) -> list[str]:
    prompt = f"""Break this answer into simple factual claims (one per line):
{answer}
"""
    return llm(prompt).splitlines()


def faithfulness(answer: str, context: str, llm: LLM) -> float:
    claims = atomic_claims(answer, llm)
    if not claims:
        return 0.0
    supported = 0
    for claim in claims:
        result = nli({"text": context, "text_pair": claim})[0]
        entail = next((s for s in result if s["label"] == "entailment"), None)
        if entail and entail["score"] > 0.5:
            supported += 1
    return supported / len(claims)
پاسخ را به ادعاهای اتمی تجزیه کنید. هر ادعا را با روش NLI در برابر زمینهی بازیابیشده اعتبارسنجی کنید. وفاداری برابر است با نسبت ادعاهای تاییدشده به کل ادعاها.
گام 2: مرتبط بودن پاسخ
import numpy as np
from sentence_transformers import SentenceTransformer

# encoder: any model implementing .encode(texts, normalize_embeddings=True) -> ndarray
# e.g., encoder = SentenceTransformer("BAAI/bge-small-en-v1.5")

def answer_relevance(question: str, answer: str, encoder, llm: LLM, n: int = 3) -> float:
    prompt = f"Write {n} questions this answer could be the answer to:\n{answer}"
    generated = [line for line in llm(prompt).splitlines() if line.strip()][:n]
    if not generated:
        return 0.0
    q_emb = np.asarray(encoder.encode([question], normalize_embeddings=True)[0])
    g_embs = np.asarray(encoder.encode(generated, normalize_embeddings=True))
    sims = [float(q_emb @ g_emb) for g_emb in g_embs]
    return sum(sims) / len(sims)
اگر از پاسخ بتوان پرسشهایی متفاوت از پرسش اصلی استنباط کرد، میزان مرتبط بودن افت میکند.
گام 3: معیار سفارشی با G-Eval
from deepeval.metrics import GEval
from deepeval.test_case import LLMTestCaseParams, LLMTestCase

metric = GEval(
    name="Correctness",
    criteria="The answer should be factually accurate and match the expected output.",
    evaluation_steps=[
        "Read the expected output.",
        "Read the actual output.",
        "List factual claims in the actual output.",
        "For each claim, mark supported or unsupported by the expected output.",
        "Return score = fraction supported.",
    ],
    evaluation_params=[LLMTestCaseParams.INPUT, LLMTestCaseParams.ACTUAL_OUTPUT, LLMTestCaseParams.EXPECTED_OUTPUT],
)

test = LLMTestCase(input="When was the first iPhone released?",
                   actual_output="June 29th, 2007.",
                   expected_output="June 29, 2007.")
metric.measure(test)
print(metric.score, metric.reason)
مراحل ارزیابی همان شیوهنامهی نمرهدهی هستند. مراحل مشخص و شفاف بسیار پایدارتر از پرامپتهای ضمنی مثل «امتیازی بین 0 تا 1 بده» جواب میدهند.
گام 4: گیت CI
import deepeval
from deepeval.metrics import FaithfulnessMetric, ContextualRelevancyMetric


def test_rag_system():
    cases = load_regression_cases()
    faith = FaithfulnessMetric(threshold=0.85)
    rel = ContextualRelevancyMetric(threshold=0.7)
    for case in cases:
        faith.measure(case)
        assert faith.score >= 0.85, f"faithfulness regression on {case.id}"
        rel.measure(case)
        assert rel.score >= 0.7, f"relevancy regression on {case.id}"
کد را در قالب یک فایل pytest تحویل دهید. آن را در هر PR اجرا کنید. جلوی merge شدن تغییراتی را که باعث پسرفت عملکرد میشوند بگیرید.
گام 5: ارزیابی ساده از صفر
فایل code/main.py را ببینید. در آنجا وفاداری (همپوشانی ادعاهای پاسخ با زمینه) و مرتبط بودن (همپوشانی توکنهای پاسخ با توکنهای پرسش) صرفاً با کتابخانههای استاندارد پایتون پیاده شدهاند. برای پروداکشن نیست؛ فقط شکل کلی کار را نشان میدهد.
دامهای رایج
- کالیبره نکردن. داوری با همبستگی 0.3 نسبت به برچسبهای انسانی، عملاً نوفه (Noise) و دادهی پرت است. پیش از انتشار حتماً یک دور کالیبراسیون الزامی کنید.
- خودارزیابی (Self-evaluation). استفاده از یک مدل برای تولید پاسخ و داوری، امتیازها را بین 10 تا 20 درصد بهطور کاذب بالا میبرد. برای داوری از خانوادهی متفاوتی از مدلها استفاده کنید.
- سوگیری موقعیت در ارزیابی جفتی (Pairwise). داورها گزینهی اول ارائهشده را ترجیح میدهند. همیشه ترتیب را تصادفی کنید و هر دو حالت را بسنجید.
- پنهان ماندن شکستها در میانگین نهایی. میانگین نمرهی 0.85 معمولاً 5% شکست فاجعهبار را پنهان میکند. همیشه چندک پایینی (Bottom quantile) را موشکافی کنید.
- فرسودگی مجموعهدادهی مرجع (Golden dataset rot). مجموعهدادههای ارزیابی بدون نسخهبندی که با گذشت زمان تغییر میکنند، امکان مقایسهی طولی را از بین میبرند. با هر تغییر، دیتاست را تگ بزنید.
- هزینهی بالای مدل زبانی. در مقیاسهای بزرگ، فراخوانیهای مکرر داور بیشترین سهم هزینه را دارند. ارزانترین مدلی را انتخاب کنید که آستانهی کالیبراسیون را پاس کند: GPT-4o-mini، Claude Haiku یا Mistral-small.
استفادهی عملی
استک ابزارها در سال 2026:
| مورد کاربرد | فریمورک |
|---|---|
| پایش کیفیت RAG | RAGAS (4 معیار اصلی) |
| گیتهای سنجش رگرسیون در CI/CD | DeepEval + pytest |
| معیارهای سفارشی دامنه | G-Eval درون DeepEval |
| پایش آنلاین ترافیک زنده | RAGAS در حالت بدون پاسخ مرجع (Reference-free) |
| بررسیهای تصادفی با ناظر انسانی | LangSmith یا Phoenix با رابط کاربری برچسبگذاری |
| تست تیم قرمز و ارزیابی ایمنی (Red-teaming) | Promptfoo + DeepEval |
استک متداول: RAGAS برای پایش، DeepEval برای CI و G-Eval برای ابعاد ناشناخته و جدید. هر سه را اجرا کنید؛ اختلاف نظرهایشان بسیار آموزنده و کاراست.
انتشار خروجی
فایل را در مسیر outputs/skill-eval-architect.md ذخیره کنید:
---
name: eval-architect
description: Design an LLM evaluation plan with calibrated judge and CI gates.
version: 1.0.0
phase: 5
lesson: 27
tags: [nlp, evaluation, rag]
---

Given a use case (RAG / agent / generative task), output:

1. Metrics. Faithfulness / relevance / context-precision / context-recall + any custom G-Eval metrics with criteria.
2. Judge model. Named model + version, rationale for cost vs accuracy.
3. Calibration. Hand-labeled set size, target Spearman rho vs human > 0.7.
4. Dataset versioning. Tag strategy, change log, stratification.
5. CI gate. Thresholds per metric, regression-window logic, bottom-quantile alert.

Refuse to rely on a judge untested against ≥50 human-labeled examples. Refuse self-evaluation (same model generates + judges). Refuse aggregate-only reporting without bottom-10% surfacing. Flag any pipeline where judge upgrade lands without parallel baseline eval.تمرینها
- ساده. ابزار RAGAS را روی 10 نمونهی RAG با توهمهای شناختهشده اجرا کنید. بررسی کنید که آیا معیار وفاداری تکتک آنها را شکار میکند یا نه.
- متوسط. 50 پاسخ پرسشوپاسخ را از نظر درستی، به صورت دستی با امتیاز 0 تا 1 برچسبگذاری کنید. با G-Eval نمرهدهی کنید و همبستگی اسپیرمن بین داور و انسان را بسنجید.
- سخت. یک گیت CI مبتنی بر pytest با DeepEval بسازید. عملکرد سیستم بازیابی را عمداً پایین بیاورید. بررسی کنید که گیت حتماً fail شود. سپس با بررسی آستانهی 10% ضعیفترین دادهها، هشدار چندک پایینی را پیادهسازی کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوهای عامیانه | معنای دقیق فنی |
|---|---|---|
| داوری مدل زبانی (LLM-as-judge) | نمرهدهی با LLM | پرامپت دادن به یک مدل داور برای دادن امتیاز 0 تا 1 بر اساس یک شیوهنامهی نمرهدهی. |
| RAGAS | کتابخانهی معیارهای RAG | فریمورک متنباز ارزیابی با 4 معیار تخصصی RAG بدون نیاز به مرجع. |
| وفاداری (Faithfulness) | آیا پاسخ مستند است؟ | سهمی از ادعاهای پاسخ که توسط زمینهی بازیابیشده پشتیبانی و استلزام میشوند. |
| دقت زمینه (Context precision) | آیا چانکهای بازیابیشده مرتبط بودند؟ | سهمی از چانکهای برتر (Top-K) که واقعاً به درد خروجی خوردهاند. |
| بازخوانی زمینه (Context recall) | آیا سیستم همه چیز را پیدا کرده است؟ | سهمی از ادعاهای پاسخ مرجع طلایی که با چانکهای بازیابیشده تایید میشوند. |
| G-Eval | داور سفارشی مدل زبانی | شیوهنامهی نمرهدهی + گامهای ارزیابی زنجیرهی تفکر + امتیاز 0 تا 1. |
| کالیبراسیون (Calibration) | اعتماد کن ولی اعتبارسنجی کن | همبستگی اسپیرمن میان نمرهی مدل داور و نمرهی ناظر انسانی. |
برای مطالعهی بیشتر
- Es et al. (2023). RAGAS: Automated Evaluation of Retrieval Augmented Generation — مقالهی RAGAS.
- Liu et al. (2023). G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment — مقالهی G-Eval.
- مستندات DeepEval — استک باز برای محیط پروداکشن.
- Zheng et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena — سوگیریها، کالیبراسیون و محدودیتها.
- MLflow GenAI Scorer — فریمورک یکپارچهساز RAGAS، DeepEval و Phoenix.