
در طراحی سیستمهای تولید مبتنی بر بازیابی (RAG) یا موتورهای جستوجو، تکیهی صِرف بر جستوجوی برداری اغلب به نتایج ناقص ختم میشود. مدلهای متراکم در درک معنایی فوقالعادهاند اما در پیدا کردن کدهای دقیق، واژگان خاص و شناسهها به خطا میافتند؛ در سوی مقابل، الگوریتمهای سنتی مثل BM25 تطابق عینی را عالی میفهمند اما از درک عبارات هممعنی عاجزند.
معماری استاندارد روز دنیا حل این مشکل را در جستوجوی ترکیبی (Hybrid Search) میداند: ترکیبی هوشمندانه از بازیابی پراکنده و متراکم، ادغام نتایج با الگوریتم RRF و در نهایت رتبهبندی مجدد با یک کراسانکودر (Cross-Encoder). بیش از 80 درصد خطاهای سامانههای RAG به نقص در مرحلهی بازیابی و آمادهسازی کانتکست مربوط است، نه ضعف مدل زبانی.
برای پیادهسازی مدلهای امبدینگ سبک مثل all-MiniLM-L6-v2 نیازی به سختافزار گرانقیمت یا سرویسهای ابری ندارید و اجرای محلی روی CPU یا تراشههای شخصی بهسادگی پاسخگوی کار است. توجه داشته باشید که دانلود اولیهی این مدلها از مخازنی مانند Hugging Face یا نصب کتابخانهها از PyPI ممکن است از داخل ایران با کندی یا اختلال همراه باشد که در این صورت استفاده از میرورهای جایگزین راهگشاست.
الگوریتم BM25 دقیق است اما شکننده. بازیابی متراکم (dense retrieval) تور بزرگی پهن میکند ولی کلیدواژهها را از دست میدهد. جستوجوی ترکیبی (hybrid) گزینهی پیشفرض سال 2026 است. هر چیز دیگری صرفاً تنظیم دقیقتر به حساب میآید.
صورت مسئله
کاربر تایپ میکند: «اگر کسی با دروغ پول بگیرد چه میشود؟» و انتظار دارد ماده قانونی ناظر بر این موضوع را پیدا کند: «بخش 420 قانون مجازات». جستوجوی کلیدواژهای آن را کاملاً از دست میدهد (چون واژگان مشترکی ندارند). جستوجوی معنایی (semantic search) هم اگر امبدینگها روی متون حقوقی آموزش ندیده باشند ناکام میماند. یک جستوجوی واقعی باید از پس هر دو حالت بربیاید.
بازیابی اطلاعات (IR) همان پایپلاینی است که زیربنای تمام سیستمهای RAG، هر نوار جستوجو و بخش سرچ فازی (fuzzy lookup) مستندات را تشکیل میدهد. معماری موفقی که در سال 2026 وارد پروداکشن میشود یک روش منفرد نیست؛ بلکه زنجیرهای از روشهای مکمل است که هر کدام خطاهای مرحلهی قبل را جبران میکنند.
در این درس هر قطعه را میسازیم و مشخص میکنیم هر کدام جلوی چه خطاهایی را میگیرد.
مفاهیم پایه
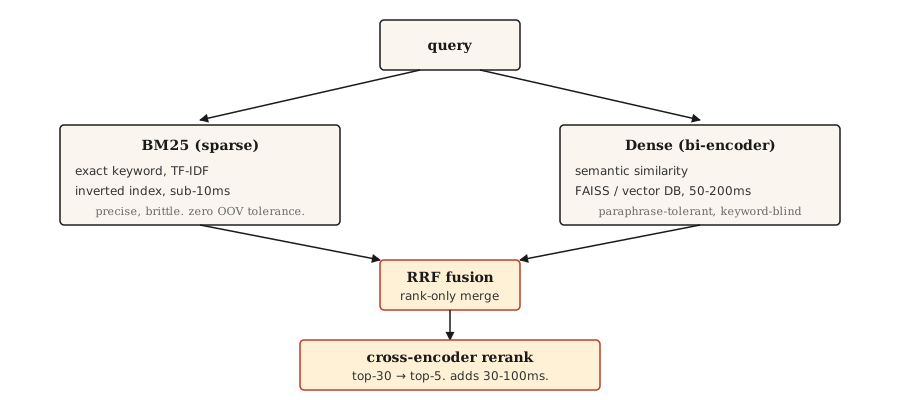
چهار لایه پیش رو داریم. بخشهایی را که نیاز دارید انتخاب کنید:
- بازیابی پراکنده (BM25). سریع، دقیق در تطابقهای عینی، بسیار ضعیف در درک معنا. روی یک نمایهی معکوس (inverted index) اجرا میشود. سرعت آن زیر 10 میلیثانیه برای هر کوئری روی میلیونها سند است. ارجاعات قانونی، کدهای کالا، پیامهای خطا و موجودیتهای نامدار (named entities) را دقیق پیدا میکند.
- بازیابی متراکم (Dense retrieval). کوئری و اسناد را به بردار تبدیل میکند. جستوجوی نزدیکترین همسایه است و عبارات بازنویسیشده و شباهتهای معنایی را شکار میکند؛ اما تطابقهای کلیدواژهای را که حتی یک حرف با هم تفاوت دارند جا میاندازد. اجرای آن با FAISS یا یک پایگاه دادهی برداری، بین 50 تا 200 میلیثانیه به ازای هر کوئری زمان میبرد.
- ادغام رتبهبندیها (Fusion). لیستهای رتبهبندیشدهی لایهی متراکم و پراکنده را merge میکند. روش ادغام متقابل رتبهها یا RRF (مخفف Reciprocal Rank Fusion) یک گزینهی دمدستی و استاندارد است، چون امتیازهای خام را (که در مقیاسهای متفاوتی هستند) نادیده میگیرد و فقط بر اساس جایگاه رتبهها عمل میکند. اگر میدانید در حوزهی کاری شما یکی از سیگنالها دست بالا را دارد، ادغام وزندار (weighted fusion) هم مطرح میشود.
- بازرتبهبندی با کراسانکودر (Cross-encoder rerank). 30 نتیجهی برتر خروجی از مرحلهی ادغام را میگیرد. یک کراسانکودر را روی آنها اجرا میکند (کوئری و سند را با هم میسنجد و به هر جفت امتیاز میدهد). در نهایت 5 نتیجهی اول را نگه میدارد. کراسانکودرها به ازای هر جفت، کندتر از بایانکودرها (bi-encoders) هستند اما دقت بسیار بالاتری دارند. این هزینهی پردازشی را با اجرای مدل فقط روی 30 نتیجهی برتر سرشکن میکنید.
بازیابی سهگانه (BM25 + متراکم + مدلهای پراکندهی یادگیریشده مثل SPLADE) در بنچمارکهای سال 2026 از روش دوگانه جلو میزند؛ ولی برای نمایههای پراکندهی یادگیریشده به زیرساخت ویژه نیاز دارد. برای بیشتر تیمها، همان ترکیب دوگانه به علاوهی بازرتبهبندی کراسانکودر نقطهی تعادل ایدهآل است.
پیادهسازی
مرحلهی 1: BM25 از صفر
import math
import re
from collections import Counter

TOKEN_RE = re.compile(r"[a-z0-9]+")


def tokenize(text):
    return TOKEN_RE.findall(text.lower())


class BM25:
    def __init__(self, corpus, k1=1.5, b=0.75):
        if not corpus:
            raise ValueError("corpus must not be empty")
        self.corpus = [tokenize(d) for d in corpus]
        self.k1 = k1
        self.b = b
        self.n_docs = len(self.corpus)
        self.avg_dl = sum(len(d) for d in self.corpus) / self.n_docs
        self.df = Counter()
        for doc in self.corpus:
            for term in set(doc):
                self.df[term] += 1

    def idf(self, term):
        n = self.df.get(term, 0)
        return math.log(1 + (self.n_docs - n + 0.5) / (n + 0.5))

    def score(self, query, doc_idx):
        q_tokens = tokenize(query)
        doc = self.corpus[doc_idx]
        dl = len(doc)
        freq = Counter(doc)
        score = 0.0
        for term in q_tokens:
            f = freq.get(term, 0)
            if f == 0:
                continue
            numerator = f * (self.k1 + 1)
            denominator = f + self.k1 * (1 - self.b + self.b * dl / self.avg_dl)
            score += self.idf(term) * numerator / denominator
        return score

    def rank(self, query, top_k=10):
        scored = [(self.score(query, i), i) for i in range(self.n_docs)]
        scored.sort(reverse=True)
        return scored[:top_k]
دو پارامتر مهم که باید بدانید: k1=1.5 میزان اشباع بسامد کلمات را کنترل میکند؛ مقدار بالاتر به معنی وزن بیشتر برای تکرار کلمه است. b=0.75 نرمالسازی طول سند را کنترل میکند؛ 0 طول سند را نادیده میگیرد و 1 آن را کامل نرمال میکند. این مقادیر، پیشنهادهای خود رابرتسون در مقالهی اصلی هستند و بهندرت نیاز به تنظیم دارند.
مرحلهی 2: بازیابی متراکم با بایانکودر
from sentence_transformers import SentenceTransformer
import numpy as np


def build_dense_index(corpus, model_id="sentence-transformers/all-MiniLM-L6-v2"):
    encoder = SentenceTransformer(model_id)
    embeddings = encoder.encode(corpus, normalize_embeddings=True)
    return encoder, embeddings


def dense_search(encoder, embeddings, query, top_k=10):
    q_emb = encoder.encode([query], normalize_embeddings=True)
    sims = (embeddings @ q_emb.T).flatten()
    order = np.argsort(-sims)[:top_k]
return [(float(sims[i]), int(i)) for i in order]امبدینگها را با نرم L2 نرمال کنید تا ضرب داخلی معادل کسینوس شود. مدل all-MiniLM-L6-v2 اندازهی 384 بُعدی دارد؛ سریع است و برای بیشتر کارهای بازیابی متون انگلیسی کفایت میکند. برای کارهای چندزبانه از paraphrase-multilingual-MiniLM-L12-v2 استفاده کنید. برای بالاترین سطح دقت، به سراغ bge-large-en-v1.5 یا e5-large-v2 بروید.
مرحلهی 3: روش RRF (Reciprocal Rank Fusion)
def reciprocal_rank_fusion(rankings, k=60):
    scores = {}
    for ranking in rankings:
        for rank, (_, doc_idx) in enumerate(ranking):
            scores[doc_idx] = scores.get(doc_idx, 0.0) + 1.0 / (k + rank + 1)
    fused = sorted(scores.items(), key=lambda x: x[1], reverse=True)
    return [(score, doc_idx) for doc_idx, score in fused]
ثابت k=60 از مقالهی اصلی RRF میآید. مقدار بالاتر k اثر اختلاف رتبهها را ملایمتر میکند؛ مقدار پایینتر k وزن بالایی به رتبههای برتر میدهد. عدد 60 پیشفرض مقاله است و بهندرت نیاز به دستکاری دارد.
مرحلهی 4: جستوجوی ترکیبی + بازرتبهبندی
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L-6-v2")


def hybrid_search(query, bm25, encoder, dense_embeddings, corpus, top_k=5, pool_size=30, reranker=reranker):
    sparse_ranking = bm25.rank(query, top_k=pool_size)
    dense_ranking = dense_search(encoder, dense_embeddings, query, top_k=pool_size)
    fused = reciprocal_rank_fusion([sparse_ranking, dense_ranking])[:pool_size]

    pairs = [(query, corpus[doc_idx]) for _, doc_idx in fused]
    scores = reranker.predict(pairs)
    reranked = sorted(zip(scores, [doc_idx for _, doc_idx in fused]), reverse=True)
    return reranked[:top_k]
سه مرحله ترکیب شدهاند: BM25 تطابقهای واژگانی را پیدا میکند، بازیابی متراکم به دنبال شباهتهای معنایی میرود، RRF دو رتبهبندی را بدون نیاز به کالیبراسیون مقیاس نمرات merge میکند، و کراسانکودر به 30 نتیجهی برتر با ارزیابی همزمان جفت کوئری-سند امتیازدهی مجدد میکند تا ارتباطهای ظریفی را که بایانکودر متوجه نشده بود درآورد. در آخر 5 نتیجهی اول حفظ میشوند.
مرحلهی 5: ارزیابی
| معیار | مفهوم |
|---|---|
| Recall@k | از میان کوئریهایی که سند درست برایشان وجود دارد، این سند چقدر در k نتیجهی اول قرار گرفته است؟ |
| MRR (Mean Reciprocal Rank) | میانگین معکوس رتبهی (1/rank) اولین سند مرتبط. |
| nDCG@k | درجات ارتباط سند را لحاظ میکند، نه صرفاً حالت دودوییِ مرتبط/نامرتبط. |
بهویژه در RAG، بازخوانی یعنی Recall@k بخش بازیابی، حیاتیترین عدد شماست. اگر متنِ درست داخل مجموعهی بازیابیشده نباشد، مدل پاسخدهندهی شما (reader) نمیتواند پاسخ بدهد.
ترفند عیبیابی: برای کوئریهای ناموفق، تفاوت رتبهبندیهای متراکم و پراکنده را بررسی کنید. اگر یکی سند درست را پیدا کرد و دیگری نتوانست، یا با عدم تطابق واژگان روبهرو هستید (راهکار: اضافه کردن بخش گمشده) یا با ابهام معنایی (راهکار: امبدینگهای بهتر یا یک بازرتبهبند).
استفاده در عمل
استک سال 2026:
| مقیاس | استک |
|---|---|
| 1k تا 100k سند | BM25 در حافظه (In-memory) + امبدینگهای all-MiniLM-L6-v2 + ادغام با RRF. بدون نیاز به دیتابیس جداگانه. |
| 100k تا 10M سند | کتابخانهی FAISS یا pgvector برای بخش متراکم + Elasticsearch یا OpenSearch برای BM25. اجرا به صورت موازی. |
| بیش از 10M سند | Qdrant / Weaviate / Vespa / Milvus با پشتیبانی از جستوجوی ترکیبی. بازرتبهبندی کراسانکودر روی 30 نتیجهی برتر. |
| بالاترین مرز کیفی | سهگانه (BM25 + متراکم + SPLADE) + بازرتبهبندی با تعامل دیرهنگامِ ColBERT |
هر کدام را انتخاب میکنید، برای ارزیابی بودجه کنار بگذارید. پیش از بنچمارک گرفتن از دقت کل چرخهی RAG، بازخوانی (recall) بازیابی را بسنجید. یک مدل پاسخدهنده نمیتواند آنچه را بازیاب جا انداخته درست کند.
درسهای گرانبها از RAG در پروداکشن سال 2026
- 80 درصد خرابیهای RAG به مرحلهی ورود داده (ingestion) و قطعهبندی (chunking) برمیگردد، نه مدل. تیمها هفتهها وقت تلف میکنند تا LLMها را عوض کنند و پرامپتها را تغییر دهند، غافل از اینکه سیستم بازیابی در هر سه کوئری یکی را با کانتکست اشتباه برمیگرداند. اول از همه چانکینگ را درست کنید.
- استراتژی چانکینگ از اندازهی چانک مهمتر است. خرد کردن با اندازهی ثابت، ساختار جدولها، کدها و هدینگهای تودرتو را به هم میریزد. چانکینگ بر اساس جملات گزینهی پیشفرض است؛ برای مستندات فنی و دفترچههای راهنما، چانکینگ معنایی یا مبتنی بر LLM ارزش هزینهاش را دارد.
- الگوی والد-فرزند (Parent-doc pattern). برای افزایش دقت، چانکهای کوچک «فرزند» را بازیابی کنید. وقتی چند فرزند از یک بخش والدِ مشترک پیدا شدند، کل بلوک والد را جایگزین کنید تا کانتکست حفظ شود. این روش بدون بازآموزی مدل، کیفیت پاسخها را بالا میبرد.
- معمولاً k_rerank=3 بهترین مقدار است. چانکهای اضافه هزینهی توکن و تأخیر تولید متن را بالا میبرند بیآنکه کیفیت پاسخ را بهتر کنند. اگر برای شما k=8 بهتر از k=3 کار میکند، بازرتبهبند (reranker) شما ضعیف است.
- تکنیک HyDE یا گسترش کوئری. از روی کوئری یک پاسخ فرضی تولید کنید، آن را به بردار تبدیل کنید و سپس بازیابی را انجام دهید. این کار فاصلهی لحن و نگارش میان سوالات کوتاه و اسناد طولانی را پر میکند و بدون هیچ کارهای آموزشی، دقت را بالا میبرد.
- بودجهی کانتکست را زیر 8K توکن نگه دارید. اگر مرتب به این سقف برخورد میکنید، یعنی آستانهی (threshold) بازرتبهبند شما بیش از حد باز است.
- همهچیز را نسخهگذاری کنید. پرامپتها، قواعد چانکینگ، مدل امبدینگ و بازرتبهبند. هر تغییری ممکن است کیفیت پاسخ را بیصدا نابود کند. گیتهای CI روی وفاداری متن (faithfulness)، دقت کانتکست و نرخ سوالات بیپاسخ مانع از رسیدن پسرفتها به دست کاربران میشوند.
- بازیابی سهگانه (BM25 + متراکم + روشهای پراکندهی یادگیریشده مثل SPLADE) در بنچمارکهای سال 2026 از مدلهای دوگانه بهتر عمل میکند؛ بهویژه برای کوئریهایی که اسامی خاص را با واژگان معنایی ترکیب کردهاند. به محض اینکه زیرساخت شما از نمایههای SPLADE پشتیبانی کرد، آن را پیاده کنید.
طبق ارزیابیهای فنی سال 2026، طراحی درست بازیابی میزان توهمات مدل (hallucinations) را بین 70 تا 90 درصد کم میکند. بیشتر دستاوردهای کارایی RAG حاصل بازیابی بهتر است، نه فاینتیونینگ مدل.
خروجی آماده
فایل را در مسیر outputs/skill-retrieval-picker.md ذخیره کنید:
---
name: retrieval-picker
description: Pick a retrieval stack for a given corpus and query pattern.
version: 1.0.0
phase: 5
lesson: 14
tags: [nlp, retrieval, rag, search]
---

Given requirements (corpus size, query pattern, latency budget, quality bar, infra constraints), output:

1. Stack. BM25 only, dense only, hybrid (BM25 + dense + RRF), hybrid + cross-encoder rerank, or three-way (BM25 + dense + learned-sparse).
2. Dense encoder. Name the specific model. Match to language(s), domain, and context length.
3. Reranker. Name the specific cross-encoder model if used. Flag that rerank adds 30-100ms latency on top-30.
4. Evaluation plan. Recall@10 is the primary retriever metric. MRR for multi-answer. Baseline first, incremental improvements measured against it.

Refuse to recommend dense-only for corpora with named entities, error codes, or product SKUs unless the user has evidence dense handles exact matches. Refuse to skip reranking for high-stakes retrieval (legal, medical) where the final top-5 decides the user's answer.تمرینها
- ساده. تابع
hybrid_searchبالا را روی مجموعهای از 500 سند پیادهسازی کنید. 20 کوئری را بیازمایید. بازخوانی در 5 نتیجهی اول (recall at 5) را بین سه حالت «فقط BM25»، «فقط متراکم» و «ترکیبی» مقایسه کنید. - متوسط. محاسبهی MRR را اضافه کنید. برای هر کوئری تست با سند صحیح مشخص، رتبهی سند درست را در نتایج BM25، متراکم و ترکیبی پیدا کنید. مقدار MRR را برای هر کدام گزارش دهید.
- سخت. با استفاده از تابع زیانِ MultipleNegativesRankingLoss در کتابخانهی Sentence Transformers، یک انکودر متراکم را روی دامنهی کاری خود فاینتیون کنید. یک مجموعهی آموزشی از 500 جفت کوئری-سند بسازید. بازخوانی را پیش و پس از فاینتیونینگ مقایسه کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای دقیق فنی |
|---|---|---|
| BM25 | جستوجوی کلیدواژهای | Okapi BM25. اسناد را بر اساس بسامد کلمه، IDF و طول سند نمرهدهی میکند. |
| بازیابی متراکم (Dense retrieval) | جستوجوی برداری | انکود کردن کوئری و سند به بردار و یافتن نزدیکترین همسایهها. |
| بایانکودر (Bi-encoder) | مدل امبدینگ | کوئری و سند را جداگانه انکود میکند. در زمان جستوجو بسیار سریع است. |
| کراسانکودر (Cross-encoder) | مدل بازرتبهبند | کوئری و سند را با هم انکود میکند. کند اما بسیار دقیق است. |
| RRF | ترکیب رتبهها | ادغام دو لیست رتبهبندی با جمع زدن مقادیر 1/(k + rank). |
| Recall@k | معیار ارزیابی بازیابی | نسبت کوئریهایی که سند مرتبط در k نتیجهی برتر آنها وجود دارد. |
برای مطالعهی بیشتر
- Robertson and Zaragoza (2009). The Probabilistic Relevance Framework: BM25 and Beyond — مرجع اصلی و کامل بررسی BM25.
- Karpukhin et al. (2020). Dense Passage Retrieval for Open-Domain QA — مقالهی DPR، مرجع شاخص مدلهای بایانکودر.
- Formal et al. (2021). SPLADE: Sparse Lexical and Expansion Model — بازیاب پراکندهی یادگیریشده که فاصلهی این حوزه را با بازیابی متراکم پر کرد.
- Cormack, Clarke, Büttcher (2009). Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods — مقالهی اصلی روش RRF.
- Khattab and Zaharia (2020). ColBERT: Efficient and Effective Passage Search — بازیابی مبتنی بر تعامل دیرهنگام (late-interaction).