
اگر در پردازش متن با مدلهای زبانی با مشکل کلمات ناشناخته (توکنهای [UNK]) روبهرو شده باشید یا شکستن متون به سطح کاراکتر طول توالیهای پردازشیتان را به شکل سرسامآوری افزایش داده باشد، توکنسازی زیرکلمه (Subword Tokenization) راهحل کلیدی این چالش است. این الگوریتمها با شکستن واژگان نادر به قطعات معنادار و حفظ کلمات پرتکرار در قالب یک توکن واحد، ستون فقرات تمامی مدلهای زبانی امروزی از جمله سری GPT، Llama و Gemma را شکل میدهند.
در زبانهایی مانند فارسی که وندهای صرفی پرتکرار و ساختارهای پیوندی متعدد دارند، آشنایی عمیق با نحوهی قطعهبندی واژگان و تفاوت الگوریتمهایی چون BPE، WordPiece و Unigram اهمیتی دوچندان دارد. توکنسازهای نامناسب میتوانند یک کلمهی معمولی فارسی را به چندین توکن بشکنند که نتیجهی مستقیم آن مصرف بیرویهی ظرفیت پنجرهی زمینه (Context Window) و افزایش هزینههای استنتاج خواهد بود.
در این درس پیادهسازی BPE از صفر، نحوهی آموزش واژگان به کمک SentencePiece و استفاده از ابزارهای فوقسریع مثل tiktoken و HF Tokenizers را بررسی میکنیم تا بتوانید متناسب با کاربرد مدل و منابع محاسباتی خود بهترین ابزار را انتخاب کنید.
توکنسازهای کلمهای در مواجهه با کلمات ندیده به بنبست میخورند. توکنسازهای کاراکتری طول توالی را بیش از حد بالا میبرند. توکنسازهای زیرکلمه (Subword) راهحلی میانهی این دو ارائه میدهند و تمام مدلهای زبانی بزرگ مدرن بر پایهی یکی از آنها عرضه میشوند.
صورت مسئله
واژگان شما 50,000 کلمه دارد. کاربر واژهی «untokenizable» را تایپ میکند. توکنساز شما توکن [UNK] را برمیگرداند. اکنون مدل هیچ نشانهای از این کلمه دریافت نمیکند. بدتر اینکه در صدک 90 اسناد مجموعهدادهتان، 40 کلمهی نادر وجود دارد؛ یعنی به ازای هر سند، 40 بیت اطلاعاتِ ازدسترفته.
توکنسازی زیرکلمه این مشکل را حل میکند. کلمات پرتکرار در قالب یک توکن واحد باقی میمانند، در حالی که کلمات نادر به تکههای معنادار تجزیه میشوند: untokenizable به un، token و izable خرد میشود. دادههای آموزشی همهچیز را پوشش میدهند، زیرا هر رشتهای در نهایت توالیای از بایتهاست.
تمامی مدلهای بزرگ پیشرو در سال 2026 بر پایهی یکی از سه الگوریتم اصلی (BPE، Unigram یا WordPiece) و درون یکی از سه کتابخانهی مطرح (HF Tokenizers ،SentencePiece یا tiktoken) عرضه میشوند. برای ارائهی یک مدل زبانی چارهای ندارید جز اینکه یکی از این روشها را انتخاب کنید.
مفهوم پایه
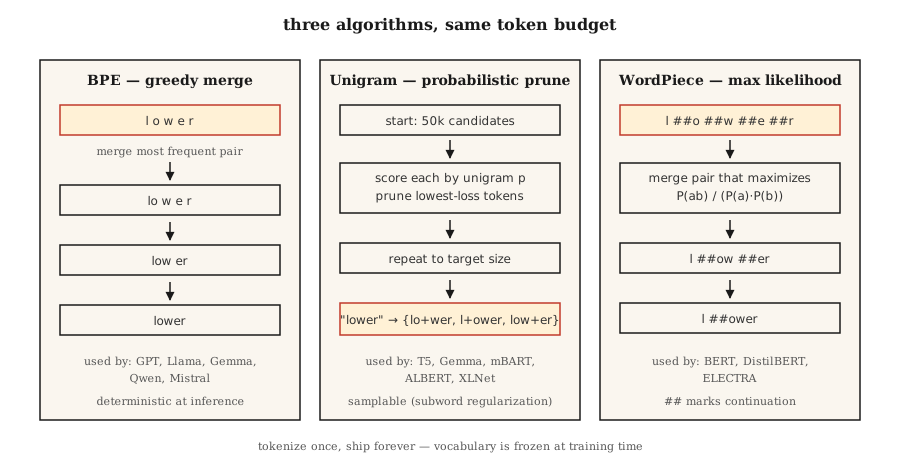
الگوریتم BPE (رمزگذاری جفتبایت / Byte-Pair Encoding): کار را با واژگانی در سطح کاراکتر شروع کنید. تعداد تکرار هر جفتِ مجاور را بشمارید. پرتکرارترین جفت را در یک توکن جدید merge کنید. این فرایند را تکرار کنید تا به حجم واژگان هدف برسید. این الگوریتم، روش غالب در GPT-2/3/4، Llama، Gemma، Qwen2 و Mistral است.
الگوریتم Byte-level BPE: همان الگوریتم است، اما به جای کاراکترهای یونیکد، مستقیماً روی بایتهای خام (256 توکن پایه) اجرا میشود. این رویکرد صفر بودن توکنهای [UNK] را تضمین میکند؛ چرا که هر توالی از بایتها قابل رمزگذاری است. مدل GPT-2 از 50,257 توکن استفاده میکند (شامل 256 بایت خام، 50,000 عملیات merge و 1 توکن ویژه).
الگوریتم Unigram: کار را با مجموعهای بسیار بزرگ از توکنها شروع کنید. به هر توکن، یک احتمال یونیگرام اختصاص دهید. توکنهایی را که حذفشان کمترین افزایش را در درستنمایی لگاریتمی (log-likelihood) دادهها ایجاد میکند، بهصورت مکرر هرس کنید. این روش در زمان استنتاج بهصورت احتمالات عمل میکند و میتواند توکنسازیهای متفاوتی را نمونهبرداری کند (ویژگی بسیار مفیدی برای غنیسازی دادهها از طریق منظمسازی زیرکلمهای). مدلهای T5، mBART، ALBERT، XLNet و Gemma از این الگوریتم بهره میبرند.
الگوریتم WordPiece: به جای بسامد خام، جفتهایی را merge میکند که درستنمایی مجموعهدادهی آموزشی را به حداکثر میرسانند. این روش در BERT، DistilBERT و ELECTRA به کار رفته است.
تفاوت SentencePiece و tiktoken: کتابخانهی SentencePiece برای آموزش واژگان (BPE یا Unigram) مستقیماً روی متن خام یونیکد طراحی شده و فاصلهها را با نماد ▁ کدگذاری میکند. در مقابل، tiktoken صرفاً یک کدگذار بسیار سریع متعلق به OpenAI برای واژگانِ ازپیشساخته است و کار آموزش واژگان را انجام نمیدهد.
قاعدهی سرانگشتی:
- آموزش واژگان جدید: SentencePiece (برای پشتیبانی چندزبانه، بدون نیاز به پیشتوکنسازی) یا HF Tokenizers.
- استنتاج سریع بر پایهی واژگان GPT: کتابخانهی tiktoken (با واژگان cl100k_base یا o200k_base).
- هر دو مورد با هم: HF Tokenizers — یک کتابخانه، هم برای آموزش و هم سرویسدهی.
پیادهسازی
گام 1: پیادهسازی BPE از صفر
کد مربوطه را در فایل code/main.py ببینید. حلقهی اصلی:
def train_bpe(corpus, num_merges):
    vocab = {tuple(word) + ("</w>",): count for word, count in corpus.items()}
    merges = []
    for _ in range(num_merges):
        pairs = Counter()
        for symbols, freq in vocab.items():
            for a, b in zip(symbols, symbols[1:]):
                pairs[(a, b)] += freq
        if not pairs:
            break
        best = pairs.most_common(1)[0][0]
        merges.append(best)
        vocab = apply_merge(vocab, best)
    return merges
سه واقعیتی که این الگوریتم کدگذاری میکند: نشانهی </w> پایان کلمه را مشخص میکند تا میان پسوند «low» و پیشوند در «lower» تمایز ایجاد شود. وزندهی بر اساس بسامد باعث میشود جفتهای پرتکرار زودتر برنده شوند. همچنین فهرست mergeها دارای ترتیب است؛ بنابراین در فاز استنتاج، mergeها به همان ترتیبی اعمال میشوند که آموزش دیدهاند.
گام 2: کدگذاری با قوانین merge آموختهشده
def encode_bpe(word, merges):
    symbols = list(word) + ["</w>"]
    for a, b in merges:
        i = 0
        while i < len(symbols) - 1:
            if symbols[i] == a and symbols[i + 1] == b:
                symbols = symbols[:i] + [a + b] + symbols[i + 2:]
            else:
                i += 1
return symbolsپیادهسازی ابتدایی با پیچیدگی زمانی . در محیطهای پروداکشن (نظیر tiktoken و HF Tokenizers) از جستوجوی رتبه-merge با صفهای اولویتدار استفاده میشود و زمان اجرا تقریباً خطی است.
گام 3: پیادهسازی عملی با SentencePiece
import sentencepiece as spm

spm.SentencePieceTrainer.train(
    input="corpus.txt",
    model_prefix="my_tokenizer",
    vocab_size=8000,
    model_type="bpe",          # or "unigram"
    character_coverage=0.9995, # lower for CJK (e.g. 0.9995 for English, 0.995 for Japanese)
    normalization_rule_name="nmt_nfkc",
)

sp = spm.SentencePieceProcessor(model_file="my_tokenizer.model")
print(sp.encode("untokenizable", out_type=str))
# ['▁un', 'token', 'izable']
نکات کلیدی: نیازی به پیشتوکنسازی نیست؛ فاصله به شکل ▁ کدگذاری میشود؛ و پارامتر character_coverage میزان حفظ کاراکترهای نادر را در مقایسه با نگاشت شدن به <unk> تعیین میکند.
گام 4: استفاده از tiktoken برای واژگان سازگار با OpenAI
import tiktoken
enc = tiktoken.get_encoding("o200k_base")
print(enc.encode("untokenizable"))        # [127340, 101028]
print(len(enc.encode("Hello, world!")))   # 4
صرفاً برای کدگذاری است. سرعت فوقالعادهای دارد (با هستهی Rust) و خروجی توکنسازی آن برای شمارش بایت، تخمین هزینهها و بودجهبندی پنجرهی زمینه (Context window) با GPT-4 و GPT-5 کاملاً همخوان است.
دامهایی که در سال 2026 هنوز به پروداکشن راه پیدا میکنند
- تغییر توکنساز (Tokenizer drift): آموزش روی واژگان A و استقرار با واژگان B. شناسهی توکنها مغایرت پیدا میکند و خروجی مدل بیمعنی میشود. حتماً هش فایل
tokenizer.jsonرا در CI بررسی کنید. - ابهام در فاصلهها: در الگوریتم BPE، رشتههای "hello" و " hello" توکنهای متفاوتی تولید میکنند. همواره
add_special_tokensوadd_prefix_spaceرا صریح مشخص کنید. - آموزش ناکافی در چندزبانگی: مجموعهدادههای عمدتاً انگلیسی واژگانی تولید میکنند که خطهای غیرلاتین را به 5 تا 10 برابر توکن بیشتری خرد میکنند. همان پرامپت در GPT-3.5 برای زبانهای ژاپنی یا عربی 5 تا 10 برابر گرانتر تمام میشود. واژگان o200k_base تا حدی این مشکل را حل کرد.
- تکهتکه شدن ایموجیها: یک ایموجی ممکن است تا 5 توکن فضا بگیرد. هنگام بودجهبندی زمینه، چکپوینتِ نحوهی رفتار با ایموجیها را بررسی کنید.
استفادهی عملی
پشتهی ابزارهای سال 2026:
| شرایط | انتخاب |
|---|---|
| آموزش یک مدل تکزبانه از صفر | HF Tokenizers (الگوریتم BPE) |
| آموزش یک مدل چندزبانه | SentencePiece (الگوریتم Unigram با character_coverage=0.9995) |
| سرویسدهی API سازگار با OpenAI | tiktoken (واژگان o200k_base برای GPT-4 به بالا) |
| واژگان تخصصی یک دامنه (کدنویسی، ریاضی، پروتئین) | آموزش BPE سفارشی روی دادههای دامنه و سپس merge با واژگان پایه |
| استنتاج روی Edge، مدل کوچک | Unigram (واژگان کوچکتر عملکرد بهتری دارند) |
اندازهی واژگان یک تصمیم مرتبط با مقیاس است، نه یک عدد ثابت. تخمین سرانگشتی: 32k برای مدلهای کمتر از 1 میلیارد پارامتر، 50 تا 100k برای مدلهای 1 تا 10 میلیارد، و بیش از 200k برای مدلهای چندزبانه یا مرزی.
تحویل خروجی
محتوا را با عنوان outputs/skill-bpe-vs-wordpiece.md ذخیره کنید:
---
name: tokenizer-picker
description: Pick tokenizer algorithm, vocab size, library for a given corpus and deployment target.
version: 1.0.0
phase: 5
lesson: 19
tags: [nlp, tokenization]
---

Given a corpus (size, languages, domain) and deployment target (training from scratch / fine-tuning / API-compatible inference), output:

1. Algorithm. BPE, Unigram, or WordPiece. One-sentence reason.
2. Library. SentencePiece, HF Tokenizers, or tiktoken. Reason.
3. Vocab size. Rounded to nearest 1k. Reason tied to model size and language coverage.
4. Coverage settings. `character_coverage`, `byte_fallback`, special-token list.
5. Validation plan. Average tokens-per-word on held-out set, OOV rate, compression ratio, round-trip decode equality.

Refuse to train a character-coverage <0.995 tokenizer on corpora with rare-script content. Refuse to ship a vocab without a frozen `tokenizer.json` hash check in CI. Flag any monolingual tokenizer under 16k vocab as likely under-spec.تمرینها
- ساده. روی مجموعهدادهی کوچک داخل
code/main.pyیک توکنساز BPE با 500 مرحلهی merge آموزش دهید. سه کلمهی جدید (دیده نشده در آموزش) را کدگذاری کنید. چند مورد دقیقاً 1 توکن و چند مورد بیش از 1 توکن تولید کردند؟ - متوسط. تعداد توکنهای 100 جملهی ویکیپدیای انگلیسی را بین
cl100k_base،o200k_baseو یک BPE که خودتان با SentencePiece و vocab=32k آموزش دادهاید مقایسه کنید. نسبت فشردهسازی هر کدام را گزارش دهید. - سخت. همان مجموعهداده را با سه روش BPE، Unigram و WordPiece آموزش دهید. با استفاده از هر توکنساز روی یک دستهبند کوچک تحلیل احساسات، دقت نهایی را بسنجید. آیا انتخاب توکنساز میتواند امتیاز F1 را بیش از 1 واحد جابهجا کند؟
اصطلاحات کلیدی
| اصطلاح | در گفتار عامه | معنای دقیق فنی |
|---|---|---|
| BPE | رمزگذاری جفتبایت | merge حریصانهی پرتکرارترین جفت کاراکترها تا زمان رسیدن به حجم واژگان مورد نظر. |
| Byte-level BPE | نبود هیچ توکن ناشناخته | BPE روی 256 بایت خام؛ روش بهکاررفته در GPT-2 و Llama. |
| Unigram | توکنساز احتمالات | هرس کردن از میان مجموعهای بزرگ از کاندیداها با استفاده از درستنمایی لگاریتمی؛ بهکاررفته در T5 و Gemma. |
| SentencePiece | همانی که فاصلهها را تغییر میدهد | کتابخانهای که BPE و Unigram را مستقیماً روی متن خام آموزش میدهد؛ فاصله را به شکل ▁ کدگذاری میکند. |
| tiktoken | ابزار سریع | کدگذار BPE از سوی OpenAI بر پایهی Rust برای واژگان ازپیشساخته؛ بدون بخش آموزش. |
| Merge list | اعداد جادویی | فهرست مرتبشدهی mergeهای (a, b) → ab؛ در استنتاج دقیقاً به ترتیب اعمال میشوند. |
| Character coverage | چقدر نادر زیادی نادر است؟ | نسبتی از کاراکترهای دادههای آموزش که توکنساز باید پوشش دهد؛ معمولاً حدود 0.9995. |
برای مطالعهی بیشتر
- Sennrich, Haddow, Birch (2015). Neural Machine Translation of Rare Words with Subword Units — مقالهی BPE.
- Kudo (2018). Subword Regularization with Unigram Language Model — مقالهی Unigram.
- Kudo, Richardson (2018). SentencePiece: A simple and language independent subword tokenizer — مقالهی معرفی کتابخانه.
- Hugging Face — Summary of the tokenizers — مرجع فشرده و کاربردی.
- OpenAI tiktoken repo — مخزن حاوی دستورالعملها و فهرست کدگذاریها.