
در طراحی سیستمهای هوشمند، ارائه پاسخی دقیق، مستند و بدون حاشیه چالش اصلی هر توسعهدهنده است. کاربران به جای خواندن متون طولانی یا مقالات پراکنده، پاسخی مستقیم و واقعی میخواهند. در طول سالهای اخیر، سیستمهای پاسخ به سوالات (Question Answering یا QA) از مدلهای صرفاً استخراجی متن به سوی معماریهای ترکیبی مدرن مانند RAG تکامل یافتهاند تا با کمترین توهم به سوالات کاربران پاسخ دهند.
در این درس یاد میگیرید که چگونه میان مدلهای استخراجی، زایشی و سیستمهای مبتنی بر بازیابی (RAG) تمایز قائل شوید، پایپلاینهای عملیاتی بسازید و با استفاده از معیارهایی نظیر Exact Match و فریمورک ارزیابی RAGAS، عملکرد پاسخها را در محیطهای واقعی بسنجید.
برای اجرای کدهای این درس و دانلود مدلها یا بستهها از Hugging Face و PyPI، با توجه به ناپایداریهای اتصال اینترنت و محدودیتها از داخل ایران، میتوانید از ابزارهایی مانند uv یا میرورهای پایدار استفاده کنید؛ همچنین پیادهسازیهای پایه روی CPU یا سختافزارهای محلی بدون نیاز به GPU ابری بهخوبی اجرا میشوند.
سه سیستم به پاسخ به سوالات (Question Answering یا QA) مدرن شکل دادند: مدلهای استخراجی بخشهای متنی را پیدا کردند، مدلهای مبتنی بر بازیابی آنها را به اسناد واقعی متصل ساختند و مدلهای زایشی پاسخها را تولید کردند. هر دستیار هوش مصنوعی مدرن امروزی، ترکیبی از این سه رویکرد است.
صورت مسئله
کاربر مینویسد «اولین آیفون چه زمانی عرضه شد؟» و انتظار دارد ببیند «29 ژوئن 2007». نه پاسخی مثل «تاریخچهی اپل بسیار طولانی و متنوع است»، و نه عدد «2007» که تنها و بدون هیچ جملهای رها شده باشد؛ بلکه پاسخی مستقیم، مستند و درست.
در دههی گذشته، سه معماری بر حوزهی QA حاکم بودهاند:
- پاسخ به سوالات استخراجی (Extractive QA): با داشتن یک سوال و متنی که میدانیم حاوی پاسخ است، اندیسهای شروع و پایان بخش پاسخ (span) را در متن پیدا میکند. مجموعهدادهی SQuAD بنچمارک استاندارد این حوزه است.
- پاسخ به سوالات در دامنهی باز (Open-domain QA): متن از پیش مشخص نیست. ابتدا باید متن مرتبط بازیابی شود، سپس پاسخ استخراج گردد یا تولید شود. این رویکرد زیربنای تمام پایپلاینهای RAG امروزی است.
- پاسخ به سوالات زایشی / کتاببسته (Generative / Closed-book QA): یک مدل زبانی بزرگ از حافظهی پارامتری خودش پاسخ میدهد. هیچ بازیابی متنی در کار نیست؛ سریعترین حالت در زمان استنتاج (inference)، اما کماعتمادترین حالت در درستی فکتها.
روند سال 2026 رویکرد ترکیبی (هیبرید) است: بازیابی چند متن برتر، و سپس پرامپت دادن به یک مدل زایشی تا پاسخی مستند به آن متنها تولید کند. این همان RAG است؛ درس 14 نیمهی بازیابی را با جزئیات بررسی میکند و در این درس نیمهی QA را میسازیم.
مفاهیم کلیدی
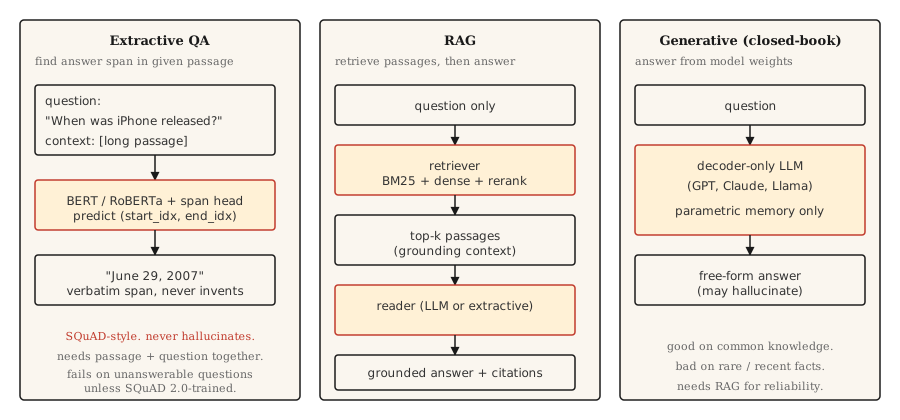
استخراجی: سوال و متن را با هم از طریق یک ترنسفورمر (خانوادهی BERT) انکود کنید. دو سرِ خروجی (head) را آموزش دهید که اندیس توکنهای شروع و پایان پاسخ را پیشبینی کنند. تابع زیان (loss)، آنتروپی متقاطع روی موقعیتهای معتبر است. خروجی بخشی از همان متن است. این ساختار ذاتاً هرگز دچار توهم نمیشود، و ذاتاً هرگز از پس سوالاتی که پاسخی برایشان در متن نیست برنمیآید.
مبتنی بر بازیابی (RAG): دو مرحله دارد. اول، یک بازیاب (retriever) تعداد k متن برتر را از کل اسناد پیدا میکند. دوم، یک خواننده (reader) چه استخراجی باشد و چه زایشی، با استفاده از آن متنها پاسخ را تولید میکند. تفکیک بازیاب از خواننده اجازه میدهد هر کدام را جداگانه آموزش دهید و ارزیابی کنید. در RAG مدرن، معمولاً یک مرحلهی بازرتبهبندی (reranker) نیز بین این دو قرار میگیرد.
زایشی: یک مدل زبانی بزرگ فقط-دیکودر (مثل GPT، Claude یا Llama) بر اساس وزنهای آموزشدیدهی خود پاسخ میدهد، بدون هیچ مرحلهی بازیابی. در دانش عمومی فوقالعاده عمل میکند، اما در فکتهای نادر یا جدید فاجعه است. نرخ توهم با بسامد فکت در دادههای پیشآموزش نسبت عکس دارد.
پیادهسازی از صفر
مرحلهی 1: سیستم QA استخراجی با مدل از پیش آموزشدیده
from transformers import pipeline

qa = pipeline("question-answering", model="deepset/roberta-base-squad2")

passage = (
    "Apple Inc. released the first iPhone on June 29, 2007. "
    "The device was announced by Steve Jobs at Macworld in January 2007."
)
question = "When was the first iPhone released?"

answer = qa(question=question, context=passage)
print(answer)
{'score': 0.98, 'start': 57, 'end': 70, 'answer': 'June 29, 2007'}مدل deepset/roberta-base-squad2 روی SQuAD 2.0 آموزش دیده است که شامل سوالات بدون پاسخ نیز میشود. بهطور پیشفرض، پایپلاین question-answering بخشی را که بیشترین امتیاز را دارد برمیگرداند؛ حتی زمانی که امتیاز «بدون پاسخ» (null score) مدل برنده شده باشد — یعنی بهطور خودکار پاسخ خالی برنمیگرداند. برای دریافت رفتار صریح «بدون پاسخ»، آرگومان handle_impossible_answer=True را به فراخوانی پایپلاین بفرستید: در این حالت پایپلاین تنها زمانی پاسخ خالی میدهد که null score از امتیاز تمام بخشهای متن بیشتر باشد. در هر صورت، همیشه فیلد score را بررسی کنید.
مرحلهی 2: طرح کلی پایپلاین مبتنی بر بازیابی
from sentence_transformers import SentenceTransformer
import numpy as np

encoder = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")

corpus = [
    "Apple Inc. released the first iPhone on June 29, 2007.",
    "Macworld 2007 featured the iPhone announcement by Steve Jobs.",
    "Android launched in 2008 as Google's mobile operating system.",
    "The first iPod was released in 2001.",
]
corpus_embeddings = encoder.encode(corpus, normalize_embeddings=True)


def retrieve(question, top_k=2):
    q_emb = encoder.encode([question], normalize_embeddings=True)
    sims = (corpus_embeddings @ q_emb.T).squeeze()
    order = np.argsort(-sims)[:top_k]
    return [corpus[i] for i in order]


def answer(question):
    passages = retrieve(question, top_k=2)
    combined = " ".join(passages)
    return qa(question=question, context=combined)


print(answer("When was the first iPhone released?"))
یک پایپلاین دومرحلهای: بازیاب متراکم (Sentence-BERT) متون مرتبط را با تشابه معنایی پیدا میکند؛ خوانندهی استخراجی (RoBERTa-SQuAD) بخش پاسخ را از ترکیب متون برتر بیرون میکشد. این روش روی مجموعههای کوچک جواب میدهد. برای مجموعهای با یک میلیون سند، از FAISS یا یک پایگاه دادهی برداری استفاده کنید.
مرحلهی 3: مدل زایشی همراه با RAG
def rag_generate(question, llm):
    passages = retrieve(question, top_k=3)
    prompt = f"""Context:
{chr(10).join('- ' + p for p in passages)}

Question: {question}

Answer using only the context above. If the context does not contain the answer, say "I don't know."
"""
    return llm(prompt)
الگوی پرامپت اهمیت زیادی دارد. اینکه صراحتاً به مدل بگویید بر بستر متن مستند پاسخ دهد و اگر متن کافی نبود بگوید «نمیدانم»، در مقایسه با پرامپتنویسی سادهلوحانه، نرخ توهم را بین 40 تا 60 درصد کاهش میدهد. الگوهای پیشرفتهتر بخشهایی مثل ذکر منبع، امتیاز اطمینان و استخراج ساختاریافته را نیز اضافه میکنند.
مرحلهی 4: ارزیابی متناسب با دنیای واقعی
مجموعهدادهی SQuAD از معیارهای تطابق دقیق (Exact Match یا EM) و F1 در سطح توکن استفاده میکند. معیار EM تطابق سختگیرانه پس از نرمالسازی است (تبدیل به حروف کوچک، حذف علائم نگارشی و حروف تعریف)؛ یعنی پیشبینی یا دقیقاً منطبق است یا امتیاز 0 میگیرد. معیار F1 روی همپوشانی توکنهای پیشبینی و پاسخ مرجع محاسبه میشود و نمرهی نسبی میدهد. هر دو معیار ارزش بازنویسیها را نادیده میگیرند: مثلاً «June 29, 2007» در مقایسه با «June 29th, 2007» معمولاً امتیاز EM صفر میگیرد (چون پسوند ترتیبی نرمالسازی را به هم میزند)، اما به خاطر توکنهای مشترک، F1 بالایی به دست میآورد.
برای سیستمهای QA در محیط پروداکشن:
- صحت پاسخ (Answer accuracy): قضاوتشده با مدل زبانی یا ارزیابی انسانی؛ چون معیارهای سنتی توانایی درک برابری معنایی را ندارند.
- صحت ارجاع (Citation accuracy): آیا متن ارجاعشده واقعاً پاسخ را تایید میکند؟ بررسی خودکار این مورد از طریق تطابق رشتهای بین ارجاعات تولیدشده و متنهای بازیابیشده کار بسیار سادهای است.
- تنظیم امتناع (Refusal calibration): وقتی پاسخ در متنهای بازیابیشده نیست، آیا سیستم بهدرستی میگوید «نمیدانم»؟ نرخ اعتماد کاذب (false confidence rate) را بسنجید.
- بازخوانی بازیاب (Retrieval recall): قبل از ارزیابی خواننده، بسنجید که آیا بازیاب اصلاً متن درست را به جمع
kگزینهی برتر رسانده است یا نه. خواننده نمیتواند متنی را که بازیابی نشده اصلاح کند.
فریمورک RAGAS: استاندارد ارزیابی پروداکشن در سال 2026
فریمورک RAGAS اختصاصاً برای سیستمهای RAG ساخته شده و انتخاب پیشفرض در سال 2026 است. این ابزار چهار بعد را بدون نیاز به پاسخ مرجع قطعی ارزیابی میکند:
- وفاداری (Faithfulness): آیا هر ادعای موجود در پاسخ از زمینهی بازیابیشده نشئت گرفته است؟ این معیار با استلزام مبتنی بر NLI سنجیده میشود و معیار اصلی شما برای سنجش توهم است.
- ارتباط پاسخ (Answer relevance): آیا پاسخ واقعاً به سوال میپردازد؟ این فاکتور با تولید سوالات فرضی بر اساس پاسخ و مقایسهی آنها با سوال اصلی ارزیابی میشود.
- دقت زمینه (Context precision): از بین چانکهای بازیابیشده، چند درصد واقعاً مرتبط بودند؟ دقت پایین یعنی وجود نویز در پرامپت.
- بازخوانی زمینه (Context recall): آیا اطلاعات بازیابیشده تمام دادههای لازم را پوشش میدهد؟ بازخوانی پایین یعنی خواننده شانسی برای موفقیت ندارد.
امتیازدهی بدون نیاز به مرجع (reference-free) امکان ارزیابی ترافیک زنده در محیط پروداکشن را بدون نیاز به پاسخهای مرجع دستچینشده فراهم میکند. برای سوالات تشریحی و باز که معیارهای تطابق دقیق در آنها کاربردی ندارند، یک LLM را به عنوان داور روی آن سوار کنید.
کافی است بنویسید pip install ragas. بازیاب و خوانندهی خود را به آن متصل کنید، برای هر کوئری چهار عدد تحلیلی بگیرید و برای افت عملکرد هشدار بگذارید.
استفاده از ابزارهای واقعی
استک پیشنهادی سال 2026:
| مورد کاربرد | پیشنهاد |
|---|---|
| استخراج بخش پاسخ با داشتن متن | deepset/roberta-base-squad2 |
| کار روی مجموعهی مشخصی از اسناد؛ حالت کتاببسته پذیرفته نیست | RAG: بازیاب متراکم + خوانندهی LLM |
| بلادرنگ روی مخزن اسناد | RAG همراه با بازیاب ترکیبی (BM25 + متراکم) و مدل بازرتبهبندی (درس 14) |
| سیستمهای QA گفتگومحور (پرسشهای تکمیلی) | مدل LLM با تاریخچهی مکالمه + RAG در هر مرحله از گفتگو |
| حوزههای قانونگذاریشده با حساسیت بالای فکتها | روش استخراجی روی متون مرجع معتبر؛ هرگز فقط از مدل زایشی استفاده نکنید |
سیستمهای QA استخراجی در سال 2026 محبوبیت گذشته را ندارند، زیرا RAG به همراه LLM حالات بیشتری را پوشش میدهد. با این حال، هنوز در سناریوهایی که نقلقول مستقیم و موبهمو الزامی است استفاده میشوند: تحقیقات حقوقی، تطبیق با مقررات قانونی و ابزارهای ممیزی.
خروجی این درس
محتوا را با نام outputs/skill-qa-architect.md ذخیره کنید:
---
name: qa-architect
description: Choose QA architecture, retrieval strategy, and evaluation plan.
version: 1.0.0
phase: 5
lesson: 13
tags: [nlp, qa, rag]
---

Given requirements (corpus size, question type, factuality constraint, latency budget), output:

1. Architecture. Extractive, RAG with extractive reader, RAG with generative reader, or closed-book LLM. One-sentence reason.
2. Retriever. None, BM25, dense (name the encoder), or hybrid.
3. Reader. SQuAD-tuned model, LLM by name, or "domain-fine-tuned DistilBERT."
4. Evaluation. EM + F1 for extractive benchmarks; answer accuracy + citation accuracy + refusal calibration for production. Name what you are measuring and how you are measuring it.

Refuse closed-book LLM answers for regulatory or compliance-sensitive questions. Refuse any QA system without a retrieval-recall baseline (you cannot evaluate the reader without knowing the retriever surfaced the right passage). Flag questions that require multi-hop reasoning as needing specialized multi-hop retrievers like HotpotQA-trained systems.تمرینها
- ساده. پایپلاین استخراجی SQuAD بالا را روی 10 متن ویکیپدیا اجرا کنید. 10 سوال دستی طرح کنید و بسنجید پاسخ در چند درصد موارد درست است. اگر متنها و سوالات شفاف باشند، باید 7 تا 9 پاسخ درست دریافت کنید.
- متوسط. یک کلاسیفایر امتناع اضافه کنید. وقتی بیشترین امتیاز بازیابی از یک آستانه کمتر است (مثلاً کسینوس کمتر از 0.3)، به جای فراخوانی خواننده، مستقیماً عبارت «نمیدانم» را برگردانید. این آستانه را روی یک مجموعهی ارزیابی مجزا تنظیم کنید.
- پیشرفته. یک پایپلاین RAG روی مجموعهای شامل 10,000 سند دلخواه بسازید. بازیابی هیبرید (BM25 + متراکم) را با ادغام RRF پیادهسازی کنید (به درس 14 مراجعه کنید). دقت پاسخ را با و بدون مرحلهی هیبرید بسنجید و مستند کنید کدام نوع سوالات بیشترین سود را بردهاند.
اصطلاحات کلیدی
| اصطلاح | در گفتگوها چه میگویند | در عمل یعنی چه |
|---|---|---|
| Extractive QA | پیدا کردن بخش پاسخ | پیشبینی اندیسهای شروع و پایان پاسخ داخل یک متن دادهشده. |
| Open-domain QA | پاسخ به سوال روی کل اسناد | متن مشخصی داده نشده؛ باید ابتدا بازیابی و سپس پاسخ داده شود. |
| RAG | بازیابی و سپس تولید | تولید مبتنی بر بازیابی؛ پایپلاینی متشکل از بازیاب + خواننده. |
| SQuAD | بنچمارک استاندارد | Stanford Question Answering Dataset؛ ارزیابی با معیارهای EM و F1. |
| توهم (Hallucination) | پاسخ ساختگی | خروجی خواننده که توسط زمینهی بازیابیشده پشتیبانی نمیشود. |
| تنظیم امتناع (Refusal calibration) | دانستن اینکه کی باید سکوت کرد | سیستم وقتی قادر به پاسخگویی نیست، بهدرستی بگوید «نمیدانم». |
برای مطالعهی بیشتر
- Rajpurkar et al. (2016). SQuAD: 100,000+ Questions for Machine Comprehension of Text — مقالهی معرفی بنچمارک.
- Karpukhin et al. (2020). Dense Passage Retrieval for Open-Domain QA — مقالهی DPR، بازیاب متراکم استاندارد برای QA.
- Lewis et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — مقالهای که مفهوم RAG را نامگذاری کرد.
- Gao et al. (2023). Retrieval-Augmented Generation for Large Language Models: A Survey — بررسی جامع حوزهی RAG.