
در بیشتر پروژههای توسعهی سیستمهای RAG، علت اصلی بازیابی اشتباهِ اسناد نه به پرامپت مربوط است و نه به نوع پایگاه داده برداری، بلکه مستقیماً از انتخاب نادرست مدل امبدینگ آب میخورد. با رشد سریع مدلهای بازنمایی متن، اکنون انتخاب مدل برداری فراتر از ابزارهای ساده گذشته است و ابعادی چون نوع بردار (متراکم، تنک یا چندبرداری)، پشتیبانی چندزبانه و هزینهی ایندکسگذاری را شامل میشود.
اگر برای پروژههای خود به مدلهای متنی نیاز دارید، استفاده از APIهای ابری خارجی به دلیل محدودیتهای پرداخت ارزی یا مسدودسازی IPها چالشبرانگیز است؛ هرچند گیتویهای واسط داخلی یا مدلهای وزنباز محلی گزینههای در دسترستری محسوب میشوند. از سوی دیگر، دانلود وزن مدلهای حجیم از Hugging Face گاهی با کندی مواجه است و استفاده از میرورها یا اجرای مدلهای سبکتر روی سختافزار شخصی و پردازنده اصلی راهکار عملیتری خواهد بود.
در این درس یاد میگیرید چگونه مدلهای امبدینگ مدرن مانند BGE-M3، رویکردهای هرس ابعاد ماتریوشکا و معیارهای ارزیابی MTEB را بشناسید و مدلی دقیق، بهینه و متناسب با محدودیتهای پردازشی و زبان دادههای خود انتخاب کنید.
مدل Word2Vec به ازای هر کلمه یک بردار به شما میداد. مدلهای امبدینگ (Embedding) امروزی به ازای هر بند متن (passage) یک بردار چندزبانه تولید میکنند؛ با نماهای متراکم (dense)، تنک (sparse) و چندبرداری (multi-vector) که متناسب با اندازه ایندکس شما تنظیم میشوند. اگر در انتخاب مدل اشتباه کنید، سیستم RAG متن اشتباهی را بازیابی خواهد کرد.
صورت مسئله
سیستم RAG شما در 40% مواقع بند متنیِ اشتباهی را بازیابی میکند. مقصر اصلی بهندرت پایگاه داده برداری یا پرامپت (Prompt) است؛ مقصر واقعی همان مدل امبدینگ است.
انتخاب یک مدل امبدینگ در سال 2026 یعنی تصمیمگیری بر اساس پنج محور اساسی:
- متراکم در برابر تنک در برابر چندبرداری. یک بردار به ازای هر بند، یک بردار به ازای هر توکن (Token)، یا یک کیسه کلمات وزندارِ تنک.
- پوشش زبانی. مدلهای تکزبانه انگلیسی هنوز در تسکهای صرفاً انگلیسی برنده میدان هستند. وقتی پیکره متنی (Corpus) چندزبانه باشد، مدلهای چندزبانه دست بالا را دارند.
- طول زمینه (Context length). مقایسه 512 توکن با 8,192 یا 32,768 توکن؛ البته که ظرفیت مؤثر واقعی معمولاً 60 تا 70 درصد حداکثر ظرفیت تبلیغشده است.
- بودجه ابعاد بردار. ذخیره 3,072 مقدار اعشاری (float) با دقت کامل (Full precision) برابر با 12 کیلوبایت برای هر بردار است. برای 100 میلیون بردار، هزینه ذخیرهسازی به $1,300 در ماه میرسد. هرس ماتریوشکا (Matryoshka truncation) این هزینه را تا 4 برابر کاهش میدهد.
- وزنهای باز در برابر سرویسهای ابری (هاستشده). مدل با وزنهای باز (Open-weight) یعنی کنترل کامل استک فنی و دادهها در دست شماست. سرویسهای هاستشده یعنی از دست دادن بخشی از کنترل در ازای دسترسی همیشگی به آخرین نسخهها.
در این درس این سبکسنگینکردنها را شفاف بررسی میکنیم تا تصمیمگیریتان بر پایه شواهد (Evidence) باشد، نه صرفاً دنبالهروی از ترند فصل گذشته.
مفهوم
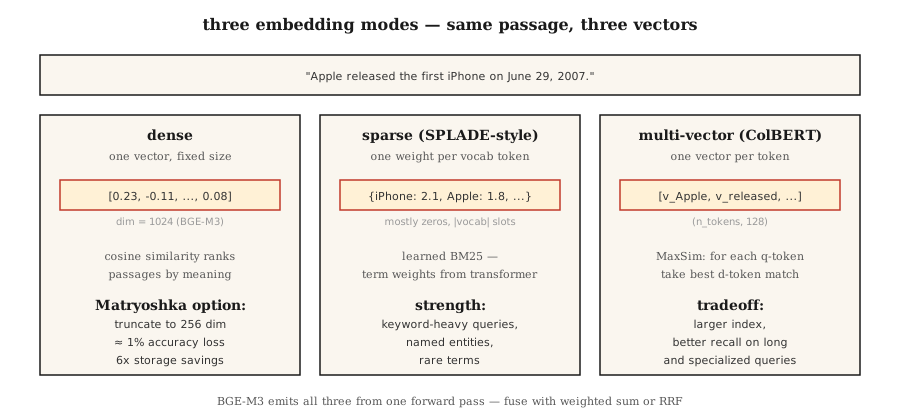
امبدینگهای متراکم (Dense embeddings). یک بردار برای هر بند متن (معمولاً بین 384 تا 3,072 بعد). با شباهت کسینوسی (Cosine Similarity)، بندها بر اساس نزدیکی معنایی رتبهبندی میشوند. مثل text-embedding-3-large از OpenAI، حالت متراکم BGE-M3 و Voyage-3. این گزینه، انتخاب پیشفرض است.
امبدینگهای تنک (Sparse embeddings). به سبک مدل SPLADE. یک ترنسفورمر (Transformer) برای هر توکنِ موجود در دایره واژگان وزنی تعیین میکند و سپس مقدار بیشتر آنها را صفر میکند. نتیجه، یک بردار تنک به اندازه کل دایره واژگان (|vocab|) است. این رویکرد تطابق لغوی (مثل BM25) را پوشش میدهد، اما با وزنهایی که توسط مدل یاد گرفته شدهاند. این حالت روی پرسمانهای پر از کلمات کلیدی بسیار قوی عمل میکند.
چندبرداری یا تعامل متأخر (Multi-vector / Late interaction). مثل ColBERTv2 و Jina-ColBERT. یک بردار به ازای هر توکن. امتیازدهی با الگوریتم MaxSim انجام میشود: برای هر توکن پرسمان، شبیهترین توکن سند را پیدا کرده و امتیازها را با هم جمع میکنیم. ذخیرهسازی و امتیازدهی در این روش هزینهبرتر است، اما در پرسمانهای طولانی و مجموعهمتنهای تخصصی بهترین نتیجه را میدهد.
مدل BGE-M3: هر سه حالت در یک مدل. یک مدل واحد که همزمان بازنماییهای متراکم، تنک و چندبرداری را خروجی میدهد. از هر کدام میتوان مستقل پرسمان گرفت؛ در نهایت امتیازها با یک جمع وزندار ترکیب میشوند. این مدل در سال 2026 گزینه پیشفرض برای زمانی است که انعطافپذیریِ همهجانبه را از یک چکپوینت (Checkpoint) تکی بخواهید.
یادگیری بازنمایی ماتریوشکا (Matryoshka Representation Learning). طوری آموزش دیده که N بعد اول بردار، بهتنهایی یک امبدینگ مستقل و کاربردی بسازند. میتوانید یک بردار 1,536 بعدی را تا 256 بعد کوتاه کنید و در ازای کاهش تنها حدود 1% دقت، 6 برابر در هزینه ذخیرهسازی صرفهجویی کنید. این قابلیت در OpenAI text-3، Cohere v4، Voyage-4، Jina v5، Gemini Embedding 2 و Nomic v1.5+ پشتیبانی میشود.
تابلوی امتیازات MTEB تمام ماجرا را نشان نمیدهد
معیار Massive Text Embedding Benchmark در زمان معرفی (سال 2022) شامل 56 تسک در 8 دستهبندی مختلف بود و در MTEB v2 به بیش از 100 تسک گسترش یافت. در اوایل سال 2026، مدل Gemini Embedding 2 در صدر بازیابی (67.71 MTEB-R) قرار دارد. مدل Cohere embed-v4 در تسکهای عمومی پیشتاز است (65.2 MTEB) و BGE-M3 در میان مدلهای چندزبانه با وزن باز رتبه اول را دارد (63.0). لیدربورد لازم است اما کافی نیست؛ همیشه باید مدلها را روی دامنه تخصصی خودتان بنچمارک کنید.
الگوی سهلایهای
| مورد کاربرد | الگو |
|---|---|
| فیلتر اولیه سریع | انکودر دوگانه متراکم (BGE-M3، text-3-small) |
| افزایش بازخوانی (Recall) | تنک (SPLADE، حالت تنک BGE-M3) + ادغام با RRF |
| دقت روی 50 نتیجه اول | چندبرداری (ColBERTv2) یا بازرتبهبند انکودر متقاطع (Cross-encoder reranker) |
بیشتر استکهای سطح پروداکشن از هر سه لایه استفاده میکنند.
پیادهسازی
گام 1: مدل پایه — امبدینگهای متراکم با Sentence-BERT
from sentence_transformers import SentenceTransformer
import numpy as np

encoder = SentenceTransformer("BAAI/bge-small-en-v1.5")
corpus = [
    "The first iPhone launched in 2007.",
    "Apple released the iPod in 2001.",
    "Android is an operating system from Google.",
]
emb = encoder.encode(corpus, normalize_embeddings=True)

query = "When was the iPhone released?"
q_emb = encoder.encode([query], normalize_embeddings=True)[0]
scores = emb @ q_emb
print(sorted(enumerate(scores), key=lambda x: -x[1]))
گزینه normalize_embeddings=True باعث میشود حاصل ضرب داخلی (Dot product) برابر با شباهت کسینوسی شود. همیشه آن را فعال کنید.
گام 2: هرس ماتریوشکا
def truncate(vectors, dim):
    out = vectors[:, :dim]
    return out / np.linalg.norm(out, axis=1, keepdims=True)

emb_256 = truncate(emb, 256)
emb_128 = truncate(emb, 128)
بعد از هرس و کوتاه کردن بردارها، دوباره آنها را نرمالسازی کنید. مدلهایی مثل Nomic v1.5، OpenAI text-3 و Voyage-4 طوری آموزش دیدهاند که برای چند سطح اول، این کار عملاً بدون افت کیفیت انجام میشود. مدلهای فاقد ماتریوشکا (مثل Sentence-BERT اولیه) با هرس شدن دچار افت شدید کیفیت میشوند.
گام 3: قابلیتهای چندگانه BGE-M3
from FlagEmbedding import BGEM3FlagModel
model = BGEM3FlagModel("BAAI/bge-m3", use_fp16=True)
output = model.encode(
corpus,
return_dense=True,
return_sparse=True,
return_colbert_vecs=True,
)
# output["dense_vecs"]: (n_docs, 1024)
# output["lexical_weights"]: list of dict {token_id: weight}
# output["colbert_vecs"]: لیستی از آرایههای (n_tokens, 1024)سه نوع ایندکس، تنها با یک فراخوانی استنتاج. ترکیب امتیازها:
dense_score = ... # cosine over dense_vecs
sparse_score = model.compute_lexical_matching_score(q_lex, d_lex)
colbert_score = model.colbert_score(q_col, d_col)
final = 0.4 * dense_score + 0.2 * sparse_score + 0.4 * colbert_scoreوزنها را بر اساس دامنه تخصصی خودتان تنظیم کنید.
گام 4: ارزیابی با MTEB روی یک تسک سفارشی
from mteb import MTEB

tasks = ["ArguAna", "SciFact", "NFCorpus"]
evaluation = MTEB(tasks=tasks)
results = evaluation.run(encoder, output_folder="./mteb-results")مدلهای کاندید خود را روی یک زیرمجموعه نماینده و متناسب از دادههایتان ارزیابی کنید. صرفاً به رتبه (Rank) مدل در لیدربورد اعتماد نکنید؛ دامنه تخصصی شما تعیینکننده است.
گام 5: پیادهسازی دستی شباهت کسینوسی از صفر
کد code/main.py را ببینید: امبدینگهای میانگینگیریشده با ترفند هشینگ (Hashing Trick) که صرفاً با کتابخانه استاندارد پایتون پیاده شده است. این روش در عمل با امبدینگهای ترنسفورمری رقابت نمیکند، اما مسیر کلی را نشان میدهد: توکنسازی ← تبدیل به بردار ← نرمالسازی ← ضرب داخلی.
تلهها
- استفاده از مدل یکسان برای پرسمان و سند. برخی مدلها (مثل Voyage یا Jina-ColBERT) از انکودینگ نامتقارن استفاده میکنند؛ یعنی پرسمان و سند از مسیرهای متفاوتی عبور میکنند. همیشه شناسنامه مدل (Model card) را بررسی کنید.
- فراموش کردن پیشوند. مدلهای خانواده
bge-*نیاز دارند عبارت"Represent this sentence for searching relevant passages: "به ابتدای پرسمان اضافه شود. اگر این پیشوند را فراموش کنید، بازخوانی 3 تا 5 امتیاز افت میکند. - هرس بیشازحد ماتریوشکا. کاهش از 1,536 به 256 بعد معمولاً بیخطر است، اما کاهش از 1,536 به 64 بعد اینطور نیست. افت کیفیت را حتماً روی مجموعه ارزیابی خود بسنجید.
- کوتاه شدن بیسرصدای زمینه. بیشتر مدلها ورودیهایی را که از حداکثر طولشان بیشتر باشد، بیصدا کوتاه میکنند. اسناد طولانی حتماً باید تکهتکه (Chunking) شوند (درس 23 را ببینید).
- نادیده گرفتن دم تأخیر (Latency tail). امتیازهای MTEB مقدار تأخیر در صدک 99 (p99 latency) را پنهان میکنند. ممکن است مدلی با 600 میلیون پارامتر نسبت به مدلی 335 میلیونی 2 امتیاز بالاتر بگیرد، اما در هر پرسمان 3 برابر کندتر باشد.
کاربرد عملی
استک پیشنهادی برای سال 2026:
| شرایط | انتخاب |
|---|---|
| فقط انگلیسی، پرسرعت، از طریق API | text-embedding-3-large یا voyage-3-large |
| وزن باز، انگلیسی | BAAI/bge-large-en-v1.5 |
| وزن باز، چندزبانه | BAAI/bge-m3 یا Qwen3-Embedding-8B |
| زمینه طولانی (32k به بالا) | Voyage-3-large، Cohere embed-v4، Qwen3-Embedding-8B |
| اجرا فقط روی پردازنده اصلی (CPU-only) | Nomic Embed v2 (با 137 میلیون پارامتر، معماری MoE) |
| محدودیت شدید فضای ذخیرهسازی | مدلهای هرسشده ماتریوشکا + کوانتایزیشن int8 |
| پرسمانهای متکی بر کلمات کلیدی | افزودن امبدینگ تنک SPLADE و ادغام با متراکم از طریق RRF |
الگوی سال 2026: کار را با BGE-M3 یا text-3-large شروع کنید، با استفاده از MTEB روی دامنه کاری خود ارزیابی انجام دهید و اگر یک مدل تخصصی بیش از 3 امتیاز بالاتر به دست آورد، به سراغ آن بروید.
تحویل پروژه
این فایل را در مسیر outputs/skill-embedding-picker.md ذخیره کنید:
---
name: embedding-picker
description: Pick embedding model, dimension, and retrieval mode for a given corpus and deployment.
version: 1.0.0
phase: 5
lesson: 22
tags: [nlp, embeddings, retrieval]
---

Given a corpus (size, languages, domain, avg length), deployment target (cloud / edge / on-prem), latency budget, and storage budget, output:

1. Model. Named checkpoint or API. One-sentence reason.
2. Dimension. Full / Matryoshka-truncated / int8-quantized. Reason tied to storage budget.
3. Mode. Dense / sparse / multi-vector / hybrid. Reason.
4. Query prefix / template if required by the model card.
5. Evaluation plan. MTEB tasks relevant to domain + held-out domain eval with nDCG@10.

Refuse recommendations that truncate Matryoshka to <64 dims without domain validation. Refuse ColBERTv2 for corpora under 10k passages (overhead not justified). Flag long-document corpora (>8k tokens) routed to models with 512-token windows.تمرینها
- ساده. 100 جمله را با مدل
bge-small-en-v1.5در ابعاد کامل (384) و سپس در بعد 128 با ماتریوشکا انکود کنید. افت شاخص MRR را روی 10 پرسمان اندازه بگیرید. - متوسط. سه حالت متراکم، تنک و colbert مدل BGE-M3 را روی 500 بند متن از دامنه تخصصی خود مقایسه کنید. کدام حالت در recall@10 برنده میشود؟ آیا ادغام به روش RRF از بهترین حالت تکی بهتر عمل میکند؟
- سخت. بنچمارک MTEB را برای سه مدل کاندید روی 2 تسک اصلی دامنه کاریتان اجرا کنید. امتیاز MTEB، تأخیر p99 در دستههای 100تایی پرسمان و هزینه به ازای هر 1 میلیون پرسمان را گزارش کنید. در نهایت مدل بهینه پارتو (Pareto-optimal) را انتخاب کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتگوها چه میگویند | معنای دقیق فنی |
|---|---|---|
| امبدینگ متراکم (Dense embedding) | همان وکتور | یک بردار با ابعاد ثابت به ازای هر متن. استفاده از شباهت کسینوسی برای رتبهبندی. |
| امبدینگ تنک (Sparse embedding) | BM25 یادگرفتهشده | یک وزن برای هر توکن دایره واژگان؛ عمدتاً مقادیر صفر؛ آموزشدیده بهصورت سرتاسری (End-to-end). |
| چندبرداری (Multi-vector) | روشهای شبیه ColBERT | یک بردار به ازای هر توکن؛ امتیازدهی بر مبنای MaxSim؛ ایندکس بزرگتر و بازخوانی بهتر. |
| ماتریوشکا (Matryoshka) | ترفند عروسکهای روسی | N بعد ابتدایی بهتنهایی یک امبدینگ مستقل و معتبر میسازند. |
| MTEB | بنچمارک استاندارد | Massive Text Embedding Benchmark — شامل 56 تسک در زمان انتشار و بیش از 100 تسک در نسخه دوم. |
| BEIR | بنچمارک بازیابی | 18 تسک بازیابی صفر-داده (Zero-shot)؛ مرجعی برای سنجش انعطافپذیری در دامنههای مختلف. |
| انکودینگ نامتقارن (Asymmetric encoding) | تفاوت مسیر پرسمان و سند | مدل برای تصویر کردن (Projection) پرسمان و سند از مسیرهای متفاوتی استفاده میکند. |
برای مطالعه بیشتر
- مقاله Sentence-BERT نوشته Reimers و Gurevych (2019) — مقاله پایهای بی-انکودر (Bi-encoder).
- مقاله MTEB: Massive Text Embedding Benchmark نوشته Muennighoff و همکاران (2022) — مقاله معرفی لیدربورد.
- مقاله BGE-M3: Multi-lingual, Multi-functionality, Multi-granularity نوشته Chen و همکاران (2024) — مدل یکپارچه با سه حالت کاری.
- مقاله Matryoshka Representation Learning نوشته Kusupati و همکاران (2022) — تابع زیان (loss) آموزش بر مبنای نردبان ابعاد.
- مقاله ColBERTv2: Effective and Efficient Retrieval via Lightweight Late Interaction نوشته Santhanam و همکاران (2022) — پیادهسازی تعامل متأخر در محیط پروداکشن.
- لیدربورد MTEB در Hugging Face — رتبهبندی زنده و بهروز مدلها.