
پس از شناسایی موجودیتها و پیوند دادن آنها به مفاهیم یکتا، حلقهی گمشده برای تبدیل متن آزاد به دانش ساختاریافته، کشف ارتباط میان این موجودیتهاست. استخراج رابطه (Relation Extraction) دقیقاً این وظیفه را بر عهده دارد و پایههای ساخت گرافهای دانش (Knowledge Graphs) را شکل میدهد؛ سیستمی که به مدلهای هوش مصنوعی و معماریهای Graph RAG قدرت استدلال، ممیزی دقیق و پیوند دادن حقایق را اعطا میکند.
در سالهای اخیر، استفادهی شتابزده از مدلهای زبانی بزرگ برای استخراج روابط، پدیدهی توهم و تولید گزارههای ساختگی بدون منبع را افزایش داده است. یادگیری رویکردهای مهندسی مدرن مانند چارچوب AEVS به شما کمک میکند سهگانهها را به موقعیتهای کاراکتری دقیق در متن لنگر کنید و گرافهای دانشی بسازید که کاملاً قابل ردیابی و اعتبارسنجی باشند.
اگر برای اجرای مدلهای متنباز این درس مانند REBEL یا کار با کتابخانههای پایتون نیاز به دانلود وزنها از Hugging Face دارید، به یاد داشته باشید که دسترسی به این مخازن از داخل ایران ممکن است گاهی با ناپایداری روبهرو شود؛ برای دسترسی به مدلهای تجاری نیز گیتویهای واسط داخلی یا کلیدهای API سازگار با فرمت OpenAI راهکاری در دسترس برای پیشبرد پروژه هستند.
بازشناسی موجودیتهای نامدار (NER) موجودیتها را پیدا کرد؛ پیونددهی موجودیتها (Entity Linking) آنها را مهار کرد؛ حالا استخراج رابطه (Relation Extraction یا RE) یالهای میان آنها را پیدا میکند. گراف دانش چیزی جز مجموعهی گرهها، یالها و منشأ و سندیت (Provenance) آنها نیست.
صورت مسئله
تحلیلگری این جمله را میخواند: «تیم کوک در سال 2011 مدیرعامل اپل شد.» در این جمله چهار فکت نهفته است:
(Tim Cook, role, CEO)(Tim Cook, employer, Apple)(Tim Cook, start_date, 2011)(Apple, type, Organization)
استخراج رابطه متن آزاد را به سهگانههای (Triples) ساختاریافتهی (subject, relation, object) یا همان «نهاد، رابطه، گزاره» تبدیل میکند. این سهگانهها را در یک پیکرهی متنی تجمیع کنید تا یک گراف دانش داشته باشید. حالا اگر روی آن پرسوجو هم بزنید، به بستری برای استدلال در سامانههای RAG، تحلیل داده یا ممیزیهای انطباق قانونی دست پیدا میکنید.
چالش سال 2026 این است: مدلهای زبانی بزرگ (LLMها) روابط را بیش از حد مشتاقانه استخراج میکنند؛ آنقدر مشتاق که سهگانههایی میسازند که متن مبدأ اصلاً از آنها پشتیبانی نمیکند (توهم میزنند). بدون دانستن منشأ گزارهها، نمیتوان سهگانههای واقعی را از داستانسراییهای باورپذیر تشخیص داد. راهکار سال 2026 پایپلاینهای مهار و اعتبارسنجی به سبک چارچوب AEVS است.
مفاهیم پایه
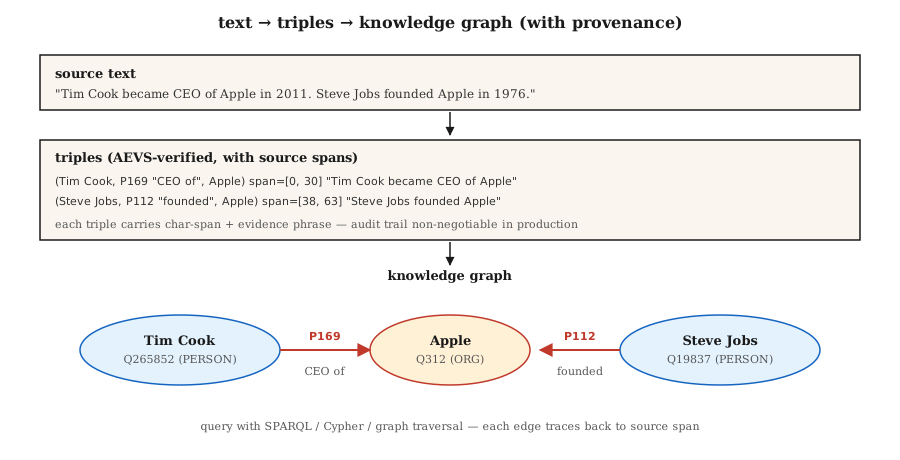
ساختار سهگانه. (subject_entity, relation_type, object_entity). روابط یا از یک آنتولوژی بسته میآیند (ویژگیهای Wikidata، استاندارد FIBO، اصطلاحات UMLS) یا از یک مجموعهی باز (به سبک OpenIE که هر متنی میتواند رابطه باشد).
سه رویکرد استخراج.
- مبتنی بر قاعده یا الگو (Rule / pattern-based). الگوهای هرست (Hearst patterns): «X مانند Y» نتیجه میدهد
(Y, isA, X). همراه با Regexهای دستی. شکننده، دقیق و تفسیرپذیر. - دستهبند بانظارت (Supervised classifier). با داشتن دو موجودیت ذکرشده در جمله، رابطه را از میان یک مجموعهی ثابت پیشبینی میکند. آموزشدیده روی TACRED ،ACE و KBP. رویکرد استاندارد سالهای 2015 تا 2022.
- مدلهای زبانی بزرگ زایا (Generative LLM). با یک پرامپت از مدل میخواهید سهگانهها را تولید کند. بدون دردسر و درجا کار میکند؛ اما اگر منشأ آن بررسی نشود، خروجیهای ساختگی ولی باورپذیر تحویل میدهد.
چارچوب AEVS (مهار، استخراج، اعتبارسنجی، تکمیل - 2026). چارچوب کنونی برای مهار توهم مدلها:
- مهار (Anchor): شناسایی تمام بازههای متنیِ موجودیتها و عباراتِ رابطه با ثبت موقعیت دقیق کاراکتری آنها.
- استخراج (Extract): تولید سهگانههای متصل به بازههای مهارشده.
- اعتبارسنجی (Verify): تطبیق تکتک اجزای سهگانه با متن مبدأ و رد هر دادهای که در متن وجود ندارد.
- تکمیل (Supplement): یک مرحله بررسی پوشش متن برای اطمینان از اینکه هیچ بازهی مهارشدهای از قلم نیفتاده باشد.
با این روش، میزان توهم بهشدت افت میکند. به توان پردازشی بیشتری نیاز دارد، اما کاملاً قابل ممیزی است.
موازنهی آنتولوژی باز در برابر بسته.
- آنتولوژی بسته (Closed ontology): فهرست مشخصی از ویژگیها (مثلاً بیش از 11,000 ویژگی در Wikidata). رفتار قابل پیشبینی دارد، پرسوجو روی آن سرراست است، اما نمیتوان بهسادگی رابطهی جدیدی به آن اضافه کرد.
- استخراج باز یا Open IE: هر عبارت فعلی میتواند یک رابطه باشد. بازخوانی (Recall) بالا، دقت (Precision) پایین و پرسوجوی بسیار نامنظم و آشفته.
گرافهای دانش عملیاتی معمولاً این دو را ترکیب میکنند: با Open IE روابط را کشف میکنند، سپس پیش از ادغام در گراف اصلی، روابط را طبق یک آنتولوژی بسته یکپارچهسازی و استاندارد (Canonicalize) میکنند.
پیادهسازی گامبهگام
گام 1: استخراج مبتنی بر الگو
PATTERNS = [
    (r"(?P<s>[A-Z]\w+) (?:is|was) (?:a|an|the) (?P<o>[A-Z]?\w+)", "isA"),
    (r"(?P<s>[A-Z]\w+) (?:is|was) born in (?P<o>\w+)", "bornIn"),
    (r"(?P<s>[A-Z]\w+) works? (?:at|for) (?P<o>[A-Z]\w+)", "worksAt"),
    (r"(?P<s>[A-Z]\w+) founded (?P<o>[A-Z]\w+)", "founded"),
]
برای دیدن کد کامل این استخراجکنندهی ساده، فایل code/main.py را ببینید. الگوهای هرست هنوز هم در پایپلاینهای حوزههای خاص استفاده میشوند چون اشکالزدایی آنها راحت است.
گام 2: استخراج رابطه با مدلهای بانظارت seq2seq
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM

tok = AutoTokenizer.from_pretrained("Babelscape/rebel-large")
model = AutoModelForSeq2SeqLM.from_pretrained("Babelscape/rebel-large")

text = "Tim Cook was born in Alabama. He later became CEO of Apple."
encoded = tok(text, return_tensors="pt", truncation=True)
output = model.generate(**encoded, max_length=200)
decoded = tok.batch_decode(output, skip_special_tokens=False)
مدل REBEL یک استخراجکنندهی رابطه بر پایهی BART و از نوع seq2seq است: بهجای دستهبندی جفتموجودیتها، مستقیماً سهگانهها را تولید میکند. متن را تحویل میگیرد و سهگانهها را تحویل میدهد؛ با نامهای رابطهای که مستقیماً از ویژگیهای Wikidata برداشته شدهاند. متنهای رمزشکنیشده هنوز برچسبهای <triplet> ،<subj> و <obj> مربوط به REBEL را دارند، بنابراین مثل پارسر موجود در Model Card، متن را بر اساس آنها بشکنید تا به رکوردهای (subject, relation, object) برسید. این مدل روی دادههای با نظارت غیرمستقیم (Distant supervision) فاینتیون شده و بیسلاین استاندارد وزنهای باز (Open-weights) به شمار میرود.
گام 3: استخراج مبتنی بر پرامپت با LLM همراه با مهار متن
prompt = f"""Extract (subject, relation, object) triples from the text.
For each triple, include the exact character span in the source text.

Text: {text}

Output JSON:
[{{"subject": {{"text": "...", "span": [start, end]}},
   "relation": "...",
   "object": {{"text": "...", "span": [start, end]}}}}, ...]

Only include triples fully supported by the text. No inference beyond what is stated.
"""
هر بازهی متنی خروجی را با متن مبدأ تطبیق دهید. هر جا که شرط text[start:end] != triple_entity برقرار نبود، آن را رد کنید. این سادهترین شکل از مرحلهی «اعتبارسنجی» در چارچوب AEVS است.
گام 4: استانداردسازی روی یک آنتولوژی بسته
RELATION_MAP = {
    "is the CEO of": "P169",       # "chief executive officer"
    "was born in":   "P19",         # "place of birth"
    "founded":        "P112",       # "founded by" (inverted subject/object)
    "works at":       "P108",       # "employer"
}


def canonicalize(relation):
    rel_low = relation.lower().strip()
    if rel_low in RELATION_MAP:
        return RELATION_MAP[rel_low]
    return None   # drop unmapped open relations or route to manual review
استانداردسازی معمولاً 60 تا 80 درصد کار مهندسی را به خود اختصاص میدهد؛ حتماً منابع و زمان کافی برای آن کنار بگذارید.
گام 5: ساخت یک گراف کوچک و پرسوجو روی آن
triples = extract(text)
graph = {}
for s, r, o in triples:
    graph.setdefault(s, []).append((r, o))


def neighbors(node, relation=None):
    return [(r, o) for r, o in graph.get(node, []) if relation is None or r == relation]


print(neighbors("Tim Cook", relation="P108"))    # -> [(P108, Apple)]
این بخش، هستهی بنیادین هر سیستم Graph RAG است. این ساختار را میتوانید با پایگاههای سهگانهی RDF (مانند Blazegraph یا Virtuoso)، پایگاههای گراف ویژگیمحور (مثل Neo4j) یا پایگاههای دادهی برداری تلفیقشده با گراف به مقیاسهای بزرگتر برسانید.
دامهای رایج
- مرجعیابی پیش از استخراج رابطه: در جملهی «او اپل را تأسیس کرد»، استخراج رابطه باید بداند منظور از «او» کیست. ابتدا پایپلاین مرجعیابی زنجیرهای (Coreference resolution) را اجرا کنید (درس 24).
- استانداردسازی موجودیتها: «Apple Inc» و «Apple» باید روی یک گره یکسان ادغام شوند. ابتدا پیونددهی موجودیتها را اجرا کنید (درس 25).
- سهگانههای توهمی: LLMها سهگانههایی تولید میکنند که اصلاً در متن نیست. اعتبارسنجی بازههای متنی را اجباری کنید.
- انحراف در استانداردسازی روابط: روابط در روش Open IE یکدست نیستند («متولد شد در»، «اهلِ»، «زادهی»). اگر آنها را به شناسههای یکتا و استاندارد تقلیل ندهید، نمیتوانید روی گراف پرسوجو اجرا کنید.
- خطاهای زمانی: عبارت «تیم کوک مدیرعامل اپل است» الان درست است، ولی در سال 2005 غلط بود. خیلی از روابط محدودیت زمانی دارند. از توصیفگرها (Qualifiers) استفاده کنید (مثل
P580برای زمان شروع وP582برای زمان پایان در Wikidata). - ناهمخوانی دامنهها: مدل REBEL روی دادههای ویکیپدیا آموزش دیده است. متون حقوقی، پزشکی و علمی معمولاً به مدلهای استخراج رابطهای نیاز دارند که روی همان دامنه فاینتیون شده باشند.
کاربرد در دنیای واقعی
استک پیشنهادی سال 2026:
| شرایط | گزینهی انتخابی |
|---|---|
| پروداکشن سریع، دامنهی عمومی | REBEL یا LlamaPred همراه با استانداردسازی بر اساس Wikidata |
| دامنههای خاص (پزشکی، حقوقی) | فاینتیون روی دامنهی خاص مشابه SciREX به همراه آنتولوژی سفارشی |
| استخراج با پرامپت به LLM، با خروجی ممیزیشده | پایپلاین AEVS: مهار ← استخراج ← اعتبارسنجی ← تکمیل |
| پردازش حجم بالای اخبار | ترکیب رویکرد مبتنی بر الگو و مدلهای بانظارت |
| ساخت گراف دانش از صفر | روش Open IE همراه با یک مرحله استانداردسازی دستی |
| گراف دانش وابسته به زمان | استخراج به همراه توصیفگرها (زمان شروع/پایان، مقطع زمانی) |
الگوی یکپارچهسازی: بازشناسی موجودیتها (NER) ← مرجعیابی زنجیرهای ← پیونددهی موجودیتها ← استخراج رابطه ← نگاشت به آنتولوژی ← بارگذاری در گراف. هر یک از این مراحل میتواند یک فیلتر کنترل کیفیت باشد.
ذخیرهی خروجی
این محتوا را در فایل outputs/skill-re-designer.md ذخیره کنید:
---
name: re-designer
description: Design a relation extraction pipeline with provenance and canonicalization.
version: 1.0.0
phase: 5
lesson: 26
tags: [nlp, relation-extraction, knowledge-graph]
---

Given a corpus (domain, language, volume) and downstream use (KG-RAG, analytics, compliance), output:

1. Extractor. Pattern-based / supervised / LLM / AEVS hybrid. Reason tied to precision vs recall target.
2. Ontology. Closed property list (Wikidata / domain) or open IE with canonicalization pass.
3. Provenance. Every triple carries source char-span + doc id. Non-negotiable for audit.
4. Merge strategy. Canonical entity id + relation id + temporal qualifiers; dedup policy.
5. Evaluation. Precision / recall on 200 hand-labelled triples + hallucination-rate on LLM-extracted sample.

Refuse any LLM-based RE pipeline without span verification (source provenance). Refuse open-IE output flowing into a production graph without canonicalization. Flag pipelines with no temporal qualifier on time-bounded relations (employer, spouse, position).تمرینها
- ساده. استخراجکنندهی مبتنی بر الگو در فایل
code/main.pyرا روی 5 جمله از مقالات خبری اجرا کنید. دقت آن را بهصورت دستی بسنجید. - متوسط. از مدل REBEL (یا یک مدل زبانی کوچک) روی همان جملهها استفاده کنید. سهگانهها را مقایسه کنید. کدام مدل دقت بالاتری دارد؟ کدام بازخوانی بیشتری دارد؟
- سخت. پایپلاین AEVS را بسازید: استخراج با LLM + اعتبارسنجی بازههای متنی در برابر متن مبدأ. نرخ توهم را قبل و بعد از مرحلهی اعتبارسنجی روی 50 جملهی مشابه ویکیپدیا اندازه بگیرید.
اصطلاحات کلیدی
| اصطلاح | در گفتار عام | معنای دقیق فنی |
|---|---|---|
| سهگانه (Triple) | نهاد-رابطه-گزاره | تاپل (s, r, o) که واحد سازندهی بنیادین در گراف دانش است. |
| استخراج رابطه باز (Open IE) | استخراج هر چیزی از متن | استفاده از عبارات متنی آزاد برای رابطه؛ بازخوانی بالا، دقت پایین. |
| آنتولوژی بسته (Closed ontology) | اسکیمای ثابت | مجموعهای محدود و مشخص از انواع روابط (مانند Wikidata ،UMLS ،FIBO). |
| استانداردسازی (Canonicalization) | یکدست کردن همهچیز | نگاشت نامهای ظاهری و روابط مختلف به شناسههای یکتا و استاندارد. |
| چارچوب AEVS | استخراج مستند به متن | پایپلاین مهار، استخراج، اعتبارسنجی و تکمیل (Anchor-Extraction-Verification-Supplement، سال 2026). |
| منشأ و سندیت (Provenance) | پیوند به منبع معتبر | اتصال هر سهگانه به شناسه سند و بازهی کاراکتری دقیق آن در متن مبدأ. |
| نظارت غیرمستقیم (Distant supervision) | برچسبگذاری ارزان | تطبیق متن با یک گراف دانش موجود برای تولید خودکار دادههای آموزشی. |
مطالعهی بیشتر
- Mintz et al. (2009). Distant supervision for relation extraction without labeled data — مقالهی مرجع روش نظارت غیرمستقیم.
- Huguet Cabot, Navigli (2021). REBEL: Relation Extraction By End-to-end Language generation — مدل پایه و پرکاربرد استخراج رابطه به شیوهی seq2seq.
- Wadden et al. (2019). Entity, Relation, and Event Extraction with Contextualized Span Representations (DyGIE++) — استخراج توأم اطلاعات.
- AEVS — Anchor-Extraction-Verification-Supplement framework — معماری سال 2026 برای مهار توهم مدلها.
- آموزش SPARQL در Wikidata — پرسوجوی استاندارد روی گرافهای دانش.