
ترجمه ماشینی پایه و انگیزهی اصلی بسیاری از پیشرفتهای بنیادین هوش مصنوعی مدرن، از سازوکارهای اتنشن گرفته تا مدلهای زبانی بزرگ، بوده است. در کاربردهای واقعی، ارائهی ترجمهای که هم ساختار گرامری را حفظ کند و هم اصطلاحات تخصصی دامنه را دستنخورده انتقال دهد، چالش بزرگی است که نیازمند ترکیب دقیق مدلهای زبانی و روشهای کنترل خروجی است.
در این درس پایپلاین کاربردی سال 2026 را بررسی میکنیم؛ از اجرای مدلهای چندزبانه مانند NLLB روی سختافزار استاندارد گرفته تا تکنیکهای جستوجوی پرتو (beam search) و ارزیابی دقیق با معیارهای آماری و عصبی. اگر برای دانلود مدلها از Hugging Face یا نصب بستهها از مخزن PyPI با اختلال یا کندی شبکه روبهرو شدید، استفاده از میرورهای داخلی پایتون روند دانلود را پایدارتر میکند.
مدل سبک معرفیشده در این درس روی CPU یا سیستمهای مجهز به Apple Silicon قابل اجراست و برای شروع نیازی به GPUهای ابری سنگین نخواهید داشت. در پایان، یاد میگیرید چطور خطاهای خاموش در محیط عملیاتی، مانند توهم زبانی یا تغییر ناگهانی لحن، را شناسایی و مهار کنید.
ترجمه همان کاری است که 30 سال هزینهی پژوهشهای پردازش زبان طبیعی (NLP) را تأمین کرد و هنوز هم تأمین میکند.
صورت مسئله
مدل، جملهای را به یک زبان میخواند و جملهای به زبان دیگر تحویل میدهد. طول جملهها یکی نیست؛ ترتیب کلمات فرق دارد؛ گاهی یک کلمه در زبان مبدأ به چند کلمه در مقصد تبدیل میشود و برعکس؛ اصطلاحات هم زیر بار نگاشت یکبهیک نمیروند. مثلاً «I miss you» در فرانسوی میشود «tu me manques»—که تحتاللفظی یعنی «جای تو برای من خالی است». هیچ تطبیق کلمهبهکلمهای نمیتواند چنین ساختاری را تاب بیاورد.
ترجمهی ماشینی (Machine Translation یا MT) همان مسئلهای است که حوزهی NLP را وادار کرد ساختارهای انکودر-دیکودر (encoder-decoder)، اتنشن (attention)، ترنسفورمرها (transformers) و در نهایت کل پارادایم مدلهای زبانی بزرگ (LLM) را خلق کند. هر گام روبهجلویی که برداشته شد، به این دلیل بود که کیفیت ترجمه را میشد اندازه گرفت و فاصلهی ماشین با انسان سرسختانه پابرجا بود.
در این درس از تاریخچه میگذریم و یکراست سراغ پایپلاین کاربردی سال 2026 میرویم: انکودر-دیکودرهای چندزبانهی ازپیشآموزشدیده (NLLB-200 یا mBART)، توکنسازی در سطح زیرکلمه (subword tokenization)، جستوجوی پرتو (beam search)، ارزیابی با BLEU و chrF، و همان چند خطای معروفی که هنوز هم بدون شناسایی به محیط عملیاتی (production) راه پیدا میکنند.
مفاهیم کلیدی
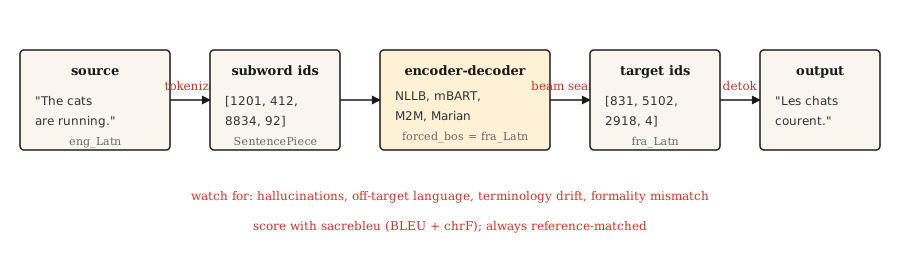
سیستمهای نوین ترجمهی ماشینی بر پایهی ترنسفورمر انکودر-دیکودری ساخته میشوند که روی متنهای موازی آموزش دیده است. انکودر، متن مبدأ را با توکنسازی زبان خودش میخواند. سپس دیکودر خروجی مقصد را زیرکلمه به زیرکلمه و به کمک خروجی انکودر از طریق کراساتنشن (cross-attention؛ درس 10) تولید میکند. برای مرحلهی دیکود از جستوجوی پرتو استفاده میشود تا سیستم در تلهی دیکود حریصانه (greedy decoding) نیفتد. در نهایت متن را توکنزدایی (detokenize) میکنند، بزرگی و کوچکی حروف را به حالت عادی بازمیگردانند (detruecase) و آن را در برابر یک ترجمهی مرجع میسنجند.
کیفیت ترجمهی ماشینی در دنیای واقعی وابسته به سه تصمیم فنی است:
- توکنساز (Tokenizer): الگوریتم SentencePiece BPE که روی پیکرهای چندزبانه آموزش دیده است. دامنهی واژگان مشترک میان زبانها دقیقاً همان عاملی است که امکان ترجمهی جفتزبانهای بدون دادهی قبلی (zero-shot) را در NLLB فراهم میکند.
- اندازهی مدل: مدل NLLB-200 distilled 600M روی لپتاپ جا میشود؛ نسخهی NLLB-200 3.3B گزینهی استاندارد محیطهای عملیاتی است؛ مدل 54.5B نیز مرز پژوهش به حساب میآید.
- روش دیکود: پهنای پرتو (beam width) بین 4 تا 5 برای محتوای عمومی؛ جریمهی طول (length penalty) برای جلوگیری از تولید خروجیهای بیشازحد کوتاه؛ و دیکود مقید (constrained decoding) در زمانهایی که ثبات اصطلاحات تخصصی خط قرمز شماست.
پیادهسازی
گام 1: اجرای یک مدل MT ازپیشآموزشدیده
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM

model_id = "facebook/nllb-200-distilled-600M"
tok = AutoTokenizer.from_pretrained(model_id, src_lang="eng_Latn")
model = AutoModelForSeq2SeqLM.from_pretrained(model_id)

src = "The cats are running."
inputs = tok(src, return_tensors="pt")

out = model.generate(
    **inputs,
    forced_bos_token_id=tok.convert_tokens_to_ids("fra_Latn"),
    num_beams=5,
    length_penalty=1.0,
    max_new_tokens=64,
)
print(tok.batch_decode(out, skip_special_tokens=True)[0])
Les chats courent.سه نکته در این بخش حیاتی است: آرگومان src_lang خط و سبک بخشبندی کلمات را برای توکنساز مشخص میکند؛ مقدار forced_bos_token_id به دیکودر میگوید متن را به چه زبانی تولید کند. این دو مورد از ترفندهای خاص NLLB هستند؛ مدلهایی مثل mBART و M2M-100 روشهای اختصاصی خودشان را دارند و نمیتوانید این تنظیمات را بهجای هم به کار ببرید.
گام 2: معیارهای BLEU و chrF
معیار BLEU همپوشانی n-gramهای خروجی با ترجمهی مرجع را میسنجد: چهار اندازهی n-gram مرجع (1 تا 4)، میانگین هندسی دقتها (precisions) و جریمهی کوتاهی طول برای جلوگیری از خلاصهسازی مفرط خروجی. بازهی امتیاز بین [0, 100] است. این معیار بسیار رایج است اما تفسیر آن خوندل دارد: امتیاز 30 یعنی «کارراهانداز»، 40 یعنی «خوب»، 50 یعنی «فوقالعاده»، و اختلافهای زیر 1 امتیاز در BLEU صرفاً نوفه (noise) هستند.
معیار chrF نمرهی F-score را در سطح کاراکتر محاسبه میکند. این معیار برای زبانهای دارای ساختار صرفی غنی (که در آنها BLEU تطابقها را کمتر از واقعیت در نظر میگیرد) حساستر است و معمولاً کنار BLEU گزارش میشود.
import sacrebleu

hypotheses = ["Les chats courent."]
references = [["Les chats courent."]]

bleu = sacrebleu.corpus_bleu(hypotheses, references)
chrf = sacrebleu.corpus_chrf(hypotheses, references)
print(f"BLEU: {bleu.score:.1f}  chrF: {chrf.score:.1f}")
همیشه از کتابخانهی sacrebleu استفاده کنید. این ابزار شیوهی توکنسازی را استاندارد میکند تا بتوان نمرههای بهدستآمده را میان مقالههای مختلف مقایسه کرد. اگر فرمول محاسبهی BLEU را خودتان بنویسید، راه را برای بنچمارکهای گمراهکننده باز کردهاید.
سلسلهمراتب سهسطحی ارزیابی (سال 2026)
ارزیابی مدرن ترجمهی ماشینی از سه خانوادهی مکمل از معیارها استفاده میکند. در پروژههای واقعی باید دستکم دو مورد از آنها را به کار بگیرید:
- اکتشافی یا هیوریستیک (Heuristic) مانند BLEU و chrF: سریع، مبتنی بر متن مرجع، قابلتفسیر، اما بدون انعطاف در برابر بازنویسیها (paraphrase). از اینها برای مقایسه با مدلهای قدیمی و کشف افت کیفیت (regression) استفاده کنید.
- یادگیریمحور (Learned) مانند COMET، BLEURT و BERTScore: مدلهای عصبی که روی قضاوتهای انسانی آموزش دیدهاند و شباهت معنایی ترجمه را به متن مبدأ و مرجع میسنجند. COMET از سال 2023 بیشترین اعتبار و همبستگی را در پژوهشهای MT داشته و در سال 2026، گزینهی پیشفرض در محیطهای عملیاتی با حساسیت کیفی بالاست.
- مدل زبانی در نقش داور (LLM-as-judge) (بدون نیاز به مرجع): به یک مدل زبانی بزرگ پرامپت میدهید تا روانی، درستی انتقال معنا، لحن و تناسب فرهنگی متن را داوری کند. اگر شیوهنامهی نمرهدهی (rubric) دقیق طراحی شده باشد، قضاوتهای GPT-4 در حدود 80% مواقع با انسان تطابق دارد. این رویکرد را برای متنهای بازی به کار ببرید که هیچ ترجمهی مرجعی برایشان وجود ندارد.
پشتهی ابزارهای کاربردی در سال 2026: استفاده از sacrebleu برای BLEU و chrF، کتابخانهی unbabel-comet برای COMET، و یک LLM پرامپتخورده برای ارزیابی نهایی از زاویهی دید کاربر. پیش از اعتماد به این معیارها روی دادههای پروداکشن، حتماً هر کدام را با 50 تا 100 نمونهی برچسبخوردهی انسانی کالیبره کنید.
معیارهای بدون نیاز به مرجع (شامل COMET-QE، BLEURT-QE و LLM-as-judge) اجازه میدهند ترجمهها را بدون متن مرجع ارزیابی کنید؛ موضوعی که برای جفتزبانهای کمکاربرد (long-tail) که ترجمهی مرجعی ندارند، گرهگشاست.
گام 3: چه مواردی در محیط عملیاتی به مشکل میخورند؟
پایپلاین بالا در 80% مواقع خروجی روان تحویل میدهد، اما در 20% بقیه بیسروصدا خرابکاری میکند. خطاهای شناختهشده عبارتاند از:
- توهم (Hallucination): مدل چیزهایی میبافد که ابداً در متن مبدأ وجود نداشته است. این اتفاق بیشتر در واژگان تخصصی و ناآشنا میافتد. نشانهاش هم این است که خروجی خیلی روان نوشته شده، اما حرفهایی میزند که گوینده نزده است. راهحل: دیکود مقید روی اصطلاحات تخصصی، بازبینی انسانی برای محتواهای حساس و نظارت روی مواردی که طول خروجی بهمراتب بیشتر از ورودی میشود.
- تولید به زبان نادرست (Off-target generation): مدل متن را به زبان اشتباهی برمیگرداند. NLLB در جفتزبانهای نادر بهطرز عجیبی مستعد این اشتباه است. راهحل: کنترل پارامتر
forced_bos_token_idو اجرای حتمی یک مدل تشخیص زبان (language-ID) روی خروجی. - تغییر بیرویهی واژگان تخصصی (Terminology drift): مثلاً عبارت «Sign up» در یک مستند به «ثبتنام» و در مستندی دیگر به «ایجاد حساب کاربری» ترجمه میشود. در متون رابط کاربری (UI) و بخشهای در تماس با کاربر، یکدستی ترجمه حتی از کیفیت خام جملهها مهمتر است. راهحل: دیکود مقید به واژهنامه یا استفاده از فرهنگ لغات برای پسویرایش (post-edit).
- ناهماهنگی در سطح رسمیت (Formality mismatch): مثل کاربرد «تو» در برابر «شما» در فرانسوی و فارسی، یا سطوح مختلف احترام در زبان ژاپنی. مدل هر ساختاری را که در دادههای آموزشیاش فراوانی بیشتری داشته باشد انتخاب میکند؛ چیزی که معمولاً در ارتباط با مشتری توی ذوق میزند. راهحل: اضافه کردن یک توکن رسمیت به ابتدای پرامپت در صورت پشتیبانی مدل، یا فاینتیونینگ یک مدل سبک روی پیکرههای کاملاً رسمی.
- انفجار طول در جملات کوتاه: جملات ورودی بسیار کوتاه معمولاً ترجمههای کشآمده تولید میکنند؛ چرا که جریمهی طول برای ورودیهای کمتر از حدود 5 توکن اثرش را از دست میدهد. راهحل: تعیین سقف سختگیرانه برای حداکثر طول خروجی، متناسب با اندازهی متن مبدأ.
گام 4: فاینتیونینگ برای یک حوزهی تخصصی
مدلهای ازپیشآموزشدیده برای امور عمومی خوبند. برای ترجمهی متون حقوقی، پزشکی یا دیالوگ بازیها، فاینتیونینگ روی دادههای موازی همان دامنه بهبود محسوسی ایجاد میکند. مسیر پیادهسازی هم فرمول عجیبی ندارد:
from transformers import Trainer, TrainingArguments
from datasets import Dataset

pairs = [
    {"src": "The defendant pleaded guilty.", "tgt": "L'accusé a plaidé coupable."},
]

ds = Dataset.from_list(pairs)


def preprocess(ex):
    return tok(
        ex["src"],
        text_target=ex["tgt"],
        truncation=True,
        max_length=128,
        padding="max_length",
    )


ds = ds.map(preprocess, remove_columns=["src", "tgt"])

args = TrainingArguments(output_dir="out", per_device_train_batch_size=4, num_train_epochs=3, learning_rate=3e-5)
Trainer(model=model, args=args, train_dataset=ds).train()
چند هزار نمونهی موازی باکیفیت بر صدها هزار دادهی آلوده و وباسکرپشده پیروز میشود. کیفیت دادههای آموزشی بزرگترین اهرم شما در محیط عملیاتی است.
ابزارهای واقعی
پشتهی ابزارهای پیشنهادی ترجمهی ماشینی در سال 2026:
| مورد کاربرد | گزینهی شروع پیشنهادی |
|---|---|
| هر زبانی به هر زبانی، 200 زبان | مدل facebook/nllb-200-distilled-600M (برای لپتاپ) یا nllb-200-3.3B (برای محیط عملیاتی) |
| محوریت انگلیسی، کیفیت بالا، 50 زبان | مدل facebook/mbart-large-50-many-to-many-mmt |
| پردازشهای کوتاه، استنتاج ارزان، انگلیسی به فرانسوی/آلمانی/اسپانیایی | مدلهای Helsinki-NLP یا Marian |
| حساسیت حیاتی به تأخیر سمت مرورگر | مدل Marian کوانتیزهشده با ONNX (حدود 50 مگابایت) |
| بالاترین کیفیت ممکن بدون دغدغهی هزینه | مدلهای GPT-4 / Claude / Gemini با پرامپتهای تخصصی ترجمه |
از سال 2026 به بعد، مدلهای زبانی بزرگ در چند جفتزبان عملکرد بهتری نسبت به مدلهای تخصصی MT نشان دادهاند، بهویژه در محتواهای اصطلاحی و بافتهای طولانی (long context). نقطهی تعادل کار، هزینهی هر توکن و تأخیر پاسخدهی است. زمانی سراغ LLM بروید که طول بافت، یکدستی لحن یا سازگاری با حوزهی تخصصی از طریق پرامپتنویسی، اهمیتی بیشتر از نرخ پردازش (throughput) داشته باشد.
ارائهی نهایی
کد را در مسیر outputs/skill-mt-evaluator.md ذخیره کنید:
---
name: mt-evaluator
description: Evaluate a machine translation output for shipping.
version: 1.0.0
phase: 5
lesson: 11
tags: [nlp, translation, evaluation]
---

Given a source text and a candidate translation, output:

1. Automatic score estimate. BLEU and chrF ranges you would expect. State whether a reference is available.
2. Five-point human-verifiable check list: (a) content preservation (no hallucinations), (b) correct language, (c) register / formality match, (d) terminology consistency with glossary if provided, (e) no truncation or length explosion.
3. One domain-specific issue to probe. E.g., for legal: named entities and statute citations. For medical: drug names and dosages. For UI: placeholder variables `{name}`.
4. Confidence flag. "Ship" / "Ship with review" / "Do not ship". Tie to the severity of issues found in step 2.

Refuse to ship a translation without a language-ID check on output. Refuse to evaluate without a reference unless the user explicitly opts in to reference-free scoring (COMET-QE, BLEURT-QE). Flag any content over 1000 tokens as likely needing chunked translation.تمرینها
- ساده. با استفاده از
nllb-200-distilled-600Mیک پاراگراف پنججملهای انگلیسی را به فرانسوی و سپس دوباره به انگلیسی ترجمه کنید (ترجمهی رفت و برگشتی). میزان شباهت متن نهایی با نسخهی اصلی را اندازه بگیرید. قاعدتاً باید حفظ معنا در کنار تغییر کلمات انتخابی را مشاهده کنید. - متوسط. با استفاده از
fasttext lid.176یاlangdetectسازوکاری برای تشخیص زبان خروجی بسازید. این ماژول را داخل فراخوانی MT قرار دهید تا خروجیهای دارای زبان اشتباه پیش از بازگشت به کاربر شناسایی شوند. - سخت. مدل
nllb-200-distilled-600Mرا روی یک پیکرهی دامنهی تخصصی 5,000 جفتی به انتخاب خودتان فاینتیون کنید. امتیاز BLEU را روی مجموعهی آزمون جداگانه، قبل و بعد از فاینتیونینگ اندازه بگیرید و گزارش دهید کدام مدل جملات بهبود یافته و کدام افت کردهاند.
اصطلاحات کلیدی
| اصطلاح | در گفتگوها چه میگویند | معنای دقیق فنی |
|---|---|---|
| BLEU | امتیاز ترجمه | دقت n-gram همراه با جریمهی کوتاهی طول؛ در بازهی [0, 100]. |
| chrF | نمرهی F کاراکتری | نمرهی F-score در سطح کاراکتر؛ حساستر برای زبانهای با صرف پیچیده. |
| NMT | ترجمهی ماشینی عصبی | ترنسفورمر انکودر-دیکودر آموزشدیده روی متن موازی؛ روش استاندارد از سال 2017 به بعد. |
| NLLB | پروژهی هیچ زبانی جا نماند | خانوادهی مدلهای MT با پشتیبانی از 200 زبان از شرکت Meta. |
| Constrained decoding | خروجی کنترلشده | اجبار به ظاهر شدن یا نشدن توکنها یا n-gramهای مشخص در متن خروجی. |
| Hallucination | توهم / محتوای ساختگی | خروجیای از مدل که هیچ شواهدی برای آن در متن مبدأ وجود ندارد. |
برای مطالعهی بیشتر
- Costa-jussà et al. (2022). No Language Left Behind: Scaling Human-Centered Machine Translation — مقالهی معرفی NLLB.
- Post (2018). A Call for Clarity in Reporting BLEU Scores — دلایلی که نشان میدهد چرا
sacrebleuتنها روش معتبر برای گزارش نمرات BLEU است. - Popović (2015). chrF: character n-gram F-score for automatic MT evaluation — مقالهی معرفی معیار chrF.
- Hugging Face MT guide — راهنمای عملی برای فاینتیونینگ مدلهای ترجمه.