
در پروژههای عملیاتی، اتکا به پرامپتنویسی صرف برای دریافت JSON معتبر ریسک بالایی دارد. حتی قویترین مدلهای زبانی هم گاهی کلمات اضافی تولید میکنند، ساختار اسکیما را برهم میزنند یا کلیدها را ناقص میبندند؛ خطاهایی که پارسر سیستم را متوقف کرده و خط لولهی پردازش را از کار میاندازند.
رمزگشایی مقید (Constrained Decoding) این مشکل را در لایهی نمونهبرداری حل میکند. با محدود کردن لاجیتها در هر گام تولید، مدل اساساً اجازه ندارد توکنی نامعتبر یا خارج از فرمت مشخصشده تولید کند؛ در نتیجه اعتبارسنجی خروجی از یک احتمال به یک قطعیت ساختاری تبدیل میشود.
برای توسعهدهندگانی که به دلیل چالشهای پرداخت ارزی یا محدودیتهای دسترسی به سرویسهای ابری خارجی به اجرای مدلهای متنباز محلی روی آوردهاند، پیادهسازی این ابزارها مثل Outlines و vLLM روی سیستم شخصی یا سرورهای محلی، نیاز به APIهای اختصاصی و گرانقیمت را بهطور کامل از بین میبرد.
از مدل زبانی (LLM) بخواهید خروجی JSON بدهد؛ در بیشتر مواقع JSON تحویل میگیرید. اما در محیط پروداکشن، همین کلمهی «بیشتر» فاجعه میآفریند. رمزگشایی مقید (Constrained decoding) با دستکاری لاجیتها قبل از نمونهبرداری، «بیشتر مواقع» را به «همیشه» تبدیل میکند.
صورت مسئله
یک سیستم دستهبندی به مدل پرامپت میدهد: «یکی از گزینههای {positive, negative, neutral} را برگردان.» مدل در پاسخ مینویسد: «The sentiment is positive — this review is overwhelmingly favorable because the customer explicitly states that they ...». پارسر برنامه کرش میکند و معیار F1 دستهبندی به 0.0 میرسد.
تولید متن آزاد (Free-form generation) یک قرارداد معتبر نیست؛ صرفاً یک پیشنهاد است. یک سیستم عملیاتی به یک قرارداد محکم نیاز دارد.
در سال 2026، سه لایهی راهکار پیش رو دارید:
- پرامپتنویسی (Prompting): خواهش محترمانه از مدل؛ «فقط شیء JSON را خروجی بده.» این روش در مدلهای پیشرو حدود 80% جواب میدهد و در مدلهای کوچکتر حتی کمتر.
- APIهای بومی خروجی ساختاریافته (Native structured output APIs): قابلیت
response_formatدر OpenAI، ابزارهای Anthropic (Tool use) و حالت JSON Mode در Gemini. این روش روی اسکیماهای پشتیبانیشده کاملاً مطمئن است، اما وابستگی به سرویسدهنده (Vendor lock-in) ایجاد میکند. - رمزگشایی مقید (Constrained decoding): دستکاری لاجیتها در تکتک گامهای تولید، بهطوری که مدل از نظر ساختاری نتواند توکنهای نامعتبر تولید کند. خروجی بنا به تعریف و ساختار، 100% معتبر است و روی تمام مدلهای محلی کار میکند.
در این درس، درک شهودی از هر سه روش پیدا میکنید و یاد میگیرید در هر موقعیت دقیقاً سراغ کدام بروید.
مبانی نظری
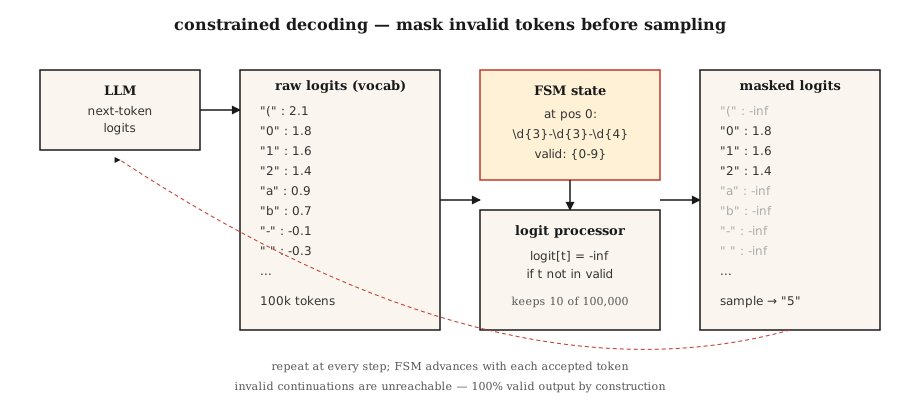
رمزگشایی مقید چگونه کار میکند؟ در هر گام از تولید متن، مدل زبانی یک بردار لاجیت روی کل واژگان (~100k توکن) تولید میکند. یک پردازندهی لاجیت (Logit processor) بین مدل و نمونهبردار (Sampler) مینشیند. این پردازنده با توجه به جایگاه فعلی در گرامر هدف — مثل JSON Schema، رجکس (Regex) یا گرامر مستقل از متن (CFG) — مشخص میکند کدام توکنها مجازند و لاجیت سایر توکنهای نامعتبر را به منفی بینهایت تغییر میدهد. سپس تابع سافتمکس روی لاجیتهای باقیمانده اعمال میشود و تمام جرم احتمال، فقط به ادامههای مجاز اختصاص مییابد.
پیادهسازیهای مطرح در سال 2026:
- Outlines: اسکیماهای JSON یا Regex را به یک ماشین حالت متناهی (FSM) کامپایل میکند. جستوجوی توکن مجاز بعدی در هر مرحله با پیچیدگی زمانی انجام میشود. به دلیل مبتنی بودن بر FSM، اسکیماهای بازگشتی باید مسطح (Flatten) شوند.
- XGrammar / llguidance: موتورهای گرامر مستقل از متن (Context-free grammar). این موتورها اسکیماهای بازگشتی JSON را مدیریت میکنند و سربار رمزگشایی آنها نزدیک به صفر است. OpenAI در پیادهسازی قابلیت خروجیهای ساختاریافتهی سال 2025 خود از llguidance تقدیر کرد.
- رمزگشایی هدایتشده در vLLM (Guided decoding): پشتیبانی داخلی از
guided_json،guided_regex،guided_choiceوguided_grammarاز طریق بکاندهای Outlines، XGrammar یا lm-format-enforcer. - Instructor: پوستهای مبتنی بر Pydantic روی هر مدل زبانی. در صورت خطای اعتبارسنجی، مجدداً تلاش (Retry) میکند. مستقل از سرویسدهنده است، اما لاجیتها را تغییر نمیدهد؛ بلکه بر تکرار پرامپتهای آگاه از ساختار تکیه دارد.
نتیجهای دور از انتظار
رمزگشایی مقید اغلب سریعتر از تولید متن آزاد عمل میکند؛ به دو دلیل: اول اینکه فضای جستوجوی توکن بعدی را کوچکتر میکند. دوم اینکه پیادهسازیهای هوشمند، تولید توکن را برای توکنهای اجباری بهطور کامل دور میزنند (قالبهایی مثل {"name": " که تکتک بایتهای آن از پیش قطعی است).
خطای پرهزینهای که غافلگیرتان میکند
ترتیب فیلدها در اسکیما حیاتی است. اگر فیلد answer را قبل از reasoning بگذارید، مدل قبل از استدلال و فکر کردن، روی یک پاسخ commit میکند. خروجی یک JSON معتبر است، اما پاسخی که داده غلط از آب درمیآید؛ هیچ اعتبارسنجیای هم این خطا را شناسایی نمیکند.
// BAD
{"answer": "yes", "reasoning": "because ..."}

// GOOD
{"reasoning": "... therefore ...", "answer": "yes"}
ترتیب فیلدهای اسکیما جزو منطق برنامه است، نه فرمتبندی ظاهری.
پیادهسازی
گام 1: تولید مقید با Regex از صفر
برای مشاهدهی یک پیادهسازی کامل و مستقل از FSM به فایل code/main.py مراجعه کنید. ایدهی اصلی در 30 خط خلاصه شده است:
def mask_logits(logits, valid_token_ids):
    mask = [float("-inf")] * len(logits)
    for tid in valid_token_ids:
        mask[tid] = logits[tid]
    return mask


def generate_constrained(model, tokenizer, prompt, fsm):
    ids = tokenizer.encode(prompt)
    state = fsm.initial_state
    while not fsm.is_accept(state):
        logits = model.next_token_logits(ids)
        valid = fsm.valid_tokens(state, tokenizer)
        logits = mask_logits(logits, valid)
        tok = sample(logits)
        ids.append(tok)
        state = fsm.transition(state, tok)
    return tokenizer.decode(ids)
ماشین حالت مشخص میکند که تاکنون کدام بخشهای گرامر تکمیل شدهاند. تابع valid_tokens(state, tokenizer) محاسبه میکند کدام توکنهای واژگان میتوانند وضعیت FSM را بدون خروج از مسیر مجاز به جلو ببرند.
گام 2: استفاده از Outlines برای JSON Schema
from pydantic import BaseModel
from typing import Literal
import outlines


class Review(BaseModel):
    sentiment: Literal["positive", "negative", "neutral"]
    confidence: float
    evidence_span: str


model = outlines.models.transformers("meta-llama/Llama-3.2-3B-Instruct")
generator = outlines.generate.json(model, Review)

result = generator("Classify: 'The wait staff was attentive and the food arrived hot.'")
print(result)
# Review(sentiment='positive', confidence=0.93, evidence_span='attentive ... hot')
نرخ خطای اعتبارسنجی: دقیقاً صفر، برای همیشه. ساختار FSM رسیدن به خروجی نامعتبر را غیرممکن میکند.
گام 3: کتابخانهی Instructor برای Pydantic مستقل از سرویسدهنده
import instructor
from anthropic import Anthropic
from pydantic import BaseModel, Field


class Invoice(BaseModel):
    vendor: str
    total_usd: float = Field(ge=0)
    line_items: list[str]


client = instructor.from_anthropic(Anthropic())
invoice = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=1024,
    response_model=Invoice,
    messages=[{"role": "user", "content": "Extract from: 'Acme Corp $420. Widget, Gizmo.'"}],
)
مکانیسم این روش کاملاً فرق دارد. Instructor به لاجیتها دست نمیزند؛ بلکه اسکیما را وارد پرامپت میکند، خروجی را پارس میکند و در صورت شکست اعتبارسنجی، درخواست را مجدداً میفرستد (بهطور پیشفرض 3 بار). این روش روی تمامی ارائهدهندگان جواب میدهد، اما تلاشهای مجدد هزینه و تأخیر (Latency) بیشتری دارند. مزیت اصلی آن، جابهجاییپذیری میان سرویسدهندههای مختلف است.
گام 4: APIهای بومی سرویسدهندهها
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-5",
    input=[{"role": "user", "content": "Classify: 'The food was cold.'"}],
    text={"format": {"type": "json_schema", "name": "sentiment",
          "schema": {"type": "object", "required": ["sentiment"],
                     "properties": {"sentiment": {"type": "string",
                                                  "enum": ["positive", "negative", "neutral"]}}}}},
)
print(response.output_parsed)
این فرایند، رمزگشایی مقید سمت سرور است و برای اسکیماهای پشتیبانیشده، دقتی همسطح Outlines دارد. نیازی به مدیریت مدل محلی ندارید، اما کاملاً به سرویسدهنده وابسته میشوید.
دامها
- اسکیماهای بازگشتی (Recursive schemas): کتابخانهی Outlines بازگشت را تا عمق ثابتی مسطح میکند. برای خروجیهای درختی (کامنتهای تو در تو، AST) باید از XGrammar یا llguidance (مبتنی بر CFG) استفاده کنید.
- Enumهای بسیار بزرگ: تعریف یک Enum با 10,000 گزینه سرعت کامپایل را بهشدت میکاهد یا با خطای اتمام زمان (Timeout) مواجه میشود. در این سناریو به سراغ رتریور (Retriever) بروید: ابتدا k گزینهی برتر را بیابید و سپس مدل را فقط به همانها محدود کنید.
- گرامر بیش از حد سختگیرانه: اگر فرمت تاریخ را با رجکس
date: "YYYY-MM-DD"اجباری کنید، مدل در نبود تاریخ نمیتواند مقداری مثل"unknown"خروجی دهد. در نتیجه برای جبران، تاریخی ساختگی سرهم میکند. همیشه امکان ارسالnullیا یک مقدار نشانگر (Sentinel) در نظر بگیرید. - commit زودهنگام: به دام ترتیب فیلدها در بالا توجه کنید؛ همیشه فیلد استدلال را قبل از پاسخ بگذارید.
- JSON mode سرویسدهنده بدون اسکیما: این قابلیت فقط درست بودن سینتکس JSON را تضمین میکند، نه معتبر بودن آن را برای سناریوی شما. حتماً اسکیمای کامل را تحویل مدل بدهید.
کاربرد عملی
پشتهی انتخابی در سال 2026:
| موقعیت | ابزار انتخابی |
|---|---|
| مدلهای OpenAI/Anthropic/Google با اسکیمای ساده | خروجی ساختاریافتهی بومی سرویسدهنده |
| هر سرویسدهندهای با جریان کاری Pydantic و امکان پذیرش تلاش مجدد | Instructor |
| مدل محلی، نیاز به اعتبار 100% و اسکیمای مسطح | Outlines (FSM) |
| مدل محلی با اسکیمای بازگشتی | XGrammar یا llguidance |
| سرور استنتاج اختصاصی (Self-hosted) | رمزگشایی هدایتشده در vLLM |
| پردازش دستهای داده با پذیرش تلاش مجدد | Instructor به همراه ارزانترین مدل ممکن |
اجرا و ذخیره
این راهنما را در مسیر outputs/skill-structured-output-picker.md ذخیره کنید:
---
name: structured-output-picker
description: Choose a structured output approach, schema design, and validation plan.
version: 1.0.0
phase: 5
lesson: 20
tags: [nlp, llm, structured-output]
---

Given a use case (provider, latency budget, schema complexity, failure tolerance), output:

1. Mechanism. Native vendor structured output, Instructor retries, Outlines FSM, or XGrammar CFG. One-sentence reason.
2. Schema design. Field order (reasoning first, answer last), nullable fields for "unknown", enum vs regex, required fields.
3. Failure strategy. Max retries, fallback model, graceful `null` handling, out-of-distribution refusal.
4. Validation plan. Schema compliance rate (target 100%), semantic validity (LLM-judge), field-coverage rate, latency p50/p99.

Refuse any design that puts `answer` or `decision` before reasoning fields. Refuse to use bare JSON mode without a schema. Flag recursive schemas behind an FSM-only library.تمرینها
- ساده: به یک مدل وزنباز کوچک (مثل Llama-3.2-3B) بدون رمزگشایی مقید برای
Review(sentiment, confidence, evidence_span)پرامپت بدهید. روی 100 نظر بررسی کنید چه کسری از خروجیها به عنوان JSON معتبر پارس میشوند. - متوسط: همان مجموعه داده را با JSON mode کتابخانهی Outlines اجرا کنید. درصد انطباق با اسکیما، میزان تأخیر و دقت معنایی پاسخها را بسنجید و مقایسه کنید.
- پیشرفته: یک رمزگشای مقید با رجکس را از صفر برای شمارههای تماس (
\d{3}-\d{3}-\d{4}) پیادهسازی کنید. روی 1000 نمونه مطمئن شوید که 0 خروجی نامعتبر تولید میشود.
اصطلاحات کلیدی
| اصطلاح | در گفتار عامیانه | معنای دقیق فنی |
|---|---|---|
| Constrained decoding | اجبار به خروجی معتبر | ماسک کردن لاجیتهای توکنهای نامعتبر در هر گام تولید متن. |
| Logit processor | عاملی که محدودیت میگذارد | تابعی با ساختار: (logits, state) -> masked_logits. |
| FSM | ماشین حالت متناهی | نمایش کامپایلشدهی گرامر با جستوجوی توکن مجاز بعدی در زمان . |
| CFG | گرامر مستقل از متن | گرامری با قابلیت مدیریت ساختارهای بازگشتی؛ کندتر اما رساتر از FSM. |
| Schema field order | آیا ترتیب فیلدها مهم است؟ | بله؛ فیلد اول پاسخ را commit میکند. همیشه استدلال را قبل از پاسخ بگذارید. |
| Guided decoding | نام انتخابی vLLM برای این مفهوم | همان مفهوم، پیادهسازیشده در دل سرور استنتاج. |
| JSON mode | نسخهی اولیهی OpenAI | فقط سینتکس JSON را تضمین میکند؛ تطابق با اسکیما را تضمین نمیکند. |
برای مطالعهی بیشتر
- Willard, Louf (2023). Efficient Guided Generation for LLMs — مقالهی مرجع Outlines.
- XGrammar paper (2024) — رمزگشایی مقید سریع بر پایهی CFG.
- vLLM — Structured Outputs — یکپارچهسازی در سرور استنتاج.
- OpenAI — Structured Outputs guide — راهنمای API و نکات ظریف آن.
- Instructor library — ترکیب Pydantic و تلاش مجدد میان ارائهدهندگان مختلف.
- JSONSchemaBench (2025) — بنچمارک 6 فریمورک رمزگشایی مقید.