
بسیاری از توسعهدهندگان هنگام ساخت سامانههای RAG، افت کیفیت بازیابی را به مدل امبدینگ نسبت میدهند و هزینهی زیادی صرف تعویض مدل میکنند؛ در حالی که ریشهی مشکل اغلب در نحوهی قطعهبندی متن (Chunking) نهفته است. اگر اسناد به شکلی بریده شوند که پیوستگی جملات یا بافت موضوعی از دست برود، دقیقترین مدلهای جستجو نیز پاسخ نامربوط برمیگردانند.
در خط لولههای محلی و سازمانی RAG، انتخاب استراتژی نامناسب مثل استفاده از همپوشانیهای بیهدف یا قطعهبندیهای صرفاً معناییِ کنترلنشده، حجم بردارها و محاسبات را بدون ارتقای دقت دوبرابر میکند. شناخت نقاط قوت و ضعف روشهای مختلف به شما اجازه میدهد پیش از ارسال متن به مدلهای زبانی، خروجی بازیاب را بهینه کنید.
در این درس شش الگوی قطعهبندی شامل روشهای ثابت، بازگشتی (Recursive)، معنایی (Semantic)، سند والد (Parent-document)، متأخر (Late chunking) و بافتمحور (Contextual retrieval) را پیادهسازی و مقایسه میکنیم تا متناسب با نوع پرسشها بهترین معماری را انتخاب کنید.
پیکربندی قطعهبندی (chunking) به اندازهی انتخاب مدل امبدینگ (embedding) بر کیفیت بازیابی اثر میگذارد (Vectara NAACL 2025). اگر قطعهبندی را اشتباه انجام دهید، هیچ مقداری از بازرتبهبندی نجاتتان نخواهد داد.
صورت مسئله
یک قرارداد 50 صفحهای را به سیستم RAG میدهید. کاربر میپرسد: «بند فسخ قرارداد چیست؟» بخش بازیاب (retriever) صفحهی جلد را برمیگرداند. چرا؟ چون مدل روی تکههای 512 توکنی آموزش دیده است، در حالی که بند فسخ در صفحهی 20 قرار دارد، وسط یک شکست صفحهبندی نصف شده و هیچ کلیدواژهی محلی خاصی هم برای پیوند دادنش به پرسش کاربر وجود ندارد.
راهحل این نیست که «یک مدل امبدینگ بهتر بخرید». راهحل در قطعهبندی است: اندازهی هر قطعه چقدر باشد؟ همپوشانی (overlap) داشته باشد یا نه؟ متن را از کجا برش بزنیم؟ با بافت متنی (context) پیرامونی همراه باشد؟
بنچمارکهای فوریه 2026 نتایج غافلگیرکنندهای نشان میدهند:
- پژوهش سال 2026 شرکت Vectara: قطعهبندی بازگشتی (recursive) با قطعات 512 توکنی توانست قطعهبندی معنایی (semantic chunking) را با دقت 69% در برابر 54% شکست دهد.
- ترکیب SPLADE با Mistral-8B روی Natural Questions: همپوشانی هیچ مزیت قابلاندازهگیری خاصی ایجاد نکرد.
- پرتگاه بافت (Context cliff): کیفیت پاسخ در حوالی 2500 توکن بافت متنی ناگهان سقوط میکند.
پاسخی که در نگاه اول «بدیهی» به نظر میرسد (قطعهبندی معنایی، 20% همپوشانی، قطعات 1000 توکنی) اغلب اشتباه از آب درمیآید. این درس شهود لازم برای کار با شش استراتژی مختلف را به شما میدهد و مشخص میکند در هر سناریو باید سراغ کدام بروید.
مبانی نظری
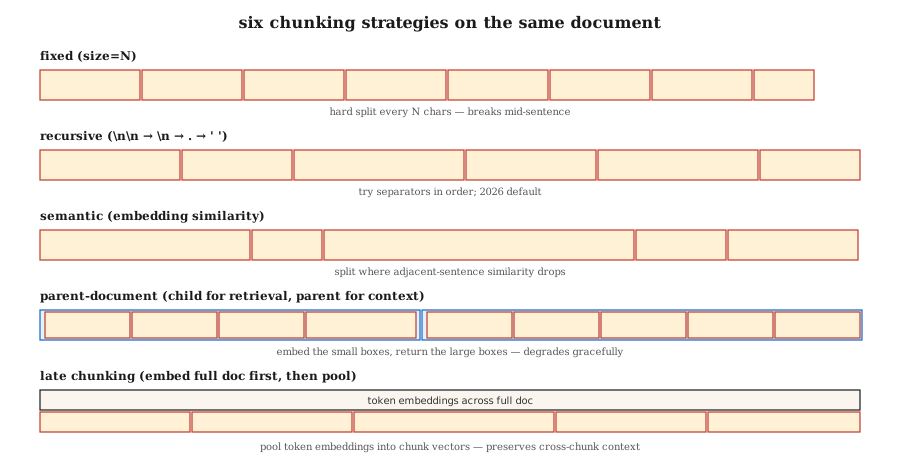
قطعهبندی ثابت (Fixed chunking). برش متن دقیقاً بعد از هر N نویسه یا توکن؛ سادهترین خط پایه (baseline) ممکن است. جملات را از وسط قطع میکند؛ فشردهسازی خوبی دارد، اما پیوستگی متنی آن ضعیف است.
بازگشتی (Recursive). کلاس RecursiveCharacterTextSplitter در LangChain؛ ابتدا تلاش میکند متن را از \n\n، سپس \n، بعد نقطه و در نهایت از فاصله جدا کند. اگر جداکنندهی اول جواب نداد، تمیز به سراغ گزینهی بعدی میرود. این روش، گزینهی پیشفرض سال 2026 است.
معنایی (Semantic). هر جمله امبد میشود. سپس شباهت کسینوسی میان جملات مجاور را حساب میکنیم. هر جا شباهت از یک آستانه کمتر شد، متن برش میخورد. این روش انسجام موضوعی را حفظ میکند اما کندتر است؛ گاهی هم تکههای بندانگشتیِ 40 توکنی میسازد که به کیفیت بازیابی ضربه میزنند.
جملهای (Sentence). برش دقیقاً بر اساس مرزهای جمله انجام میشود؛ یا یک جمله در هر قطعه، یا پنجرهای شامل N جمله. با کسری از هزینهی قطعهبندی معنایی، تا حدود 5000 توکن کیفیتی همپای آن ارائه میدهد.
سند والد (Parent-document). تکههای کوچکِ فرزندی را برای بازیابی ذخیره میکنید و تکهی بزرگترِ والد را برای بافت متنی نگه میدارید. جستجو با فرزند انجام میشود، اما والد برمیگردد. مزیتش تنزل نرم (graceful degradation) است: حتی اگر تکههای فرزند کیفیت پایینی داشته باشند، والدِ بازیابیشده همچنان بافت متنی معقولی دارد.
قطعهبندی متأخر (Late chunking - 2024). ابتدا کل سند در سطح توکن امبد میشود، سپس امبدینگهای توکنها با ادغام (pooling) به امبدینگهای قطعات تبدیل میشوند. به این ترتیب بافت متنی میان قطعات کاملاً حفظ میشود. این روش با مدلهای امبدینگِ پنجرهبلند (نظیر BGE-M3 یا Jina v3) کار میکند و بار محاسباتی بالاتری دارد.
بازیابی بافتمحور (Contextual retrieval - Anthropic, 2024). در ابتدای هر قطعه، خلاصهای قرار میگیرد که مدل زبانی از موقعیت آن قطعه در کل سند تولید کرده است («این قطعه مربوط به بخش 3.2 از بندهای فسخ قرارداد است...»). این تکنیک در بنچمارک اختصاصی Anthropic بین 35 تا 50 درصد بهبود در بازیابی نشان داده است، هرچند ایندکس کردن را پرهزینه میکند.
قاعدهای که تمام گزینههای پیشفرض را پشت سر میگذارد
اندازهی هر قطعه را با نوع پرسش تطبیق دهید:
| نوع پرسش | اندازهی قطعه |
|---|---|
| فکتمحور («نام مدیرعامل چیست؟») | 256-512 توکن |
| تحلیلی / چندمرحلهای (multi-hop) | 512-1024 توکن |
| کامپریهنشن یک بخش کامل | 1024-2048 توکن |
طبق بنچمارک سال 2026 انویدیا: قطعه باید آنقدر بزرگ باشد که پاسخ و بافت متنی اطرافش را در بر بگیرد، و آنقدر کوچک باشد که نتایج برتر بازیاب (top-K) بهجای نویزِ بافت متنی اضافی، روی خود پاسخ متمرکز بمانند.
پیادهسازی
گام 1: قطعهبندی ثابت و بازگشتی
def chunk_fixed(text, size=512, overlap=0):
    step = size - overlap
    return [text[i:i + size] for i in range(0, len(text), step)]


def chunk_recursive(text, size=512, seps=("\n\n", "\n", ". ", " ")):
    if len(text) <= size:
        return [text]
    for sep in seps:
        if sep not in text:
            continue
        parts = text.split(sep)
        chunks = []
        buf = ""
        for p in parts:
            if len(p) > size:
                if buf:
                    chunks.append(buf)
                    buf = ""
                chunks.extend(chunk_recursive(p, size=size, seps=seps[1:] or (" ",)))
                continue
            candidate = buf + sep + p if buf else p
            if len(candidate) <= size:
                buf = candidate
            else:
                if buf:
                    chunks.append(buf)
                buf = p
        if buf:
            chunks.append(buf)
        return [c for c in chunks if c.strip()]
    return chunk_fixed(text, size)
گام 2: قطعهبندی معنایی
def chunk_semantic(text, encoder, threshold=0.6, min_chars=200, max_chars=2048):
    sentences = split_sentences(text)
    if not sentences:
        return []
    embs = encoder.encode(sentences, normalize_embeddings=True)
    chunks = [[sentences[0]]]
    for i in range(1, len(sentences)):
        sim = float(embs[i] @ embs[i - 1])
        current_len = sum(len(s) for s in chunks[-1])
        if sim < threshold and current_len >= min_chars:
            chunks.append([sentences[i]])
        else:
            chunks[-1].append(sentences[i])

    result = []
    for group in chunks:
        text_group = " ".join(group)
        if len(text_group) > max_chars:
            result.extend(chunk_recursive(text_group, size=max_chars))
        else:
            result.append(text_group)
    return result
مقدار threshold را متناسب با حوزهی کاری خود تنظیم کنید. اگر خیلی بالا باشد قطعات بیش از حد خرد میشوند و اگر خیلی پایین باشد کل متن به یک قطعهی غولپیکر تبدیل خواهد شد.
گام 3: سند والد
def chunk_parent_child(text, parent_size=2048, child_size=256):
    parents = chunk_recursive(text, size=parent_size)
    mapping = []
    for p_idx, parent in enumerate(parents):
        children = chunk_recursive(parent, size=child_size)
        for child in children:
            mapping.append({"child": child, "parent_idx": p_idx, "parent": parent})
    return mapping


def retrieve_parent(child_query, mapping, encoder, top_k=3):
    child_embs = encoder.encode([m["child"] for m in mapping], normalize_embeddings=True)
    q_emb = encoder.encode([child_query], normalize_embeddings=True)[0]
    scores = child_embs @ q_emb
    top = np.argsort(-scores)[:top_k]
    seen, parents = set(), []
    for i in top:
        if mapping[i]["parent_idx"] not in seen:
            parents.append(mapping[i]["parent"])
            seen.add(mapping[i]["parent_idx"])
return parentsنکتهی کلیدی: قطعات والد تکراری را حذف کنید (dedupe). چند قطعهی فرزند ممکن است به یک والد اشاره داشته باشند؛ اگر همهی آنها را برگردانید بافت متنی هدر میرود.
گام 4: بازیابی بافتمحور (الگوی Anthropic)
def contextualize_chunks(document, chunks, llm):
    context_prompts = [
        f"""<document>{document}</document>
Here is the chunk to situate: <chunk>{c}</chunk>
Write 50-100 words placing this chunk in the document's context."""
        for c in chunks
    ]
    contexts = llm.batch(context_prompts)
    return [f"{ctx}\n\n{c}" for ctx, c in zip(contexts, chunks)]
قطعات غنیشده با بافت را ایندکس کنید. هنگام جستجو، فرایند بازیابی از این نشانههای زمینهای اضافه نفع زیادی میبرد.
گام 5: ارزیابی
def recall_at_k(queries, corpus_chunks, encoder, k=5):
    chunk_embs = encoder.encode(corpus_chunks, normalize_embeddings=True)
    hits = 0
    for q_text, gold_idxs in queries:
        q_emb = encoder.encode([q_text], normalize_embeddings=True)[0]
        top = np.argsort(-(chunk_embs @ q_emb))[:k]
        if any(i in gold_idxs for i in top):
            hits += 1
    return hits / len(queries)
همیشه ارزیابی و بنچمارک انجام دهید. «بهترین» استراتژی برای مجموعهدادهی شما ممکن است با هیچ پست وبلاگی نخواند.
دامهای رایج
- ارزیابی قطعهبندی صرفاً با پرسشهای فکتمحور. پرسشهای چندمرحلهای برندگان کاملاً متفاوتی را رو میکنند. حتماً از یک مجموعهی ارزیابی لایهبندیشده بر اساس نوع پرسش استفاده کنید.
- قطعهبندی معنایی بدون تعیین حداقل اندازه. این کار باعث تولید تکههای 40 توکنی میشود که بازیابی را خراب میکنند. همیشه
min_tokensرا اعمال کنید. - استفاده از همپوشانی بدون توجیه فنی (cargo cult). بررسیهای سال 2026 نشان میدهند که همپوشانی اغلب هیچ مزیتی ندارد و فقط هزینهی ایندکس را دوبرابر میکند. اندازه بگیرید؛ حدس نزنید.
- اعمال نکردن حداقل و حداکثر طول. قطعات 5 توکنی یا 5000 توکنی، هر دو فرایند بازیابی را مختل میکنند. طول را مهار (clamp) کنید.
- قطعهبندی بینسندی. هرگز اجازه ندهید یک قطعه روی دو سند مختلف کشیده شود. همیشه ابتدا هر سند را جداگانه قطعهبندی و سپس نتایج را merge کنید.
کاربرد در عمل
استک سال 2026:
| موقعیت | استراتژی |
|---|---|
| شروع پروژه، مجموعهدادهی ناشناخته | بازگشتی، 512 توکن، بدون همپوشانی |
| پرسش و پاسخ فکتمحور | بازگشتی، 256-512 توکن |
| تحلیلی / چندمرحلهای | بازگشتی، 512-1024 توکن + سند والد |
| ارجاعات متقابل سنگین (قراردادها، مقالات) | قطعهبندی متأخر یا بازیابی بافتمحور |
| دادههای مکالمهای و گفتگو | قطعات بر اساس نوبت گفتگو (turn-level) + متادیتای گوینده |
| عبارات کوتاه (توییتها، نظرات کاربران) | هر سند = یک قطعه |
کار را با روش بازگشتی 512 شروع کنید. معیار recall@5 را روی یک مجموعهی ارزیابی 50 پرسشی بسنجید و سپس بر اساس آن بهینهسازی کنید.
تحویل نهایی
کد را در فایل outputs/skill-chunker.md ذخیره کنید:
---
name: chunker
description: Pick a chunking strategy, size, and overlap for a given corpus and query distribution.
version: 1.0.0
phase: 5
lesson: 23
tags: [nlp, rag, chunking]
---

Given a corpus (document types, avg length, domain) and query distribution (factoid / analytical / multi-hop), output:

1. Strategy. Recursive / sentence / semantic / parent-document / late / contextual. Reason.
2. Chunk size. Token count. Reason tied to query type.
3. Overlap. Default 0; justify if >0.
4. Min/max enforcement. `min_tokens`, `max_tokens` guards.
5. Evaluation plan. Recall@5 on 50-query stratified eval set (factoid, analytical, multi-hop).

Refuse any chunking strategy without min/max chunk size enforcement. Refuse overlap above 20% without an ablation showing it helps. Flag semantic chunking recommendations without a min-token floor.تمرینها
- ساده. یک سند 20 صفحهای را با سه حالت fixed(512, 0)، recursive(512, 0) و recursive(512, 100) قطعهبندی کنید. تعداد قطعهها و کیفیت برش در مرزها را مقایسه کنید.
- متوسط. یک مجموعهی ارزیابی 30 پرسشی روی 5 سند بسازید. بازخوانی در 5 رتبه اول (recall@5) را برای روشهای بازگشتی، معنایی و سند والد اندازه بگیرید. کدام روش برنده شد؟ آیا با ادعای وبلاگها همخوانی دارد؟
- سخت. بازیابی بافتمحور را پیاده کنید. میزان بهبود معیار MRR را نسبت به روش پایهی بازگشتی بسنجید. نسبت هزینهی ایندکس (فراخوانی LLM) به افزایش دقت را گزارش دهید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوهای عامیانه | معنای واقعی |
|---|---|---|
| قطعه (Chunk) | تکهای از سند | واحدی از زیرسند که امبد، ایندکس و بازیابی میشود. |
| همپوشانی (Overlap) | حاشیهی اطمینان | تعداد N توکن مشترک میان قطعات مجاور؛ در بنچمارکهای 2026 اغلب بیفایده بوده است. |
| قطعهبندی معنایی | برش هوشمند | جداسازی متن در نقطهای که شباهت امبدینگِ جملات متوالی افت میکند. |
| سند والد | بازیابی دو سطحی | بازیابی تکههای کوچک فرزند و برگرداندن قطعات بزرگتر والد. |
| قطعهبندی متأخر | قطعهبندی بعد از امبدینگ | امبد کردن کل سند در سطح توکن و سپس تجمیع آنها در قالب امبدینگهای قطعات. |
| بازیابی بافتمحور | ترفند Anthropic | خلاصهی تولیدشده توسط مدل زبانی که قبل از ایندکس به ابتدای هر قطعه اضافه میشود. |
| پرتگاه بافت | دیوار 2500 توکنی | افت شدید کیفیت پاسخ در سیستمهای RAG وقتی بافت متنی به حدود 2500 توکن میرسد (ژانویهی 2026). |
منابع بیشتر
- مستندات Recursive Character Splitting در LangChain / Yepes et al. — گزینهی پیشفرض در محیطهای پروداکشن.
- پژوهش وکتارا (2024, NAACL 2025) پیرامون تحلیل پیکربندیهای قطعهبندی — نشان میدهد اهمیت قطعهبندی به اندازهی انتخاب مدل امبدینگ است.
- مقالهی Jina AI درباره Late Chunking در مدلهای امبدینگ با پنجرهی بلند (2024) — مقالهی مرجع روش قطعهبندی متأخر.
- مستندات Contextual Retrieval در Anthropic — بهبود 35 تا 50 درصدی بازیابی با استفاده از پیشوندهای متنی تولیدشده توسط مدل زبانی.
- بنچمارک اندازهی قطعه انویدیا در سال 2026 — خلاصهی Premai — راهنمای انتخاب اندازهی قطعه بر اساس نوع پرسش.