
مدلهای بازشناسی موجودیتهای نامدار (NER) میتوانند کلماتی مثل «Jordan» یا «Paris» را در متن پیدا و دستهبندی کنند، اما مشخص نمیکنند که منظور دقیقاً کدام شخص یا کدام شهر است. این ابهام باعث میشود اطلاعات استخراجشده برای ساخت گراف دانش، سیستمهای پرسشوپاسخ و پایگاههای داده کاربرد دقیقی نداشته باشند.
پیونددهی موجودیتها (Entity Linking) این مسئله را حل میکند؛ با شناسایی کاندیداهای ممکن و تحلیل بافت جمله، هر اشاره را به یک شناسه و مدخل منحصربهفرد در پایگاه دانش (مانند ویکیپدیا، ویکیداده یا بانک اطلاعات سازمانی) متصل میکند. در این درس با دو گام اصلی این فرایند، یعنی تولید کاندیداها و ابهامزدایی، و پیادهسازی روشهای مختلف آن آشنا میشوید.
مدل بازشناسی موجودیتهای نامدار (NER) کلمهی «Paris» را پیدا کرد. حالا پیونددهی موجودیتها (Entity linking یا EL) باید تصمیم بگیرد: پاریس در فرانسه؟ پاریس هیلتون؟ شهر پاریس در تگزاس؟ یا پاریس (شاهزادهی تروآ)؟ بدون این پیوند، گراف دانش شما در ابهام میماند.
صورت مسئله
این جمله را در نظر بگیرید: «Jordan beat the press». مدل NER شما واژهی «Jordan» را بهعنوان شخص (PERSON) برچسب میزند. عالی است، اما کدام جردن؟
- مایکل جردن (بسکتبالیست)؟
- مایکل بی. جردن (بازیگر)؟
- مایکل آی. جردن (استاد یادگیری ماشین در برکلی — بله، این اشتباه در مقالههای یادگیری ماشین واقعاً پیش میآید)؟
- کشور اردن (Jordan)؟
- جردن (نام کوچک عبری)؟
پیونددهی موجودیتها هر اشاره را به یک مدخل منحصربهفرد در یک پایگاه دانش (Knowledge base یا KB) مانند ویکیداده، ویکیپدیا، دیبیپدیا یا پایگاه دانش تخصصی شما وصل میکند. این کار دو گام دارد:
- تولید کاندیداها (Candidate generation): با دیدن اشارهی «Jordan»، کدام مدخلهای پایگاه دانش محتملاند؟
- ابهامزدایی (Disambiguation): با توجه به بافت متن، کدام کاندیدا گزینهی درست است؟
هر دو مرحله یادگرفتنی هستند و معیارهای ارزیابی استاندارد دارند. معماری ترکیبی این پایپلاین حدود یک دهه است که دستنخورده باقی مانده؛ چیزی که مدام بهتر میشود، کیفیت مدل ابهامزدایی است.
مفاهیم پایه
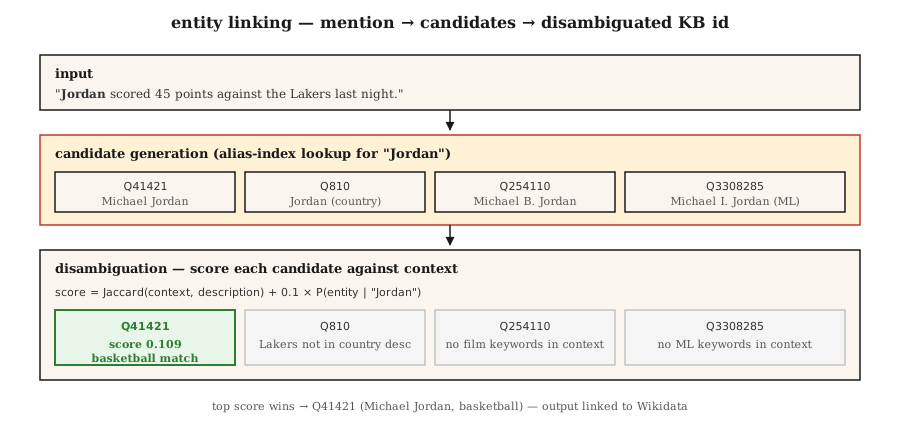
تولید کاندیداها: با گرفتن صورت ظاهری اشاره («Jordan»)، کاندیداها را در یک نمایهی نامهای مستعار (Alias index) جستجو میکنید. واژهنامههای نامهای مستعار در ویکیپدیا بیشتر موجودیتهای نامدار را پوشش میدهند: مثلاً «JFK» به جان اف. کندی، ژاکلین کندی، فرودگاه JFK یا فیلم JFK میرسد. چنین نمایهای معمولاً برای هر اشاره بین 10 تا 30 کاندیدا برمیگرداند.
ابهامزدایی: سه رویکرد اصلی.
- پیشین + بافت متن (Milne & Witten, 2008): حاصلضرب
P(entity | mention) × context-similarity(entity, text). سریع است، نیازی به آموزش ندارد و خوب جواب میدهد. - مبتنی بر امبدینگ (ESS / REL / Blink): امبدینگِ اشاره + بافت متن را بسازید. توصیف هر کاندیدا را هم به بردار تبدیل کنید. گزینهای را که بیشترین شباهت کسینوسی (Cosine similarity) را دارد انتخاب کنید. روش پیشفرض سالهای 2020 تا 2024 همین بود.
- زایشی (GENRE در سال 2021؛ روشهای مبتنی بر مدلهای زبانی بزرگ از 2023 به بعد): نام رسمی و استاندارد موجودیت را توکنبهتوکن تولید کنید. خروجی به یک درخت پیشوندی (Trie) از نامهای معتبر محدود میشود تا مطمئن شوید خروجی حتماً یک شناسهی معتبر در پایگاه دانش است.
یکپارچه در برابر پایپلاین: مدلهای مدرن (مثل ELQ، BLINK، ExtEnD و GENRE) مراحل NER، تولید کاندیدا و ابهامزدایی را در یک مرحله اجرا میکنند. با این حال، سیستمهای پایپلاینی هنوز در محیطهای عملیاتی حرف اول را میزنند، چون هر جزء را بهراحتی میتوانید عوض کنید.
دو معیار ارزیابی کلیدی
- بازخوانی اشارهها در تولید کاندیدا (Mention recall): نسبتی از اشارههای مرجع (Gold) که مدخل درستِ پایگاه دانش در فهرست کاندیداهایشان وجود دارد. این عدد کفِ کارایی کل پایپلاین را تعیین میکند.
- دقت ابهامزدایی / نمرهی F1: اگر کاندیدای درست در فهرست باشد، انتخاب اول (Top-1) چند درصد مواقع درست است؟
همیشه هر دو معیار را گزارش کنید. سیستمی با دقت ابهامزدایی 99% روی بازخوانی کاندیدای 80%، در عمل پایپلاینی با کارایی 80% است.
پیادهسازی گامبهگام
گام 1: ساخت نمایهی نامهای مستعار از بازهدایتهای ویکیپدیا
alias_to_entities = {
    "jordan": ["Q41421 (Michael Jordan)", "Q810 (Jordan, country)", "Q254110 (Michael B. Jordan)"],
    "paris":  ["Q90 (Paris, France)", "Q663094 (Paris, Texas)", "Q55411 (Paris Hilton)"],
    "apple":  ["Q312 (Apple Inc.)", "Q89 (apple, fruit)"],
}دادههای نامهای مستعار در ویکیپدیا شامل حدود 18M جفت (نام مستعار، موجودیت) است. آنها را از دامپهای ویکیداده بگیرید و در قالب یک نمایهی معکوس (Inverted index) ذخیره کنید.
گام 2: ابهامزدایی بر اساس بافت متن
def disambiguate(mention, context, alias_index, entity_desc):
    candidates = alias_index.get(mention.lower(), [])
    if not candidates:
        return None, 0.0
    context_words = set(tokenize(context))
    best, best_score = None, -1
    for entity_id in candidates:
        desc_words = set(tokenize(entity_desc[entity_id]))
        union = len(context_words | desc_words)
        score = len(context_words & desc_words) / union if union else 0.0
        if score > best_score:
            best, best_score = entity_id, score
return best, best_scoreهمپوشانی ژاکارد صرفاً یک مثال دمدستی است. آن را با شباهت کسینوسی روی امبدینگها جایگزین کنید (برای نسخهی ترنسفورمری، گام 2 را در فایل code/main.py ببینید).
گام 3: روش مبتنی بر امبدینگ (به سبک BLINK)
from sentence_transformers import SentenceTransformer
encoder = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")

def embed_mention(text, mention_span):
    start, end = mention_span
    marked = f"{text[:start]} [MENTION] {text[start:end]} [/MENTION] {text[end:]}"
    return encoder.encode([marked], normalize_embeddings=True)[0]

def embed_entity(entity_id, description):
    return encoder.encode([f"{entity_id}: {description}"], normalize_embeddings=True)[0]
در زمان ساخت نمایه، برای هر موجودیتِ پایگاه دانش فقط یک بار امبدینگ تولید کنید. موقع پرسوجو، امبدینگِ اشاره + بافت متن را یک بار حساب کنید، ضرب داخلی آن را با مجموعهی کاندیداها بگیرید و بیشترین مقدار را بردارید.
گام 4: پیونددهی زایشی موجودیتها (ایدهی کلی)
مدل GENRE عنوان ویکیپدیای موجودیت را کاراکتربهکاراکتر تولید میکند. دیکودینگ مقید (Constrained decoding — درس 20 را ببینید) خروجی را فقط به عناوین معتبر محدود میکند؛ سازوکاری که ارتباط تنگاتنگی با درخت پیشوندیِ پایگاه دانش دارد. نوادگان امروزی این روش، REL-GEN و پیونددهی موجودیتها با پرامپت و خروجی ساختاریافته در مدلهای زبانی بزرگ هستند.
prompt = f"""Text: {text}
Mention: {mention}
List the best Wikipedia title for this mention.
Respond with JSON: {{"title": "..."}}"""
ترکیب این روش با یک فهرست مجاز (متد choice در Outlines)، سادهترین پایپلاین پیونددهی موجودیتها برای راهاندازی در سال 2026 است.
گام 5: ارزیابی روی AIDA-CoNLL
مجموعهدادهی AIDA-CoNLL بنچمارک استاندارد EL است: 1,393 مقالهی رویترز، 34k اشاره و موجودیتهای متناظر در ویکیپدیا. در گزارش نهایی، هم دقت داخل پایگاه دانش (P@1) و هم نرخ تشخیص موجودیتهای غایب (NIL) را بیاورید.
دامهای رایج
- مدیریت موجودیتهای غایب (NIL): بعضی اشارهها اصلاً در پایگاه دانش نیستند (موجودیتهای جدید یا چهرههای کمترشناختهشده). سیستم باید به جای حدس اشتباه، NIL را پیشبینی کند. این معیار را جداگانه میسنجند.
- خطای مرز اشاره (Mention boundary errors): اگر مدل بالادستی NER بخشی از عبارت را جا بیندازد (مثلاً به جای «Bank of America» فقط «Bank» را برچسب بزند)، بازخوانی پیونددهی افت میکند.
- سوگیری به سمت موارد پرتکرار (Popularity bias): مدلها معمولاً به سمت پیشنهاد موجودیتهای پرتکرار سوگیری دارند. اشاره به «Michael I. Jordan» در یک مقالهی یادگیری ماشین، خیلی وقتها به اشتباه به جردن بسکتبالیست وصل میشود.
- پیونددهی چندزبانه (Cross-lingual EL): وصل کردن اشارههای درون متنی چینی به موجودیتهای ویکیپدیای انگلیسی. این کار یک انکودر چندزبانه یا مرحلهی ترجمه میخواهد.
- کهنگی داده در پایگاه دانش (KB staleness): شرکتها، اتفاقها و چهرههای جدید در نسخهی سال گذشتهی ویکیپدیا نیستند. پایپلاینهای پروداکشن به چرخهی بهروزرسانی منظم نیاز دارند.
کاربرد عملی
استک ابزارها در سال 2026:
| موقعیت | انتخاب مناسب |
|---|---|
| انگلیسی عمومی + ویکیپدیا | BLINK یا REL |
| چندزبانه، پایگاه دانش = ویکیپدیا | mGENRE |
| مدلهای زبانی، تعداد کمِ اشاره در روز | پرامپت دادن به Claude یا GPT-4 همراه با لیست کاندیداها و خروجی کنترلشدهی JSON |
| پایگاه دانش تخصصی (پزشکی، حقوقی) | مدل BERT سفارشی با بازیابی مبتنی بر پایگاه دانش + فاینتیون روی دادههای دامنهی هدف به سبک AIDA |
| تأخیر بسیار کم (حیاتی) | فقط پیشینِ تطابق دقیق (خط پایهی Milne-Witten) |
| بالاترین دقت پژوهشی (SOTA) | مدلهای GENRE / ExtEnD / روشهای زایشی مبتنی بر مدل زبانی |
الگوی عملیاتی در سال 2026: اجرای NER ← تحلیل ارجاعات (Coref) ← اجرای EL روی هر اشاره ← ادغام خوشهها در قالب یک موجودیت واحد برای هر خوشه. خروجی نهایی: یک شناسه از پایگاه دانش برای هر موجودیت کلی در متن، نه یک شناسه به ازای هر بار تکرار اشاره.
تحویل پروژه
در قالب فایل outputs/skill-entity-linker.md ذخیره کنید:
---
name: entity-linker
description: Design an entity linking pipeline — KB, candidate generator, disambiguator, evaluation.
version: 1.0.0
phase: 5
lesson: 25
tags: [nlp, entity-linking, knowledge-graph]
---

Given a use case (domain KB, language, volume, latency budget), output:

1. Knowledge base. Wikidata / Wikipedia / custom KB. Version date. Refresh cadence.
2. Candidate generator. Alias-index, embedding, or hybrid. Target mention recall @ K.
3. Disambiguator. Prior + context, embedding-based, generative, or LLM-prompted.
4. NIL strategy. Threshold on top score, classifier, or explicit NIL candidate.
5. Evaluation. Mention recall @ 30, top-1 accuracy, NIL-detection F1 on held-out set.

Refuse any EL pipeline without a mention-recall baseline (you cannot evaluate a disambiguator without knowing candidate gen surfaced the right entity). Refuse any pipeline using LLM-prompted EL without constrained output to valid KB ids. Flag systems where popularity bias affects minority entities (e.g. name-clashes) without domain fine-tuning.تمرینها
- ساده. ابهامزدای مبتنی بر «پیشین + بافت متن» را در فایل
code/main.pyروی 10 اشارهی مبهم (مثل Paris، Jordan، Apple) پیاده کنید. موجودیت درست را دستی برچسب بزنید و دقت را اندازه بگیرید. - متوسط. 50 اشارهی مبهم را با یک ترنسفورمر جملهای امبد کنید. توصیف هر کاندیدا را هم به امبدینگ تبدیل کنید. سپس ابهامزدایی مبتنی بر امبدینگ را با همپوشانی ژاکارد بافت متن مقایسه کنید.
- پیشرفته. یک پایگاه دانش تخصصی با 1k موجودیت بسازید (مثلاً کارکنان و محصولات شرکت خودتان). پایپلاین یکپارچهی NER + EL را اجرا کنید و دقت (Precision) و بازخوانی (Recall) را روی 100 جملهی تست بسنجید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای دقیق فنی |
|---|---|---|
| پیونددهی موجودیتها (EL) | لینک کردن به ویکیپدیا | نگاشت یک اشاره به یک مدخل منحصربهفرد در پایگاه دانش. |
| تولید کاندیداها | چه گزینههایی داریم؟ | برگرداندن فهرست کوتاهی از مدخلهای محتمل پایگاه دانش برای یک اشاره. |
| ابهامزدایی | انتخاب گزینهی درست | امتیازدهی به کاندیداها با تکیه بر بافت متن و انتخاب بهترین گزینه. |
| نمایهی نامهای مستعار | جدول جستجو | نگاشت صورت ظاهری متن به کاندیداهای موجودیت. |
| غایب در پایگاه دانش (NIL) | در پایگاه دانش نیست | پیشبینی صریح اینکه هیچ مدخلی در پایگاه دانش با این اشاره همخوانی ندارد. |
| پایگاه دانش (KB) | بانک دانش | ویکیداده، ویکیپدیا، دیبیپدیا یا پایگاه دانش تخصصی شما. |
| بنچمارک AIDA-CoNLL | دادهی ارزیابی معیار | 1,393 مقالهی رویترز همراه با پیوندهای برچسبخورده و قطعی به موجودیتها. |
مطالعهی بیشتر
- Milne, Witten (2008). Learning to Link with Wikipedia — مقالهی بنیادین رویکرد «پیشین + بافت متن».
- Wu et al. (2020). Zero-shot Entity Linking with Dense Entity Retrieval (BLINK) — ابزار استاندارد و پرکاربرد مبتنی بر امبدینگ.
- De Cao et al. (2021). Autoregressive Entity Retrieval (GENRE) — پیونددهی زایشی موجودیتها با دیکودینگ مقید.
- Hoffart et al. (2011). Robust Disambiguation of Named Entities in Text (AIDA) — مقالهی بنچمارک استاندارد.
- REL: An Entity Linker Standing on the Shoulders of Giants (2020) — فریمورک متنباز برای سیستمهای عملیاتی.