
امروزه صحبت از مدلهای زبانی بزرگ و معماری ترنسفورمر همه جا شنیده میشود، اما برای درک عمیق سازوکار تولید متن و معیارهای سنجش آن مانند پرپلکسیتی و آنتروپی، باید به نقطهی آغاز این مسیر بازگردیم. پیش از شبکههای عصبی، مدلهای آماری انگرم (N-gram) با شمارش توالیها و تخصیص احتمال به کلمات، ستون فقرات پردازش زبان طبیعی بودند و هنوز هم در سیستمهای حساس به تأخیر یا پردازش محلی روی دستگاههای کممصرف کاربرد دارند.
چالش اصلی این مدلها مواجهه با کلمات و توالیهای دیدهنشده در فاز تست است؛ جایی که یک احتمال صفر محاسباتی میتواند کل زنجیرهی احتمال را نابود کند. در این درس با پیادهسازی تکنیکهای هموارسازی بهویژه الگوریتم قدرتمند Kneser-Ney، یاد میگیرید که چگونه احتمالات را بازتوزیع کنید، پرپلکسیتی مدل را بسنجید و متنی آماری تولید کنید.
کدهای این درس با تکیه بر منطق خالص پایتون نوشته شدهاند و اجرای آنها به پردازندههای گرافیکی پرهزینه، دانلود مدلهای حجیم یا فراخوانی سرویسهای ابری خارجی نیاز ندارد؛ بنابراین میتوانید تمام مراحل را بهسادگی و بهصورت محلی روی سیستم شخصیتان پیاده و آزمایش کنید.
اگر کلمهای مایهی غافلگیری مدل شود، آن مدل ضعیف است. پرپلکسیتی این غافلگیری را به عدد تبدیل میکند؛ هموارسازی هم مقدارش را متناهی نگه میدارد.
صورت مسئله
پیش از ترنسفورمرها، پیش از RNNها و قبل از امبدینگهای کلمات، مدلهای زبانی کلمهی بعدی را با شمارش دفعات تکرار آن پس از n-1 کلمهی قبلی پیشبینی میکردند: 47 بار شمارش دنبالهی «the cat» → «sat»، 12 بار «the cat» → «jumped» و 0 بار «the cat» → «refrigerator». در نهایت هم با نرمالسازی این شمارشها یک توزیع احتمال به دست میآمد.
این همان مدل زبانی n-gram است. از سال 1980 تا 2015، تمام سیستمهای بازشناسی گفتار، غلطیابهای املایی و سیستمهای ترجمهی ماشینی مبتنی بر عبارت با همین روش کار میکردند. امروزه هم هر جا به مدلسازی زبانی کمهزینه روی خود دستگاه نیاز داشته باشید، هنوز سراغ همین روش میروند.
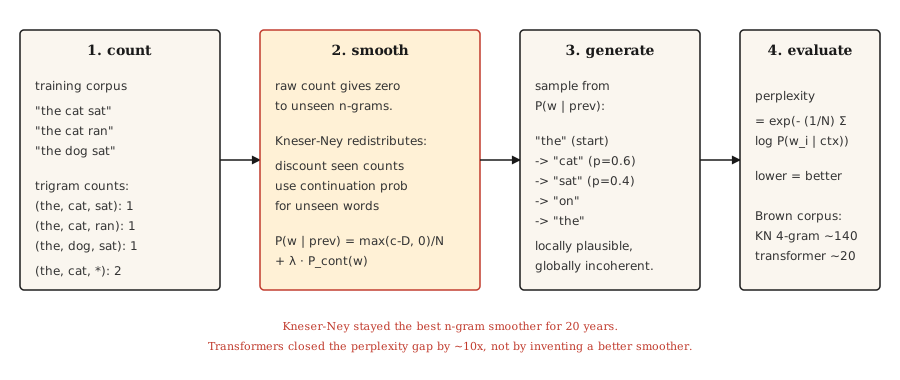
مسئلهی جالب توجه، نحوهی برخورد با n-gramهای دیدهنشده است. مدلی که صرفاً بر پایهی شمارش خام کار میکند، به هر چیزی که ندیده باشد احتمال صفر میدهد. این اتفاق یک فاجعه است؛ چون جملهها طولانی هستند و تقریباً هر جملهی بلندی دستکم یک توالی دیدهنشده دارد. پنجاه سال پژوهش روی هموارسازی (smoothing) این مشکل را حل کرد؛ Kneser-Ney حاصل همین مسیر است و یادگیری عمیق امروزی هم سنت تجربیاش را از همین جا به ارث برده است.
مفاهیم پایه
بازی حدس کلمه
پیش از آنکه هیچکدام از این سازوکارها ساخته شوند، یک آزمایش مشخص کرد که مدل زبانی اصلاً چیست: حرف بعدی یک جملهی انگلیسی را بپوشانید؛ از کسی بخواهید یکییکی آن را حدس بزند تا به جواب درست برسد؛ تعداد حدسها را یادداشت کنید و این کار را برای چند صد حرف تکرار کنید.
این تعداد حدسها صرفاً اعدادی دمدستی نیستند، بلکه بازکدگذاری کامل و بدون اتلاف متن بهشمار میروند: اگر توالی تعداد حدسها را به یک حدسزنندهی مشابه دیگر بدهید، میتواند تکتک حروف را بازسازی کند؛ چون در هر جایگاه دقیقاً میداند اولویت با کدام حدسهاست. پیامی که بشود آن را با نمادهای کمتری بازکدگذاری کرد، اطلاعات کمتری در هر نماد حمل میکند؛ در نتیجه، آمار تعداد حدسها سقفی برای آنتروپی زبان انگلیسی تعیین میکند.
شانون (Shannon) در سال 1951 این آزمایش را انجام داد و به عددی رسید که هنوز هم بر این حوزه حاکم است: الفبایی با 27 نماد (26 حرف بههمراه فاصله) میتواند حامل log2(27) ≈ 4.75 بیت در هر حرف باشد. حدسزنندههای انسانی با در اختیار داشتن زمینهای (context) شامل 100 حرف قبلی، به عددی بین 0.6 تا 1.3 بیت در هر حرف رسیدند. به بیان دیگر، حدود سهچهارم زبان انگلیسی حرکات اجباری و کاملاً قابل پیشبینی است. ساختاری را که یک مدل باید یاد بگیرد، پیش از آنکه اصلاً مدلی برای یادگیریاش ساخته شود، اندازه گرفته بودند.
از آن زمان، تمام مدلهای زبانی بازیکنان مکانیکی همین بازی هستند و همهی معیارهای ارزیابی در این درس، امتیازهای ثبتشده در این بازی بهحساب میآیند:
- تابع زیان (loss) آنتروپی متقاطع: میانگین تعداد بیتهایی است که مدل برای هر نماد نیاز دارد. آموزش یک مدل زبانی دقیقاً یعنی به حداقل رساندن امتیازش در همین بازی حدس زدن.
- پرپلکسیتی: برابر است با
2^bits(یاe^nats)؛ یعنی همان فاکتور branch که مدل پس از حدسهایش همچنان با آن روبهروست. حدس زدن یکنواخت بین 27 نماد، پرپلکسیتی 27 دارد؛ بازیکنی با امتیاز 1 بیت به ازای هر حرف، به پرپلکسیتی 2 میرسد. - طول زمینه، حافظهی بازیکن است. یک مدل تریگرم با دو توکن حافظه بازی میکند. یک ترنسفورمر همین بازی را با 100 هزار توکن انجام میدهد. قواعد بازی هرگز تغییر نکرده؛ فقط بازیکن ماهرتر شده است.
یک تغییر یکا را هم باید در نظر داشته باشید: امتیاز این بازی بر اساس هر حرف و با یکای بیت (log2) محاسبه میشود؛ در حالی که فرمولهای n-gram در ادامه، امتیازها را بر اساس هر توکن کلمه و با یکای نات (nats، بر پایهی لگاریتم طبیعی) حساب میکنند. از آنجا که پرپلکسیتیِ e^H در یکای نات برابر با 2^H در یکای بیت است، هر دو دیدگاه یک سنجش مشترک را در قالب یکاهای متفاوتی نشان میدهند.
احتمال N-gram: عبارت است از P(w_i | w_{i-n+1}, ..., w_{i-1}). ابتدا n را ثابت فرض کنید (معمولاً 3 برای تریگرمها و 4 برای 4-گرمها). سپس احتمال را از روی شمارشها حساب کنید:
مسئلهی شمارش صفر. هر n-gram دیدهنشده در دادههای آموزشی، احتمالش صفر میشود. پژوهشی در سال 2007 روی مجموعهدادهی Brown نشان داد که حتی در یک مدل 4-گرم، 30 درصد از 4-گرمهای موجود در دادههای آزمایشی، در آموزش دیده نشده بودند. بنابراین، ارزیابی روی هیچ متن واقعی بدون هموارسازی امکانپذیر نیست.
روشهای هموارسازی، به ترتیب میزان پیشرفت و ظرافت:
- هموارسازی لاپلاس (افزودن یک واحد): به هر شمارش 1 واحد اضافه کنید. روشی بسیار ساده است، اما در مورد رخدادهای نادر عملکردی فاجعهبار دارد.
- گود-تورینگ (Good-Turing): بازتوزیع جرم احتمال از رخدادهای پرتکرار به رخدادهای دیدهنشده، بر اساس فراوانیِ بسامدها (frequency-of-frequencies).
- درونیابی (Interpolation): ترکیب برآوردهای حاصل از n-gram، (n-1)-gram و مراتب پایینتر با وزنهای قابل تنظیم.
- عقبگرد (Backoff): اگر شمارش n-gram صفر بود، به برآورد (n-1)-gram رجوع شود. عقبگرد کاتز (Katz backoff) این فرآیند را نرمالسازی میکند.
- تخفیف مطلق (Absolute discounting): کسر مقداری ثابت
Dاز تمام شمارشها و بازتوزیع آن به رخدادهای دیدهنشده. - کنزر-نی (Kneser-Ney): تخفیف مطلق همراه با انتخابی هوشمندانه برای مدل مرتبه پایینتر: استفاده از احتمال ادامهیافتن (continuation probability - یعنی اینکه کلمه در چند زمینهی متفاوت آمده) بهجای بسامد خام.
ایدهی پشت روش Kneser-Ney بسیار عمیق است. ترکیب «San Francisco» یک بایگرم (bigram) بسیار رایج است. یونیگرم «Francisco» هم تقریباً همیشه بعد از «San» میآید. تخفیف مطلق خام، احتمال یونیگرم بالایی به «Francisco» میدهد (چون شمارش کل آن زیاد است). اما Kneser-Ney تشخیص میدهد که «Francisco» فقط در یک زمینه ظاهر میشود و احتمال ادامهیافتن آن را متناسب با همین موضوع پایین میآورد. در نتیجه، هر بایگرم جدیدی که به «Francisco» ختم شود، احتمالی بهدرستی پایین دریافت میکند.
ارزیابی: پرپلکسیتی. توان میانگین منفیِ درستنماییِ لگاریتمی (negative log-likelihood) به ازای هر کلمه روی دادههای آزمایشی دیدهنشده. هرچه کمتر باشد بهتر است. پرپلکسیتی 100 یعنی مدل درست مثل این سردرگم است که بخواهد بهطور یکنواخت از میان 100 کلمه یکی را انتخاب کند.
پیادهسازی
گام 1: شمارشهای Trigram
from collections import Counter, defaultdict


def train_ngram(corpus_tokens, n=3):
    ngrams = Counter()
    contexts = Counter()
    for sentence in corpus_tokens:
        padded = ["<s>"] * (n - 1) + sentence + ["</s>"]
        for i in range(len(padded) - n + 1):
            ctx = tuple(padded[i:i + n - 1])
            word = padded[i + n - 1]
            ngrams[ctx + (word,)] += 1
            contexts[ctx] += 1
    return ngrams, contexts


def raw_probability(ngrams, contexts, context, word):
    ctx = tuple(context)
    if contexts.get(ctx, 0) == 0:
        return 0.0
    return ngrams.get(ctx + (word,), 0) / contexts[ctx]
ورودی، فهرستی از جملات توکنبندیشده است. خروجی شامل شمارشهای n-gram و شمارشهای زمینههاست. <s> و </s> نیز مرزهای جمله را مشخص میکنند.
گام 2: هموارسازی لاپلاس
def laplace_probability(ngrams, contexts, vocab_size, context, word):
    ctx = tuple(context)
    numerator = ngrams.get(ctx + (word,), 0) + 1
    denominator = contexts.get(ctx, 0) + vocab_size
    return numerator / denominator
به هر شمارش عدد 1 اضافه میشود. این کار دادهها را هموار میکند، اما جرم احتمالاتیِ بیش از حدی را به رخدادهای دیدهنشده اختصاص میدهد؛ اتفاقی که به رخدادهای نادرِ دیدهشده هم لطمه میزند.
گام 3: Kneser-Ney (بایگرم، با درونیابی)
def kneser_ney_bigram_model(corpus_tokens, discount=0.75):
    unigrams = Counter()
    bigrams = Counter()
    unigram_contexts = defaultdict(set)

    for sentence in corpus_tokens:
        padded = ["<s>"] + sentence + ["</s>"]
        for i, w in enumerate(padded):
            unigrams[w] += 1
            if i > 0:
                prev = padded[i - 1]
                bigrams[(prev, w)] += 1
                unigram_contexts[w].add(prev)

    total_unique_bigrams = sum(len(ctx_set) for ctx_set in unigram_contexts.values())
    continuation_prob = {
        w: len(ctx_set) / total_unique_bigrams for w, ctx_set in unigram_contexts.items()
    }

    context_totals = Counter()
    for (prev, w), count in bigrams.items():
        context_totals[prev] += count

    unique_follow = defaultdict(set)
    for (prev, w) in bigrams:
        unique_follow[prev].add(w)

    def prob(prev, w):
        count = bigrams.get((prev, w), 0)
        denom = context_totals.get(prev, 0)
        if denom == 0:
            return continuation_prob.get(w, 1e-9)
        first_term = max(count - discount, 0) / denom
        lambda_prev = discount * len(unique_follow[prev]) / denom
        return first_term + lambda_prev * continuation_prob.get(w, 1e-9)

    return prob
این بخش سه جزء اصلی دارد: تابع continuation_prob نشان میدهد که «این کلمه در چند زمینهی مختلف ظاهر میشود؟» (همان نوآوری Kneser-Ney). مقدار lambda_prev جرمی است که با کسر مقدار تخفیف آزاد شده و برای وزندهی به عقبگرد استفاده میشود. احتمال نهایی هم مجموع عبارت اصلی تخفیفخورده بهاضافهی عبارت ادامهیافتنِ وزندار خواهد بود.
گام 4: تولید متن با نمونهگیری
import random


def generate(prob_fn, vocab, prefix, max_len=30, seed=0):
    rng = random.Random(seed)
    tokens = list(prefix)
    for _ in range(max_len):
        candidates = [(w, prob_fn(tokens[-1], w)) for w in vocab]
        total = sum(p for _, p in candidates)
        r = rng.random() * total
        acc = 0.0
        for w, p in candidates:
            acc += p
            if r <= acc:
                tokens.append(w)
                break
        if tokens[-1] == "</s>":
            break
return tokensنمونهگیری متناسب با احتمال انجام میشود؛ بنابراین با هر seed خروجی متفاوتی خواهید گرفت. برای تولید خروجیهایی شبیه به جستجوی پرتویی (beam search)، در هر گام مقدار بیشینه (argmax) را انتخاب کنید (رویکرد حریصانه یا greedy) و پیچ تصادفیسازی کوچکی (temperature) به آن بیفزایید.
گام 5: پرپلکسیتی
import math


def perplexity(prob_fn, sentences):
    total_log_prob = 0.0
    total_tokens = 0
    for sentence in sentences:
        padded = ["<s>"] + sentence + ["</s>"]
        for i in range(1, len(padded)):
            p = prob_fn(padded[i - 1], padded[i])
            total_log_prob += math.log(max(p, 1e-12))
            total_tokens += 1
    return math.exp(-total_log_prob / total_tokens)
هرچه این مقدار کمتر باشد بهتر است. برای مجموعهدادهی Brown، یک مدل KN چهار-گرمِ خوب تنظیمشده به پرپلکسیتی حدود 140 میرسد؛ در حالی که یک مدل زبانی ترنسفورمر روی همین مجموعهی آزمایشی عدد 15 تا 30 را ثبت میکند، یعنی اختلافی حدود 10 برابری. دقیقاً به خاطر همین فاصله بود که کل این حوزه مسیرش را تغییر داد.
کاربردها
- آموزش کلاسیک NLP: شفافترین روش ممکن برای درک مفاهیم هموارسازی، برآورد درستنمایی بیشینه (MLE) و پرپلکسیتی.
- KenLM: کتابخانهی تولیدی n-gram برای محیط عملیاتی؛ که بهعنوان امتیازدهندهی مجدد (rescorer) در سیستمهای بازشناسی گفتار و ترجمهی ماشینی حساس به تأخیر کاربرد دارد.
- تکمیل خودکار روی دستگاه: مدلهای تریگرم در کیبوردها؛ که هنوز هم استفاده میشوند.
- خطوط مبنا (Baselines): همیشه قبل از اینکه مدل عصبیتان را عالی بدانید، پرپلکسیتی یک مدل زبانی n-gram را حساب کنید. اگر ترنسفورمر شما نتواند با فاصلهای چشمگیر KN را شکست دهد، حتماً یک جای کار میلنگد.
خروجی نهایی
این محتوا را در مسیر outputs/prompt-lm-baseline.md ذخیره کنید:
---
name: lm-baseline
description: Build a reproducible n-gram language model baseline before training a neural LM.
phase: 5
lesson: 16
---

Given a corpus and target use (next-word prediction, rescoring, perplexity baseline), output:

1. N-gram order. Trigram for general English, 4-gram if corpus is large, 5-gram for speech rescoring.
2. Smoothing. Modified Kneser-Ney is the default; Laplace only for teaching.
3. Library. `kenlm` for production, `nltk.lm` for teaching, roll your own only to learn.
4. Evaluation. Held-out perplexity with consistent tokenization between train and test sets.

Refuse to report perplexity computed with different tokenization between systems being compared — perplexity numbers are comparable only under identical tokenization. Flag OOV rate in test set; KN handles OOV poorly unless you reserve a special <UNK> token during training.تمرینها
- ساده. یک مدل زبانی تریگرم را روی مجموعهدادهای با 1000 جمله از شکسپیر آموزش دهید و 20 جمله با آن تولید کنید. این جملهها در سطح کلمات مجاور منطقی به نظر میرسند، اما در کل نامفهوم خواهند بود. این دمو، نمونهای استاندارد و کلاسیک در این حوزه است.
- متوسط. پرپلکسیتی مدل KN خود را روی بخشی از دادههای نگهداشتهشدهی شکسپیر پیادهسازی و محاسبه کنید. سپس آن را با هموارسازی لاپلاس بسنجید؛ باید ببینید که KN پرپلکسیتی را 30 تا 50 درصد کاهش میدهد.
- سخت. یک غلطیاب املایی تریگرم بسازید: با دریافت یک کلمهی اشتباه و زمینهی آن، کلمات اصلاحشده را تولید کنید و بر اساس احتمال زمینه در مدل زبانی، آنها را رتبه دهید (rank). عملکرد سیستم را روی مجموعهدادهی املایی Birkbeck (عمومی) ارزیابی کنید.
اصطلاحات کلیدی
| اصطلاح | معنای عامیانه | معنای دقیق فنی |
|---|---|---|
| ان-گرم (N-gram) | توالی کلمات | توالی مشخصی از n توکن پیاپی. |
| هموارسازی (Smoothing) | دوری از صفرهای محاسباتی | بازتوزیع جرم احتمالاتی بهگونهای که به رخدادهای دیدهنشده احتمالی غیرصفر اختصاص یابد. |
| پرپلکسیتی (Perplexity) | معیار کیفیت مدل زبانی | مقدار exp(-average log-prob) روی دادههای نگهداشتهشده. هرچه کمتر باشد بهتر است. |
| عقبگرد (Backoff) | بازگشت به زمینهی کوتاهتر | اگر شمارش تریگرم صفر بود، استفاده از بایگرم. عقبگرد کاتز این فرآیند را صورتبندی میکند. |
| Kneser-Ney | بهترین هموارسازی برای n-gramها | تخفیف مطلق بههمراه احتمال ادامهیافتن برای مدل مرتبه پایینتر. |
| احتمال ادامهیافتن (Continuation probability) | اصطلاح اختصاصی KN | احتمال P(w) که بهجای شمارش خام، با تعداد زمینههایی که w در آنها ظاهر شده وزندهی میشود. |
| آنتروپی متن (Entropy of text) | اطلاعات در هر نماد | میانگین بیتهای لازم برای کدگذاری نماد بعدی با توجه به زمینه. برآورد سال 1951 شانون برای زبان انگلیسی مکتوب با زمینهای تا 100 حرف: 0.6 تا 1.3 بیت بهازای هر حرف، که پیش از ظهور هر مدلی اندازهگیری شد. |
برای مطالعهی بیشتر
- Shannon (1951). Prediction and Entropy of Printed English — آزمایش بازی حدس زدن که همان هدفی را تعریف کرد که همهی مدلهای زبانی هنوز در پی بهینهسازی آن هستند.
- Jurafsky and Martin — Speech and Language Processing, Chapter 3 (2026 draft) — مرجع اصلی آموزش مدلهای زبانی n-gram و روشهای هموارسازی.
- Chen and Goodman (1998). An Empirical Study of Smoothing Techniques for Language Modeling — مقالهای تجربی که جایگاه Kneser-Ney را بهعنوان بهترین روش هموارسازی n-gram تثبیت کرد.
- Kneser and Ney (1995). Improved Backing-off for M-gram Language Modeling — مقالهی اصلی Kneser-Ney.
- KenLM — کتابخانهی سریع و عملیاتی مدلهای n-gram که هنوز در سال 2026 برای سناریوهای حساس به تأخیر استفاده میشود.