
در تسکهایی مثل ترجمهی ماشینی یا خلاصهسازی متن، با ورودیها و خروجیهایی با طول متغیر و زبانهای متفاوت سروکار داریم که مدلهای طبقهبندی سنتی توانایی پردازش آنها را ندارند. معماری توالیبهتوالی (Sequence-to-Sequence یا Seq2Seq) با معرفی ساختار دوگانهی رمزگذار-رمزگشا این مسئله را حل کرد و پایهگذار سامانههای نوین تولید متن شد.
اگرچه مدلهای مبتنی بر ترنسفورمر امروزه جایگزین معماریهای کلاسیک شدهاند، درک گلوگاه مفهومی بردار بافتار در Seq2Seq و مفاهیمی مثل Teacher Forcing و Beam Search سریعترین مسیر برای فهم چرایی ظهور مکانیزم Attention و نحوهی عملکرد مدلهای زبانی امروزی است.
کدهای این درس سبک هستند و میتوانید آنها را بدون نیاز به پردازندههای گرافیکی ابری گرانقیمت، مستقیماً روی پردازندهی سیستم شخصی یا تراشههای Apple Silicon اجرا کنید. در صورت استفاده از کتابخانهی transformers هاگینگفیس نیز، توجه داشته باشید که دانلود وزنها از مخازن خارجی گاهی ناپایدار است و میتوان از ابزارهای میرور مناسب کمک گرفت.
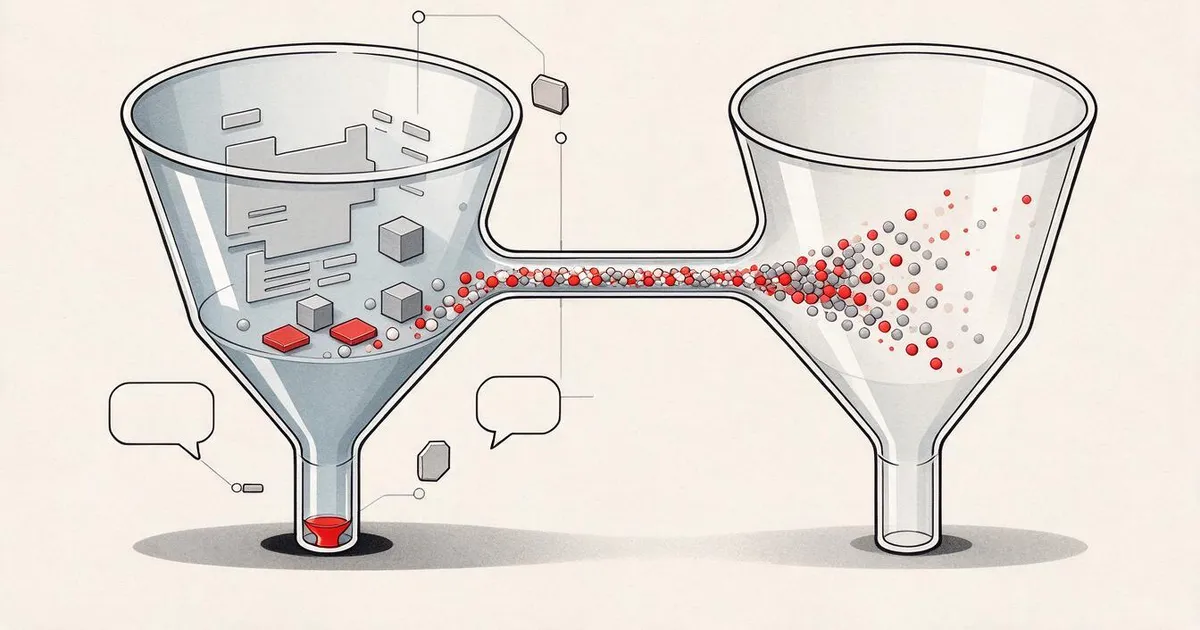
دو RNN که نقش یک مترجم را بازی میکنند. گلوگاهی که به آن برمیخورند، دقیقاً همان دلیلی است که اتنشن (attention) به خاطرش به وجود آمد.
صورت مسئله
دستهبندی، یک توالی با طول متغیر را به یک برچسب واحد نگاشت میکند. در مقابل، ترجمه یک توالی با طول متغیر را به توالی دیگری با طول متغیر نگاشت میکند. ورودی و خروجی در واژگان متفاوتی قرار دارند، شاید حتی به دو زبان مختلف باشند و هیچ تضمینی هم برای برابری طول آنها وجود ندارد.
معماری seq2seq (سوتسکیور، وینیالز، له، 2014) این چالش را با یک دستورالعمل عمداً ساده حل کرد: دو RNN. اولی متن مبدا را میخواند و یک بردار بافتار (context vector) با اندازهی ثابت میسازد. دومی آن بردار را میخواند و متن مقصد را توکن به توکن تولید میکند؛ همان کدی که در درس 08 نوشتید، فقط این بار جور دیگری به هم وصل شده است.
بررسی این معماری به دو دلیل اهمیت دارد: اول اینکه گلوگاه ناشی از بردار بافتار، از نظر آموزشی آموزندهترین شکست در NLP است؛ چون دلیل پشت تمام نقاط قوت اتنشن و ترنسفورمرها را روشن میکند. دوم اینکه شیوهی آموزش آن (وادارسازی معلم، نمونهبرداری برنامهریزیشده و جستجوی پرتو هنگام استنتاج) هنوز در تمام سیستمهای تولید متن امروزی از جمله مدلهای زبانی بزرگ (LLM) به کار میرود.
مفاهیم اصلی
رمزگذار (Encoder). یک RNN که متن مبدا را میخواند. آخرین وضعیت پنهان (hidden state) آن همان بردار بافتار است؛ خلاصهای با اندازهی ثابت از کل متن ورودی. قاعدتاً نباید چیزی جز متن مبدا در آن از دست برود.
رمزگشا (Decoder). یک RNN دیگر که با بردار بافتار مقداردهی اولیه میشود. در هر گام، توکن تولیدشدهی قبلی را به عنوان ورودی دریافت میکند و یک توزیع روی واژگان مقصد تحویل میدهد. با نمونهبرداری یا تابع argmax توکن بعدی را انتخاب کنید، دوباره آن را به عنوان ورودی به مدل بدهید و این کار را تا رسیدن به توکن <EOS> یا سقف طول مجاز تکرار کنید.
آموزش: تابع زیان (loss) آنتروپی متقاطع (Cross-Entropy) در هر گام از رمزگشا محاسبه و روی کل توالی جمع زده میشود؛ سپس پسانتشار استاندارد در طول زمان روی هر دو شبکه اجرا میگردد.
وادارسازی معلم (Teacher forcing). هنگام آموزش، ورودی رمزگشا در گام t، توکن واقعی متن مبنا (ground-truth) در جایگاه t-1 است، نه خروجی پیشبینیشدهی قبلیِ خودِ رمزگشا. این کار روند آموزش را پایدار میکند؛ بدون آن، خطاهای اولیه روی هم انباشته میشوند و مدل هیچوقت چیزی یاد نمیگیرد. اما هنگام استنتاج (inference)، باید از پیشبینیهای خود مدل استفاده کنید؛ بنابراین همیشه شکافی بین توزیع دادههای آموزش و استنتاج وجود دارد که به آن سوگیری مواجهه (exposure bias) میگویند.
گلوگاه. هر چه رمزگذار از متن مبدا فهمیده، باید در همان یک بردار بافتار فشرده شود. در جملههای طولانی جزئیات از دست میروند، کلمات نادر محو میشوند و تغییر ترتیب واژهها (مثل chat noir در برابر black cat) باید بهجای محاسبه، حفظ شود.
اتنشن (درس 10) با دادن این امکان به رمزگشا که بتواند به تکتک وضعیتهای پنهان رمزگذار نگاه کند — نه فقط وضعیت آخر — این مشکل را رفع میکند. کل ایدهی پشت اتنشن همین است.
پیادهسازی از صفر
گام 1: یک رمزگذار
import torch
import torch.nn as nn


class Encoder(nn.Module):
    def __init__(self, src_vocab_size, embed_dim, hidden_dim):
        super().__init__()
        self.embed = nn.Embedding(src_vocab_size, embed_dim, padding_idx=0)
        self.gru = nn.GRU(embed_dim, hidden_dim, batch_first=True)

    def forward(self, src):
        e = self.embed(src)
        outputs, hidden = self.gru(e)
        return outputs, hidden
خروجی outputs دارای ابعاد [batch, seq_len, hidden_dim] است؛ یعنی به ازای هر جایگاه ورودی، یک وضعیت پنهان داریم. متغیر hidden دارای ابعاد [1, batch, hidden_dim] است و گام نهایی را نشان میدهد. در درس 08 گفتیم «برای دستهبندی، روی خروجیها تجمیع (pool) انجام دهید.» اینجا وضعیت پنهان نهایی را به عنوان بردار بافتار نگه میداریم و خروجیهای مرحلهبهمرحله را نادیده میگیریم.
گام 2: یک رمزگشا
class Decoder(nn.Module):
    def __init__(self, tgt_vocab_size, embed_dim, hidden_dim):
        super().__init__()
        self.embed = nn.Embedding(tgt_vocab_size, embed_dim, padding_idx=0)
        self.gru = nn.GRU(embed_dim, hidden_dim, batch_first=True)
        self.fc = nn.Linear(hidden_dim, tgt_vocab_size)

    def forward(self, token, hidden):
        e = self.embed(token)
        out, hidden = self.gru(e, hidden)
        logits = self.fc(out)
        return logits, hidden
رمزگشا به صورت گامبهگام فراخوانی میشود. ورودی: یک بچ از تکتوکنها و وضعیت پنهان فعلی. خروجی: لاجیتها (logits) واژگان برای توکن بعدی و وضعیت پنهان بهروزرسانیشده.
گام 3: حلقهی آموزش با Teacher Forcing
def train_batch(encoder, decoder, src, tgt, bos_id, optimizer, teacher_forcing_ratio=0.9):
    optimizer.zero_grad()
    _, hidden = encoder(src)
    batch_size, tgt_len = tgt.shape
    input_token = torch.full((batch_size, 1), bos_id, dtype=torch.long)
    loss = 0.0
    loss_fn = nn.CrossEntropyLoss(ignore_index=0)

    for t in range(tgt_len):
        logits, hidden = decoder(input_token, hidden)
        step_loss = loss_fn(logits.squeeze(1), tgt[:, t])
        loss += step_loss
        use_teacher = torch.rand(1).item() < teacher_forcing_ratio
        if use_teacher:
            input_token = tgt[:, t].unsqueeze(1)
        else:
            input_token = logits.argmax(dim=-1)

    loss.backward()
    optimizer.step()
    return loss.item() / tgt_len
دو پارامتر تنظیمی مهم که باید به آنها اشاره کرد: پارامتر ignore_index=0 باعث میشود تابع زیان برای توکنهای فاصلهگذار (padding) محاسبه نشود. پارامتر teacher_forcing_ratio احتمال استفاده از توکن واقعی در مقایسه با پیشبینی خود مدل در هر گام را مشخص میکند. آموزش را با مقدار 1.0 (وادارسازی معلم کامل) شروع کنید و بهمرور در طول آموزش آن را تا حدود 0.5 پایین بیاورید تا شکاف ناشی از سوگیری مواجهه کمتر شود.
گام 4: حلقهی استنتاج (حریصانه)
@torch.no_grad()
def greedy_decode(encoder, decoder, src, bos_id, eos_id, max_len=50):
    _, hidden = encoder(src)
    batch_size = src.shape[0]
    input_token = torch.full((batch_size, 1), bos_id, dtype=torch.long)
    output_ids = []
    for _ in range(max_len):
        logits, hidden = decoder(input_token, hidden)
        next_token = logits.argmax(dim=-1)
        output_ids.append(next_token)
        input_token = next_token
        if (next_token == eos_id).all():
            break
    return torch.cat(output_ids, dim=1)
رمزگشایی حریصانه (Greedy decoding) در هر گام، توکنی با بالاترین احتمال را انتخاب میکند. این روش ممکن است از مسیر اصلی منحرف شود: وقتی یک توکن را commit کردید، دیگر نمیتوانید آن را پس بگیرید. جستجوی پرتو (Beam search) در هر گام k توالی ناقص برتر را زنده نگه میدارد و در نهایت بهترین توالی کامل را برمیگزیند. معمولاً پهنای پرتو (beam width) بین 3 تا 5 استاندارد است.
گام 5: نمایش عملی گلوگاه
مدل را روی یک تسک اسباببازی کپی آموزش دهید: ورودی [a, b, c, d, e] و خروجی [a, b, c, d, e]. طول توالی را بالا ببرید و دقت مدل را بررسی کنید.
seq_len=5   copy accuracy: 98%
seq_len=10  copy accuracy: 91%
seq_len=20  copy accuracy: 62%
seq_len=40  copy accuracy: 23%
یک وضعیت پنهان GRU بهتنهایی نمیتواند یک ورودی 40 توکنی را بدون افت اطلاعات حفظ کند. اطلاعات ورودی در تکتک مراحل رمزگذار وجود دارد، اما رمزگشا فقط آخرین وضعیت را میبیند. اتنشن دقیقاً همین نقطهضعف را هدف میگیرد و برطرف میکند.
استفاده از ابزارهای واقعی
فریمورک PyTorch قالبهای آمادهی seq2seq مبتنی بر nn.Transformer و nn.LSTM را در خود دارد. کتابخانهی transformers متعلق به Hugging Face نیز مدلهای کامل رمزگذار-رمزگشا (BART، T5، mBART، NLLB) را که روی میلیاردها توکن آموزش دیدهاند، ارائه میدهد.
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM

tok = AutoTokenizer.from_pretrained("facebook/bart-base")
model = AutoModelForSeq2SeqLM.from_pretrained("facebook/bart-base")

src = tok("Translate this to French: Hello, how are you?", return_tensors="pt")
out = model.generate(**src, max_new_tokens=50, num_beams=4)
print(tok.decode(out[0], skip_special_tokens=True))
رمزگذار-رمزگشاهای امروزی بهجای RNN از ترنسفورمرها استفاده میکنند. ساختار سطح بالا (رمزگذار، رمزگشا و تولید توکن به توکن) دقیقاً همان چیزی است که در مقالهی seq2seq سال 2014 مطرح شد؛ فقط سازوکار درونی هر بلوک فرق کرده است.
چه زمانهایی هنوز به سراغ seq2seqهای مبتنی بر RNN برویم؟
برای پروژههای جدید تقریباً هیچوقت، مگر در موارد استثنایی زیر:
- ترجمهی استریمینگ (Streaming) که در آن ورودی را توکن به توکن و با حافظهای کاملاً محدود پردازش میکنید.
- تولید متن روی دستگاه (on-device) که در آن هزینهی حافظهی ترنسفورمر غیرقابلتحمل است.
- اهداف آموزشی؛ فهم گلوگاه رمزگذار-رمزگشا سریعترین مسیر برای درک این نکته است که چرا ترنسفورمرها پیروز شدند.
راههای کاهش اثر سوگیری مواجهه
- نمونهبرداری برنامهریزیشده (Scheduled sampling): کاهش تدریجی نسبت teacher forcing در طول آموزش، تا مدل یاد بگیرد چطور خطاهای خودش را جبران کند.
- آموزش با حداقل ریسک (Minimum risk training): آموزش مدل بر اساس امتیاز BLEU در سطح جمله، بهجای آنتروپی متقاطع در سطح توکن؛ چیزی که به هدف نهایی شما نزدیکتر است.
- فاینتیونینگ با یادگیری تقویتی (Reinforcement Learning fine-tuning): پاداش دادن به مدل تولیدکنندهی توالی با یک معیار؛ روشی که امروزه در RLHF برای LLMها به کار میرود.
هر سه راهکار هنوز در تولید متن مبتنی بر ترنسفورمر هم کاربرد دارند.
خروجی این درس
محتوا را در فایل outputs/prompt-seq2seq-design.md ذخیره کنید:
---
name: seq2seq-design
description: Design a sequence-to-sequence pipeline for a given task.
phase: 5
lesson: 09
---

Given a task (translation, summarization, paraphrase, question rewrite), output:

1. Architecture. Pretrained transformer encoder-decoder (BART, T5, mBART, NLLB) is the default. RNN-based seq2seq only for specific constraints.
2. Starting checkpoint. Name it (`facebook/bart-base`, `google/flan-t5-base`, `facebook/nllb-200-distilled-600M`). Match the checkpoint to task and language coverage.
3. Decoding strategy. Greedy for deterministic output, beam search (width 4-5) for quality, sampling with temperature for diversity. One sentence justification.
4. One failure mode to verify before shipping. Exposure bias manifests as generation drift on longer outputs; sample 20 outputs at the 90th-percentile length and eyeball.

Refuse to recommend training a seq2seq from scratch for under a million parallel examples. Flag any pipeline that uses greedy decoding for user-facing content as fragile (greedy repeats and loops).تمرینها
- ساده. تسک اسباببازی کپی را پیادهسازی کنید. یک مدل seq2seq مبتنی بر GRU را روی جفتهای ورودی-خروجی که در آنها متن مقصد دقیقاً برابر متن مبدا است آموزش دهید. دقت را در طولهای 5، 10 و 20 اندازه بگیرید و گلوگاه را بازتولید کنید.
- متوسط. قابلیت رمزگشایی با جستجوی پرتو (با پهنای پرتو 3) را اضافه کنید. امتیاز BLEU را روی یک پیکرهی متنی موازی و کوچک در مقایسه با رمزگشایی حریصانه اندازه بگیرید. مواردی را که جستجوی پرتو بهتر عمل میکند (معمولاً توکنهای پایانی) و مواردی را که تفاوتی ایجاد نمیکند، مستند کنید.
- سخت. مدل
facebook/bart-baseرا روی یک مجموعهدادهی بازنویسی (paraphrase) با 10 هزار جفت داده، فاینتیون کنید. خروجی مدل فاینتیونشده با پهنای پرتو 4 را روی دادههای کنارگذاشتهشده (held-out) با خروجی مدل پایه مقایسه کنید. امتیاز BLEU را گزارش دهید و 10 نمونهی کیفی را تحلیل کنید.
اصطلاحات کلیدی
| Term | What people say | What it actually means |
|---|---|---|
| Encoder | Input RNN | Reads source. Produces per-step hidden states and a final context vector. |
| Decoder | Output RNN | Initialized from context vector. Generates target tokens one at a time. |
| Context vector | The summary | Final encoder hidden state. Fixed size. The bottleneck attention solves. |
| Teacher forcing | Use true tokens | Feed the ground-truth previous token at training time. Stabilizes learning. |
| Exposure bias | Train/test gap | Model trained on true tokens never practiced recovering from its own mistakes. |
| Beam search | Better decoding | Keep top-k partial sequences alive at each step instead of committing greedily. |
برای مطالعهی بیشتر
- Sutskever, Vinyals, Le (2014). Sequence to Sequence Learning with Neural Networks — مقالهی اصلی seq2seq؛ در چهار صفحه.
- Cho et al. (2014). Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation — مقالهای که GRU و ساختار رمزگذار-رمزگشا را معرفی کرد.
- Bahdanau, Cho, Bengio (2014). Neural Machine Translation by Jointly Learning to Align and Translate — مقالهی اتنشن؛ بلافاصله پس از این درس آن را بخوانید.
- PyTorch NLP from Scratch tutorial — کدهای قابل اجرا برای ساخت مدل seq2seq همراه با اتنشن.