
در تبلیغات مدلهای زبانی بزرگ (LLM)، پنجرههای کانتکست میلیونی به یک مزیت رقابتی تبدیل شدهاند. با این حال در محیطهای عملیاتی، بسیاری از توسعهدهندگان متوجه میشوند که مدلها در استخراج دادههای پراکنده یا تحلیل اسناد چندصدصفحهای دقت کافی را ندارند و اطلاعات قرارگرفته در میانهی متن را نادیده میگیرند.
این درس به شما نشان میدهد چطور ظرفیت واقعی پنجره کانتکست یک مدل را پیش از ورود به محیط پروداکشن اندازهگیری کنید. با استفاده از چارچوبهایی مانند NIAH، RULER و LongBench، متوجه خواهید شد که ظرفیت استدلال مؤثر مدل در متنهای طولانی معمولاً بسیار کمتر از سقف تبلیغاتی اعلامشده است.
اگر از داخل ایران به API ارائهدهندگان مطرح مانند OpenAI یا Anthropic دسترسی مستقیم ندارید و پرداخت ارزی یا تحریمهای دسترسی مانع آزمونهای پرهزینه میشوند، پیادهسازی آزمونهای سبک و سفارشی روی مدلهای باز به شما کمک میکند قبل از پرداخت هرگونه هزینه برای توکنهای انبوه، از رفتار مدل در دامنهی کاری خود مطمئن شوید.
مدل Gemini 3 Pro ادعای کانتکست 10M توکنی دارد. اما در 1M توکن، دقت آزمون 8-needle MRCR آن تا 26.3% افت میکند. عدد تبلیغاتی لزوماً معادل ظرفیت کاربردی نیست. ارزیابی کانتکست طولانی ظرفیت واقعی مدلی را که میخواهید به پروداکشن ببرید مشخص میکند.
صورت مسئله
قراردادی 200 صفحهای دارید و مدل انتخابی شما ادعای کانتکست 1M توکنی دارد. کل قرارداد را پیست میکنید و میپرسید: «بند فسخ قرارداد چیست؟» مدل جواب میدهد، اما پاسخش را از روی جلد سرهم میکند؛ چون بند فسخ در عمق 120k توکنی قرار گرفته، یعنی فراتر از جایی که مدل واقعاً روی آن اتنشن دارد.
این همان شکاف ظرفیت کانتکست در سال 2026 است. برگههای مشخصات فنی اعداد 1M یا 10M را نشان میدهند، اما واقعیت این است که تنها 60 تا 70 درصد آن قابل استفاده است؛ تازه همین «قابل استفاده بودن» هم به نوع تسک بستگی دارد:
- بازیابی (تکسوزن در انبار کاه): در مدلهای مرز دانایی (Frontier models) تا سقف تبلیغاتی تقریباً بینقص کار میکند.
- استدلال چندمرحلهای (Multi-hop) و تجمیع دادهها: در بیشتر مدلها فراتر از حدود 128k با افت شدید روبهرو میشود.
- استدلال روی فکتهای پراکنده: اولین تسکی است که از کار میافتد.
ارزیابی کانتکست طولانی این ابعاد را میسنجد. در این درس بنچمارکها را معرفی میکنیم، میگوییم هر کدام دقیقاً چه چیزی را میسنجند و چطور یک آزمون سوزن در انبار کاه اختصاصی برای دامنهی کاری خود بسازید.
مفاهیم پایه
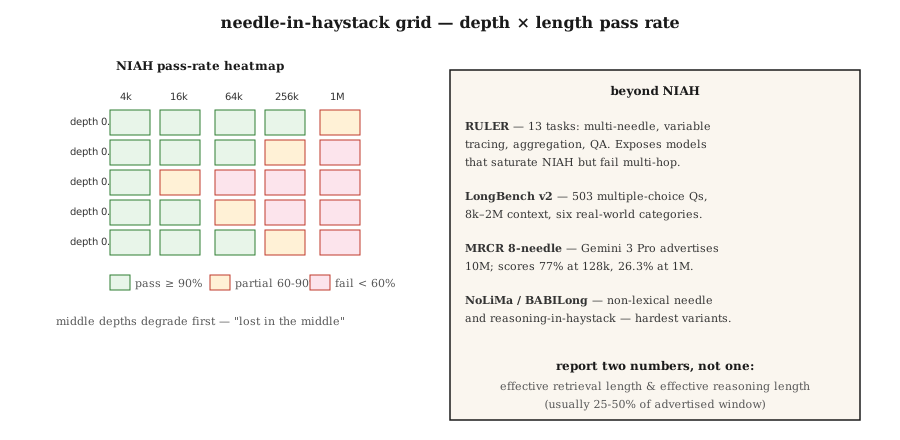
سوزن در انبار کاه (NIAH، سال 2023): یک فکت مشخص (مثلاً «کلمهی جادویی آناناس است») را در عمق حسابشدهای از یک کانتکست طولانی قرار دهید. از مدل بخواهید آن را پیدا کند. ترکیبهای مختلف «عمق × طول» را جاروب (Sweep) کنید. این همان بنچمارک اولیهی کانتکست طولانی است. مدلهای پیشرو امروزه در این آزمون اشباع شدهاند؛ بنابراین گذراندن آن یک خط پایهی لازم است، اما اصلاً کافی نیست.
بنچمارک RULER (انویدیا، 2024): شامل 13 نوع تسک در 4 دسته: بازیابی (تککلید / چندکلید / چندمقدار)، ردیابی چندمرحلهای (ردیابی متغیرها)، تجمیع (فراوانی کلمات مشترک) و پرسشوپاسخ (QA). طول کانتکست در آن قابل تنظیم است (از 4k تا بیش از 128k). این بنچمارک دست مدلهایی را که در NIAH نمرهی کامل میگیرند اما در استدلال چندمرحلهای شکست میخورند، رو میکند. در نسخهی سال 2024، از میان 17 مدلی که ادعای کانتکست بالای 32k داشتند، فقط نیمی از آنها کیفیت خود را در 32k حفظ کردند.
بنچمارک LongBench v2 (سال 2024): شامل 503 سؤال چهارگزینهای در کانتکستهایی با طول 8k تا 2M کلمه، در شش دستهی تسک: پرسشوپاسخ تکسندی، پرسشوپاسخ چندسندی، یادگیری درونکانتکستی (In-context learning) طولانی، مکالمهی طولانی، مخزن کد، و دادههای ساختیافتهی طولانی. این بنچمارک استاندارد عملیاتی برای بررسی رفتار مدلها در شرایط واقعی کانتکست طولانی است.
آزمون MRCR (حل ارجاع نامها در چند دور): بررسی ارجاعهای متنی درون مکالمات چندنوبتی در مقیاس بزرگ. در گونههای 8 سوزنه، 24 سوزنه و 100 سوزنه اجرا میشود و نشان میدهد مدل تا پیش از افت اتنشن، حداکثر چند فکت را میتواند همزمان مدیریت کند.
آزمون NoLiMa: سوزن غیرواژگانی (Non-lexical needle). در این آزمون، سوزن و پرامپت پرسش هیچ اشتراک واژگانی مستقیمی ندارند؛ بازیابی اطلاعات نیازمند یک گام استدلال معنایی است، بنابراین از NIAH معمولی بسیار سختتر است.
بنچمارک HELMET: چندین سند را پشت سر هم میچسباند و از یکی از آنها سؤالی مطرح میکند. این کار اتنشن انتخابی مدل را میسنجد.
بنچمارک BABILong: زنجیرههای استدلالی bAbI را داخل کانتکستهای نامربوط (انبار کاه) جاسازی میکند. هدف آن سنجش «استدلال در انبار کاه» است، نه صرفاً بازیابی اطلاعات.
در گزارشها دقیقاً چه معیارهایی ثبت شود؟
- پنجرهی کانتکست تبلیغاتی: عددی که در برگه مشخصات رسمی مدل نوشته شده است.
- طول بازیابی مؤثر: طولی از کانتکست که مدل در آزمون NIAH به یک آستانهی مشخص (مثلاً 90%) میرسد.
- طول استدلال مؤثر: طولی از کانتکست که مدل در آزمونهای چندمرحلهای یا تجمیع به همان آستانه دست پیدا میکند.
- منحنی افت کیفیت: نمودار دقت بر حسب طول کانتکست، رسمشده به تفکیک هر تسک.
همیشه دو عدد برای برگه مشخصات خود ثبت کنید: طول بازیابی مؤثر و طول استدلال مؤثر. معمولاً طول استدلال مؤثر، تنها بین 25 تا 50 درصد پنجرهی کانتکست تبلیغاتی است.
پیادهسازی
گام 1: ساخت آزمون NIAH سفارشی برای دامنهی کاری شما
فایل code/main.py را ببینید. اسکلت اصلی کد:
def build_haystack(filler_text, needle, depth_ratio, total_tokens):
    if not (0.0 <= depth_ratio <= 1.0):
        raise ValueError(f"depth_ratio must be in [0, 1], got {depth_ratio}")
    if total_tokens <= 0:
        raise ValueError(f"total_tokens must be positive, got {total_tokens}")

    filler_tokens = tokenize(filler_text)
    needle_tokens = tokenize(needle)
    if not filler_tokens:
        raise ValueError("filler_text produced no tokens")

    # تکرار متن پرکننده تا رسیدن به طول مناسب بدنه انبار کاه.
    body_len = max(total_tokens - len(needle_tokens), 0)
    while len(filler_tokens) < body_len:
        filler_tokens = filler_tokens + filler_tokens
    filler_tokens = filler_tokens[:body_len]

    insert_at = min(int(body_len * depth_ratio), body_len)
    haystack = filler_tokens[:insert_at] + needle_tokens + filler_tokens[insert_at:]
    return " ".join(haystack)


def score_niah(model, haystack, question, expected):
    answer = model.complete(f"Context: {haystack}\nQ: {question}\nA:", max_tokens=50)
return 1 if expected.lower() in answer.lower() else 0ترکیبهای depth_ratio ∈ {0, 0.25, 0.5, 0.75, 1.0} × total_tokens ∈ {1k, 4k, 16k, 64k} را پیمایش کنید. سپس نمودار حرارتی (Heatmap) نتایج را رسم کنید؛ این همان شناسنامهی NIAH مدل مدنظر شماست.
گام 2: نسخهی چندسوزنه (Multi-needle)
def build_multi_needle(filler, needles, total_tokens):
    depths = [0.1, 0.4, 0.7]
    chunks = [filler[:int(total_tokens * 0.1)]]
    for depth, needle in zip(depths, needles):
        chunks.append(needle)
        next_chunk = filler[int(total_tokens * depth): int(total_tokens * (depth + 0.3))]
        chunks.append(next_chunk)
    return " ".join(chunks)
پاسخ به سؤالهایی مثل «سه کلمهی جادویی چه بودند؟» نیازمند بازیابی هر سه مورد است. موفقیت در تکسوزن اصلاً به معنای موفقیت در چندسوزنه نیست.
گام 3: ردیابی متغیرها در چند مرحله (سبک RULER)
haystack = """X1 = 42. ... (filler) ... X2 = X1 + 10. ... (filler) ... X3 = X2 * 2."""
question = "What is X3?"
رسیدن به جواب نیازمند اتصال سه مرحله انتساب مقدار است. مدلهای پیشرو در کانتکست 128k اغلب در چنین تستی به دقت 50 تا 70 درصد سقوط میکنند.
گام 4: اجرای LongBench v2 روی زیرساخت خودتان
from datasets import load_dataset
longbench = load_dataset("THUDM/LongBench-v2")

def eval_model_on_longbench(model, subset="single-doc-qa"):
    tasks = [x for x in longbench["test"] if x["task"] == subset]
    correct = 0
    for x in tasks:
        answer = model.complete(x["context"] + "\n\nQ: " + x["question"], max_tokens=20)
        if normalize(answer) == normalize(x["answer"]):
            correct += 1
    return correct / len(tasks)
دقت را به تفکیک هر دسته گزارش کنید؛ میانگین نمرات کلی، تفاوتهای بزرگ میان تسکها را پنهان میکند.
تلهها
- اکتفا به ارزیابی NIAH: قبولی در NIAH در کانتکست 1M توکن هیچ ربطی به توانایی استدلال چندمرحلهای ندارد. همیشه RULER یا یک تست چندمرحلهای سفارشی اجرا کنید.
- نمونهبرداری یکنواخت از عمق: خیلی از پیادهسازیها فقط عمق وسط (depth=0.5) را تست میکنند. حتماً اعماق 0، 0.25، 0.5، 0.75 و 1.0 را بسنجید؛ پدیدهی «گم شدن در میانه» (Lost in the middle) کاملاً واقعی است.
- اشتراک واژگانی با متن پرکننده: اگر سوزن شما کلمات کلیدی مشترکی با متن پرکننده داشته باشد، بازیابی آن پیشپاافتاده میشود. از روشهای بدون اشتراک کلمهای مثل NoLiMa استفاده کنید.
- نادیده گرفتن تاخیر: پرامپتهای 1M توکنی بین 30 تا 120 ثانیه زمان پردازش اولیه (Prefill) نیاز دارند. همیشه زمان تا دریافت اولین توکن (TTFT) را در کنار دقت بسنجید.
- اعتماد به آمارهای اعلامشده از سمت ارائهدهندگان: شرکتهای OpenAI، Google و Anthropic همگی بنچمارکهای خودشان را منتشر میکنند. همیشه تستها را مستقل و روی کاربرد مدنظر خودتان بازآزمایی کنید.
کاربرد عملی
استک ابزارها در سال 2026:
| موقعیت | بنچمارک انتخابی |
|---|---|
| ارزیابی اولیهی سریع (Sanity check) | آزمون سفارشی NIAH در 3 عمق × 3 طول |
| انتخاب مدل برای پروداکشن | آزمون RULER (13 تسک) در طول کانتکست هدف |
| کیفیت پرسشوپاسخ در شرایط واقعی | زیرمجموعهی single-doc-QA از بنچمارک LongBench v2 |
| استدلال چندمرحلهای | بنچمارک BABILong یا ردیابی متغیر سفارشی |
| سیستمهای گفتگومحور و چت | آزمون MRCR با 8 سوزن در طول کانتکست هدف |
| آزمون رگرسیون هنگام ارتقای مدل | مجموعهتست داخلی ثابت از ترکیب NIAH + RULER، روی هر مدل جدید |
یک قانون سرانگشتی برای محیطهای پروداکشن: هرگز به پنجرهی کانتکست اعتماد نکنید، مگر اینکه حداقل آزمون NIAH بهعلاوهی یک تسک استدلالی را در طول مدنظرتان اجرا کرده باشید.
تحویل نهایی
خروجی را در مسیر outputs/skill-long-context-eval.md ذخیره کنید:
---
name: long-context-eval
description: Design a long-context evaluation battery for a given model and use case.
version: 1.0.0
phase: 5
lesson: 28
tags: [nlp, long-context, evaluation]
---

Given a target model, target context length, and use case, output:

1. Tests. NIAH depth × length grid; RULER multi-hop; custom domain task.
2. Sampling. Depths 0, 0.25, 0.5, 0.75, 1.0 at each length.
3. Metrics. Retrieval pass rate; reasoning pass rate; time-to-first-token; cost-per-query.
4. Cutoff. Effective retrieval length (90% pass) and effective reasoning length (70% pass). Report both.
5. Regression. Fixed harness, rerun on every model upgrade, surface deltas.

Refuse to trust a context window from the model card alone. Refuse NIAH-only evaluation for any multi-hop workload. Refuse vendor self-reported long-context scores as independent evidence.تمرینها
- ساده. یک آزمون NIAH با 3 عمق مختلف (0.25، 0.5، 0.75) در 3 طول (1k، 4k، 16k) بسازید. آن را روی هر مدلی که خواستید اجرا کنید و نرخ موفقیت را در قالب یک نمودار حرارتی 3×3 رسم کنید.
- متوسط. یک نسخهی 3 سوزنه اضافه کنید. بازیابی هر 3 مورد را در هر طول بسنجید و با نرخ موفقیت تکسوزنه در همان طول مقایسه کنید.
- سخت. یک تسک ردیابی متغیر (با سه گام: X1 → X2 → X3) بسازید و آن را میان 64k متن پرکننده قرار دهید. دقت را در 3 مدل پیشرو بسنجید و طول استدلال مؤثر هر مدل را گزارش کنید.
اصطلاحات کلیدی
| اصطلاح | چیزی که بقیه میگویند | معنای دقیق فنی |
|---|---|---|
| NIAH | سوزن در انبار کاه | قرار دادن یک فکت میان متن پرکننده و درخواست بازیابی آن از مدل. |
| RULER | نسخه ارتقایافته NIAH | مجموعهای شامل 13 تسک مختلف در حوزههای بازیابی، چندمرحلهای، تجمیع و QA. |
| کانتکست مؤثر | ظرفیت واقعی | طولی از کانتکست که در آن دقت بالاتر از آستانه باقی میماند. |
| گم شدن در میانه | سوگیری عمق | ضعف مدلها در اتنشن به محتوای قرارگرفته در بخش میانی ورودیهای طولانی. |
| چندسوزنه (Multi-needle) | چند فکت بهطور همزمان | قرار دادن چند فکت مختلف؛ آزمونی برای مدیریت همزمان اتنشن، نه صرفاً بازیابی تنها. |
| MRCR | حل ارجاع چنددورهای | ارجاعیابی متنی با 8، 24 یا 100 سوزن؛ برای مشخص کردن نقطه اشباع اتنشن مدل. |
| NoLiMa | سوزن غیرواژگانی | عدم اشتراک واژگانی مستقیم میان سوزن و پرامپت پرسش؛ نیازمند استدلال. |
برای مطالعهی بیشتر
- کامرات (2023). تحلیل آزمون سوزن در انبار کاه (Needle in a Haystack) — مخزن اصلی NIAH.
- هسیه و همکاران (2024). بنچمارک RULER: اندازه واقعی کانتکست مدلهای زبانی شما چقدر است؟ — بنچمارک چندوظیفهای.
- بای و همکاران (2024). بنچمارک LongBench v2 — ارزیابی کانتکست طولانی در شرایط واقعی.
- مدرسی و همکاران (2024). آزمون NoLiMa: سوزنهای غیرواژگانی — سوزنهای دشوارتر.
- کوراتوف و همکاران (2024). بنچمارک BABILong — استدلال در انبار کاه.
- لیو و همکاران (2024). گم شدن در میانه: مدلهای زبانی چگونه از کانتکستهای طولانی استفاده میکنند — مقالهی بررسی سوگیری عمق.