
در مدلهای اولیهی توالی به توالی (Seq2Seq)، فشردهسازی تمام بار معنایی جمله در یک وضعیت پنهان با طول ثابت، عملکرد مدل را در توالیهای طولانی بهشدت کاهش میداد. مکانیسم اتنشن (Attention Mechanism) این محدودیت ساختاری را کنار زد تا دکودر در هر گام به جای حدسزدن بر مبنای یک بردار ثابت، به کل توالی ورودی دسترسی پویا داشته باشد.
درک دقیق فرمولها و ابعاد تنسورها در روشهای باداناو و لونگ، پایهی ورود به معماریهای مدرنتر مثل ترنسفورمرها است؛ چرا که مفاهیم کلیدی Q/K/V ریشه در همین اتنشن کلاسیک دارند. پیادهسازی این درس محاسبات سبکی دارد و بدون نیاز به GPU ابری یا پردازندههای گرافیکی پرهزینه، روی همان CPU سیستم شخصی قابل پیادهسازی و آزمایش است.
دکودر دیگر چشمش را به خلاصهای فشرده تنگ نمیکند؛ حالا کل متن مبدأ را پیش رو دارد. از اینجا به بعد، همهچیز فقط اتنشن است و مهندسی.
صورت مسئله
درس 09 با یک شکست مستند و دقیق تمام شد: مدل انکودر-دکودرِ مبتنی بر GRU که روی یک مسئلهی سادهی کپیکردن آموزش دیده بود، در طول توالی 5 به دقت 89% رسید، اما در طول 80 دقتش در حد حدس تصادفی پایین آمد. علت این افت نه باگ آموزش، بلکه کاملاً ساختاری است: هر ذره از اطلاعاتی که انکودر به دست میآورد باید در یک وضعیت پنهان (hidden state) با اندازهی ثابت جا شود و دکودر هم هیچچیز دیگری جز آن را نمیبیند.
باداناو، چو و بنجیو در سال 2014 راهحلی سهخطی برای این مشکل ارائه دادند: بهجای ارسالِ صرفاً آخرین وضعیت انکودر به دکودر، همهی وضعیتهای پنهان انکودر را نگه دارید. در هر گام دکودر، میانگین وزنداری از وضعیتهای انکودر حساب کنید که وزنهایش میگویند: «دکودر در همین لحظه چقدر باید به موقعیت i در انکودر نگاه کند؟» این میانگین وزندار همان بافت (context) است و در هر گام دکودر تغییر میکند.
کل ایده همین است. ترنسفورمرها (Transformers) بسطش دادند؛ خوداتنشن (self-attention) آن را روی یک توالی واحد پیاده کرد و اتنشن چندسر (multi-head attention) اجرای همزمان و موازی آن را ممکن ساخت. بااینحال نسخهی سال 2014 همان موقع گلوگاه را شکست. وقتی این را درک کنید، جهش به سمت ترنسفورمرها صرفاً کاری مهندسی است، نه تحولی مفهومی.
مفاهیم پایه
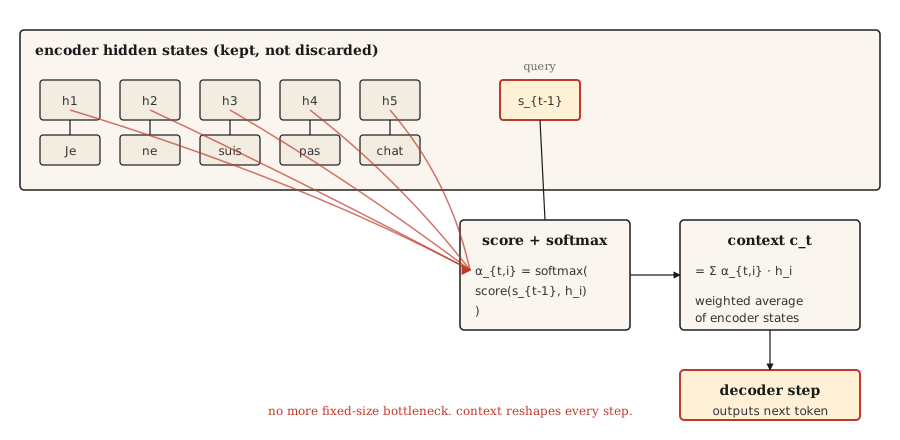
در هر گام دکودر t:
- وضعیت پنهان قبلی دکودر، یعنی
s_{t-1}را بهعنوان کوئری (query) در نظر بگیرید. - آن را در برابر تکتک وضعیتهای پنهان انکودر
h_1, ..., h_Tامتیازدهی کنید: یک عدد اسکالر به ازای هر موقعیت در انکودر. - روی امتیازها تابع سافتمکس (Softmax) بزنید تا وزنهای اتنشن
α_{t,1}, ..., α_{t,T}با مجموع 1 به دست آیند. - بردار بافت را بهصورت
c_t = Σ α_{t,i} * h_iمحاسبه کنید؛ یعنی میانگین وزندار وضعیتهای انکودر. - دکودر
c_tرا همراه با توکن خروجی قبلی میگیرد و توکن بعدی را تولید میکند.
اصل ماجرا همین میانگین وزندار است. وقتی دکودر میخواهد "Je" را به "I" ترجمه کند، به وضعیت انکودر روی کلمهی "Je" وزن بالا و به بقیه وزن پایینی میدهد. وقتی نوبت "not" میرسد، به "pas" وزن بالا میدهد. بردار بافت در هر گام شکل تازهای میگیرد.
ابعاد تنسورها (همان تلهای که گریبانگیر همه میشود)
اینجا جایی است که اجرای اولیهی اتنشن همیشه خراب میشود. این بخش را باحوصله بخوانید.
| مفهوم | ابعاد (Shape) | نکات |
|---|---|---|
وضعیتهای پنهان انکودر H |
(T_enc, d_h) |
اگر BiLSTM باشد: d_h = 2 * d_hidden |
وضعیت پنهان دکودر s_{t-1} |
(d_s,) |
یک بردار |
امتیاز اتنشن e_{t,i} |
اسکالر | یک عدد به ازای هر موقعیت انکودر |
وزن اتنشن α_{t,i} |
اسکالر | حاصل اعمال سافتمکس روی تمام iها |
بردار بافت c_t |
(d_h,) |
هماندازهی وضعیت انکودر |
امتیازدهی جمعی یا باداناو (Additive score). فرمول: e_{t,i} = v_α^T * tanh(W_a * s_{t-1} + U_a * h_i).
s_{t-1}دارای ابعاد(d_s,)وh_iدارای ابعاد(d_h,)است.W_aابعاد(d_attn, d_s)وU_aابعاد(d_attn, d_h)دارد.- حاصل جمع آنها داخل تابع tanh دارای ابعاد
(d_attn,)است. v_αدارای ابعاد(d_attn,)است. ضرب داخلی باv_αخروجی را به یک عدد اسکالر تبدیل میکند. تمام کارv_αهمین است. خبری از جادو نیست؛ همان تصویر کردن (projection) است که برداری با بعد اتنشن را به امتیازی اسکالر تبدیل میکند.
امتیازدهی ضربی یا لونگ (Multiplicative score). سه حالت دارد:
- ضرب نقطهای (
dot): فرمولe_{t,i} = s_t^T * h_i. پیششرط آنd_s == d_hاست؛ یک قید سفتوسخت. اگر انکودر دوطرفه است، دور این حالت را خط بکشید. - حالت عمومی (
general): فرمولe_{t,i} = s_t^T * W * h_iکه در آنWدارای ابعاد(d_s, d_h)است. این حالت قید برابری ابعاد را حذف میکند. - الحاقی (
concat): در اصل همان ساختار باداناو است و چون دو روش اول کمهزینهترند، کمتر سراغش میروند.
یک تلهی مهم میان باداناو و لونگ. باداناو از s_{t-1} (وضعیت دکودر قبل از تولید کلمهی جاری) استفاده میکند، اما لونگ به سراغ s_t (وضعیت دکودر بعد از تولید) میرود. جابهجا گرفتن این دو، خطاهای ریزی در گرادیان (gradient) ایجاد میکند که عیبیابیشان بسیار دشوار است. یکی از این دو مقاله را انتخاب کنید و پای قراردادش بمانید.
پیادهسازی
گام 1: اتنشن جمعی (باداناو)
import numpy as np


def additive_attention(decoder_state, encoder_states, W_a, U_a, v_a):
    projected_dec = W_a @ decoder_state
    projected_enc = encoder_states @ U_a.T
    combined = np.tanh(projected_enc + projected_dec)
    scores = combined @ v_a
    weights = softmax(scores)
    context = weights @ encoder_states
    return context, weights


def softmax(x):
    x = x - np.max(x)
    e = np.exp(x)
    return e / e.sum()
ابعاد تنسورهایتان را با جدول بالا تطبیق دهید. encoder_states دارای ابعاد (T_enc, d_h) است. projected_enc ابعاد (T_enc, d_attn) دارد. projected_dec دارای ابعاد (d_attn,) است و برادکست (broadcast) میشود. combined ابعاد (T_enc, d_attn) پیدا میکند. ابعاد scores برابر با (T_enc,)، ابعاد weights برابر با (T_enc,) و context دارای ابعاد (d_h,) است. آمادهی تحویل شد.
گام 2: روشهای dot و general لونگ
def dot_attention(decoder_state, encoder_states):
    scores = encoder_states @ decoder_state
    weights = softmax(scores)
    return weights @ encoder_states, weights


def general_attention(decoder_state, encoder_states, W):
    projected = W.T @ decoder_state
    scores = encoder_states @ projected
    weights = softmax(scores)
    return weights @ encoder_states, weights
هرکدام فقط سه خط. دلیل ماندگاری مقالهی لونگ همین بود: همان دقت در اکثر تسکها، با کدی بسیار کمتر.
گام 3: یک مثال عددی گامبهگام
فرض کنید سه وضعیت انکودر داریم (تقریباً معادل کلمات "cat" و "sat" و "mat") و وضعیت دکودر بیشترین شباهت را با کلمهی اول دارد؛ در این حالت توزیع اتنشن روی موقعیت 0 متمرکز میشود. اگر وضعیت دکودر طوری تغییر کند که با کلمهی آخر هماهنگ شود، تمرکز اتنشن به موقعیت 2 میرود. بردار بافت هم پابهپای آن تغییر جهت میدهد.
H = np.array([
    [1.0, 0.0, 0.2],
    [0.5, 0.5, 0.1],
    [0.1, 0.9, 0.3],
])

s_close_to_cat = np.array([0.9, 0.1, 0.2])
ctx, w = dot_attention(s_close_to_cat, H)
print("weights:", w.round(3))
weights: [0.464 0.305 0.231]ردیف اول برنده شد. حالا وضعیت دکودر را طوری تغییر دهید که به سومین وضعیت انکودر نزدیکتر شود و جابهجا شدن وزنها را ببینید. تمام اتنشن همین است: همترازی صریح (explicit alignment).
گام 4: چرا این مفهوم پل ورود به ترنسفورمرها است؟
مفاهیم بالا را به زبان Q/K/V برگردانید:
- کوئری (Query) = وضعیت دکودر
s_{t-1} - کلید (Key) = وضعیتهای انکودر (همان چیزی که امتیاز را در مقایسه با آن حساب میکنیم)
- مقدار (Value) = وضعیتهای انکودر (همان چیزی که به آن وزن میدهیم و جمع میبندیم)
در اتنشن کلاسیک، کلید و مقدار یکی هستند. خوداتنشن آنها را تفکیک میکند: میتوانید یک توالی را با تصویر کردنهای یادگرفتهشدهی متفاوت برای K و V، در برابر خودش کوئری بزنید. اتنشن چندسر همین کار را بهشکل موازی با تصویر کردنهای یادگرفتهشدهی گوناگون پیش میبرد. ترنسفورمرها این کل مرحله را بارها روی هم میچینند و RNNها را یکجا کنار میگذارند.
ریاضیات همان است. ابعاد هم همان است. پرش آموزشی از اتنشن باداناو به اتنشن ضرب نقطهای مقیاسشده (scaled dot-product attention)، بیشتر تغییر در نمادگذاری است تا مفهوم.
استفادهی عملی
PyTorch و TensorFlow اتنشن را بهصورت پیشفرض در خود دارند.
import torch
import torch.nn as nn

mha = nn.MultiheadAttention(embed_dim=128, num_heads=8, batch_first=True)
query = torch.randn(2, 5, 128)
key = torch.randn(2, 10, 128)
value = torch.randn(2, 10, 128)

output, weights = mha(query, key, value)
print(output.shape, weights.shape)
torch.Size([2, 5, 128]) torch.Size([2, 5, 10])این یک لایهی اتنشن ترنسفورمر است: یک بچ کوئری با 5 موقعیت، یک بچ کلید/مقدار با 10 موقعیت، هرکدام 128 بعدی، در قالب 8 سر. متغیر output همان کوئریهای جدید تقویتشده با بافت است. weights هم ماتریس همترازی 5 در 10 است که میتوانید بصریسازی کنید.
چرا اتنشن کلاسیک هنوز اهمیت دارد؟
- کاربرد آموزشی: نسخهی تکسر، تکلایه و مبتنی بر RNN همهی مفاهیم را کاملاً ملموس و روشن میکند.
- تسکهای توالی روی دستگاه (On-device) در شرایطی که ترنسفورمرها جا نمیشوند.
- مقالات سالهای 2014 تا 2017: بدون دانستن قرارداد باداناو، آنها را اشتباه خواهید خواند.
- تحلیل موشکافانهی همترازی در ترجمهی ماشینی: وزنهای خام اتنشن حتی در مدلهای ترنسفورمر ابزاری برای تفسیرپذیری به حساب میآیند و خواندنشان نیازمند درک ماهیت آنهاست.
تلهی تفسیرپذیری بر اساس وزنهای اتنشن
وزنهای اتنشن بهظاهر کاملاً قابلتفسیرند؛ مجموعشان روی تمام موقعیتها 1 میشود، میتوان نمودارشان را کشید، و عدد بالا یعنی «مدل به این نقطه نگاه کرده است». داوران مقالات عاشق این تحلیلها هستند.
اما ماجرا به این سادگی نیست. جین و والاس (Jain and Wallace, 2019) نشان دادند که در برخی تسکها میتوان توزیع وزنهای اتنشن را جابهجا کرد یا متغیرهای دلخواه دیگری را جایگزینشان ساخت، بیآنکه پیشبینیهای مدل تغییری کند. هرگز وزنهای اتنشن را بدون آزمون حذف ویژگی (ablation) یا بررسی خلاف واقع (counterfactual)، بهعنوان شواهد (evidence) استدلال مدل گزارش نکنید.
ذخیرهسازی پرامپت
متن زیر را در فایل outputs/prompt-attention-shapes.md ذخیره کنید:
---
name: attention-shapes
description: Debug shape bugs in attention implementations.
phase: 5
lesson: 10
---

Given a broken attention implementation, you identify the shape mismatch. Output:

1. Which matrix has the wrong shape. Name the tensor.
2. What its shape should be, derived from (d_s, d_h, d_attn, T_enc, T_dec, batch_size).
3. One-line fix. Transpose, reshape, or project.
4. A test to catch regressions. Typically: assert `output.shape == (batch, T_dec, d_h)` and `weights.shape == (batch, T_dec, T_enc)` and `weights.sum(dim=-1) close to 1`.

Refuse to recommend fixes that silently broadcast. Broadcast-hiding bugs surface later as silent accuracy degradation, the worst kind of attention bug.

For Bahdanau confusion, insist the decoder input is `s_{t-1}` (pre-step state). For Luong, `s_t` (post-step state). For dot-product, flag dimension mismatch between query and key as the most common first-time error.تمرینها
- ساده. قابلیت ماسک کردن (masking) را در
softmaxپیاده کنید تا توکنهای پدینگ (padding) در انکودر وزن اتنشن صفر بگیرند. این منطق را روی یک بچ با توالیهایی با طول متغیر بیازمایید. - متوسط. قابلیت اتنشن چندسر را به حالت
generalلونگ بیفزایید. بعدd_hرا به چند گروهn_headsتقسیم کنید، اتنشن را برای هر سر بهطور مستقل اجرا نمایید و در پایان نتایج را الحاق (concatenate) کنید. مطمئن شوید که حالت تکسر با پیادهسازی قبلی شما یکی باشد. - سخت. یک انکودر-دکودر GRU همراه با اتنشن باداناو را روی مسئلهی سادهی کپیکردن درس 09 آموزش دهید. نمودار دقت بر حسب طول توالی را رسم کنید و آن را با مدل پایهی بدون اتنشن بسنجید. باید ببینید که با بالا رفتن طول توالی فاصلهی عملکرد بیشتر میشود؛ امری که نشان میدهد اتنشن گلوگاه را از میان برداشته است.
اصطلاحات کلیدی
| اصطلاح | باور عامیانه | معنای فنی دقیق |
|---|---|---|
| اتنشن (Attention) | نگاه کردن به بخشهای مختلف | میانگین وزندار از توالی مقادیر، که وزنهایش بر پایهی شباهت کوئری و کلید به دست میآید. |
| کوئری، کلید، مقدار (Query, Key, Value) | QKV | سه بار تصویر کردن: کوئری میپرسد، کلید چیزی است که باید با آن تطبیق داده شود، و مقدار آنچه بازگردانده میشود. |
| اتنشن جمعی (Additive attention) | اتنشن باداناو | امتیازدهی پیشخور: v^T tanh(W q + U k). |
| اتنشن ضربی (Multiplicative attention) | ضرب نقطهای / حالت general لونگ | امتیاز بهصورت q^T k یا q^T W k محاسبه میشود. کمهزینهتر است و در اغلب تسکها دقت یکسانی دارد. |
| ماتریس همترازی (Alignment matrix) | همان تصویر جذاب | وزنهای اتنشن در قالب یک شبکهی (T_dec, T_enc). با دیدنش متوجه میشوید مدل به چه بخشهایی توجه کرده است. |
برای مطالعهی بیشتر
- مقاله اصلی: Bahdanau, Cho, Bengio (2014). Neural Machine Translation by Jointly Learning to Align and Translate.
- معرفی سه مدل امتیازدهی و مقایسهی آنها: Luong, Pham, Manning (2015). Effective Approaches to Attention-based Neural Machine Translation.
- هشداری دربارهی محدودیتهای تفسیرپذیری: Jain and Wallace (2019). Attention is not Explanation.
- آموزش گامبهگام و قابل اجرا با PyTorch در کتاب Dive into Deep Learning: Bahdanau Attention.