
در سیستمهای مبتنی بر مدلهای زبانی بزرگ، پاسخ دادن صرف به پرسشها کافی نیست؛ چالش اصلی، تشخیص توهم (Hallucination) و اطمینان از وفاداری پاسخ نسبت به اسناد بازیابیشده است. استنتاج زبان طبیعی (Natural Language Inference یا NLI) همان زیرساخت کمهزینهای است که به شما امکان میدهد بدون نیاز به فراخوانیهای سنگین و پرهزینهی LLM، درستی ادعاهای تولیدشده را در برابر متون مرجع اعتبارسنجی کنید.
علاوه بر پایش کیفیت در RAG، تسک NLI پایهی اصلی دستهبندی صفر-داده (Zero-shot classification) است؛ یعنی میتوانید بدون داشتن دادههای برچسبخورده برای آموزش، اسناد مختلف را بر اساس فرضیههای متنی دستهبندی کنید. با این تکنیک، فرآیندهایی که نیازمند آموزش مدلهای جداگانه بودند، با یک مدل ترنسفورمر آماده و چند خط کد استاندارد حل میشوند.
برای توسعهدهندگان در ایران، دانلود مدلها از Hugging Face و نصب کتابخانهها از PyPI گاهی با کندی یا اختلال مواجه میشود که میتوان این موضوع را با استفاده از میرورهای داخلی پایدارتر کرد. همچنین مدلهای سبکتر معرفیشده در این درس روی CPU یا سیستمهای شخصی بهخوبی اجرا میشوند و برای اجرای آنها به منابع پردازشی ابری خارجی وابسته نخواهید بود.
«t مستلزم h است» یعنی انسانی که t را میخواند، نتیجه میگیرد h درست است. استنتاج زبان طبیعی (Natural Language Inference یا NLI) وظیفهی پیشبینی یکی از سه حالتِ استلزام، تناقض یا بیطرف است. در ظاهر کسلکننده، اما در پروداکشن نقشی کلیدی و زیربنایی دارد.
صورت مسئله
یک سیستم خلاصهساز ساختهاید و خلاصهای تولید کرده است. از کجا مطمئن میشوید که این خلاصه حاوی توهم (hallucination) نیست؟
یک چتبات ساختهاید و پاسخ «بله» داده است. از کجا میدانید این پاسخ متکی بر متنِ بازیابیشده است؟
باید 10,000 مقالهی خبری را بر اساس موضوع دستهبندی کنید، اما هیچ برچسبی برای آموزش ندارید. آیا میتوانید از یک مدلِ موجود دوباره استفاده کنید؟
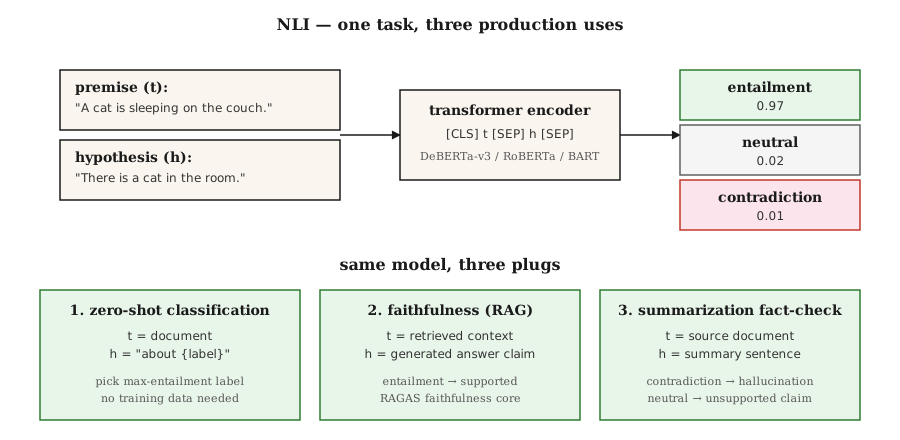
پاسخ هر سه مسئله به NLI برمیگردد. NLI این سؤال را مطرح میکند: با فرض یک مقدمه t و یک فرضیه h، آیا h از t استنتاج میشود (مستلزم آن است)، ناقض آن است، یا نسبت به آن بیطرف (نامرتبط) است؟
- بررسی توهم:
t= سند مبدأ،h= ادعای مطرحشده در خلاصه. عدم استلزام = توهم. - پاسخگویی مستند (Grounded QA):
t= بخش بازیابیشده،h= پاسخ تولیدشده. عدم استلزام = پاسخ ساختگی. - دستهبندی صفر-داده (Zero-shot classification):
t= سند،h= برچسب تبدیلشده به متن («این متن دربارهی ورزش است»). استلزام = برچسب پیشبینیشده.
یک تسک و سه کاربرد پروداکشنی. دقیقاً به همین دلیل است که زیر کاپوتِ تمام فریمورکهای ارزیابی RAG، یک مدل NLI کار میکند.
مفاهیم پایه
سه برچسب اصلی.
- استلزام (Entailment).
t→h. «گربه روی پادری است» مستلزم این است که «گربهای وجود دارد». - تناقض (Contradiction).
t→ ¬h. «گربه روی پادری است» با «هیچ گربهای وجود ندارد» متناقض است. - بیطرف (Neutral). هیچ نتیجهگیری خاصی در کار نیست. «گربه روی پادری است» نسبت به «گربه گرسنه است» بیطرف است.
این استلزام منطقیِ صلب نیست. NLI یعنی استنتاج در زبان طبیعی؛ یعنی آنچه یک خوانندهی معمولی برداشت میکند، نه منطق صوریِ خشک. در NLI، جملهی «علی سگش را به پیادهروی برد» مستلزم این است که «علی سگ دارد»؛ در حالی که منطق مرتبهی اول سختگیرانه تنها در صورتی این گزاره را میپذیرد که مفهوم مالکیت را بهشکل اصل موضوعه (axiom) تعریف کرده باشید.
مجموعهدادهها.
- SNLI (سال 2015). شامل 570 هزار جفت برچسبگذاریشده توسط انسان، با کپشن تصاویر به عنوان مقدمه. دامنهی کاربرد محدود.
- MultiNLI (سال 2017). شامل 433 هزار جفت در 10 ژانر مختلف. دیتاست استاندارد برای آموزش در سال 2026.
- ANLI (سال 2019). دیتای NLI رقابتی (Adversarial). نمونههایی که انسانها مشخصاً برای به اشتباه انداختن مدلهای موجود طراحی کردهاند؛ کاری بهمراتب دشوارتر.
- DocNLI، ConTRoL (سالهای 2020 تا 2021). مقدمههایی به اندازهی یک سند کامل برای سنجش استنتاج چندمرحلهای (multi-hop) و روابط دوربُرد.
معماری. یک انکودر ترنسفورمر (BERT، RoBERTa، DeBERTa) ورودی را به شکل [CLS] premise [SEP] hypothesis [SEP] میخواند. سپس بردار بازنمایی [CLS] به یک لایهی سافتمکس 3-حالته داده میشود. مدل را روی MNLI آموزش دهید، روی بنچمارکهای تفکیکشده ارزیابی کنید و در دادههای همتوزیع با آموزش به دقتی بالای 90% برسید.
دستهبندی صفر-داده با کمک NLI. با داشتن یک سند و چند برچسب کاندید، هر برچسب را به یک فرضیه تبدیل کنید («این متن دربارهی ورزش است»). احتمال استلزام را برای تکتک آنها حساب کرده و بیشترین مقدار را انتخاب کنید. این دقیقاً همان سازوکاری است که پایپلاین zero-shot-classification در Hugging Face بر پایهی آن کار میکند.
پیادهسازی
مرحلهی 1: اجرای یک مدل NLI از پیشآموزشدیده
from transformers import pipeline

nli = pipeline("text-classification",
               model="facebook/bart-large-mnli",
               top_k=None)  # return all labels; replaces deprecated return_all_scores=True

premise = "The cat is sleeping on the couch."
hypothesis = "There is a cat in the room."

result = nli({"text": premise, "text_pair": hypothesis})[0]
print(result)
# [{'label': 'entailment', 'score': 0.97},
#  {'label': 'neutral', 'score': 0.02},
#  {'label': 'contradiction', 'score': 0.01}]
برای NLI در محیط عملیاتی، مدلهای facebook/bart-large-mnli و MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli گزینههای پیشفرض و متنباز هستند. DeBERTa-v3 در صدر لیدربوردها قرار دارد.
مرحلهی 2: دستهبندی صفر-داده
zs = pipeline("zero-shot-classification", model="facebook/bart-large-mnli")

text = "The stock market rallied after the central bank cut interest rates."
labels = ["finance", "sports", "politics", "technology"]

result = zs(text, candidate_labels=labels)
print(result)
# {'labels': ['finance', 'politics', 'technology', 'sports'],
#  'scores': [0.92, 0.05, 0.02, 0.01]}
قالب پیشفرض به شکل "This example is about {label}." است که میتوانید آن را با آرگومان hypothesis_template سفارشیسازی کنید. بدون نیاز به دادهی آموزشی و بدون فاینتیونینگ؛ این رویکرد آمادهی استفاده است.
مرحلهی 3: ارزیابی وفاداری به متن (Faithfulness) در RAG
def is_faithful(answer, context, threshold=0.5):
    result = nli({"text": context, "text_pair": answer})[0]
    entail = next(s for s in result if s["label"] == "entailment")
    return entail["score"] > threshold
این سازوکار هستهی اصلی سنجهی وفاداری در RAGAS است: پاسخ تولیدشده را به ادعاهای تفکیکناپذیر (atomic) خرد کنید، هر ادعا را در برابر کانتکستِ بازیابیشده بسنجید و نسبت ادعاهایی را که رابطهی استلزام دارند گزارش دهید.
مرحلهی 4: پیادهسازی مفهومی یک کلاسیفایر NLI دستی
برای دیدن یک نمونهی ساده و آموزشی که فقط با کتابخانهی استاندارد پایتون نوشته شده، به فایل code/main.py نگاهی بیندازید: مقدمه و فرضیه از طریق اشتراک واژگانی به همراه شناسایی کلمات نفیکننده با هم مقایسه میشوند. این پیادهسازی توان رقابت با مدلهای ترنسفورمر را ندارد، اما شاکلهی اصلی مسئله را بهخوبی نشان میدهد: ورود دو متن، خروج یک برچسب 3-حالته، و تابع زیان (loss) از نوع آنتروپی متقاطع روی مجموعهی {entail, contradict, neutral}.
چالشها و خطاهای رایج
- میانبرهای فرضیهمحور (Hypothesis-only shortcuts). مدلها گاهی تنها با دیدن فرضیه به دقت حدود 60% روی SNLI میرسند؛ زیرا کلماتی مانند «not»، «nobody» و «never» معمولاً با برچسب تناقض همبستگی دارند. تست مدل تنها با فرضیه، بیسلاین قدرتمندی برای شناسایی نشت برچسب (label leakage) است.
- هیوریستیکِ اشتراک واژگانی. این فرض سادهلوحانه که «هر زیردنبالهای از جمله مستلزم خود جمله است» بنچمارک SNLI را پشت سر میگذارد، اما در HANS/ANLI کاملاً شکست میخورد. حتماً از بنچمارکهای رقابتی استفاده کنید.
- افت عملکرد در متون طولانی. مدلهای NLI تکجملهای هنگام مواجهه با مقدمههایی در سطح یک سند کامل، بیش از 20 نمرهی F1 افت میکنند. برای کانتکستهای طولانی، از مدلهای آموزشدیده روی DocNLI استفاده کنید.
- حساسیت به قالب در روش صفر-داده. تفاوت قالبها (مانند
"This example is about {label}"در برابر"{label}"یا"The topic is {label}") میتواند دقت را تا بیش از 10 درصد بالا یا پایین ببرد. حتماً قالب را بهدقت تنظیم کنید. - ناهمخوانی دامنه (Domain mismatch). دیتاست MNLI روی انگلیسی عمومی آموزش دیده است. متون حقوقی، پزشکی و علمی به مدلهای NLI تخصصی همان دامنه نیاز دارند (مانند SciNLI یا MedNLI).
کاربرد در دنیای واقعی
استک پیشنهادی در سال 2026:
| کاربرد | مدل |
|---|---|
| NLI همهمنظوره | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli |
| مدلهای سریع / لبه (Edge) | cross-encoder/nli-deberta-v3-base |
| دستهبندی صفر-داده (سبک) | facebook/bart-large-mnli |
| NLI در سطح سند | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli |
| چندزبانه | MoritzLaurer/multilingual-MiniLMv2-L6-mnli-xnli |
| تشخیص توهم در RAG | لایهی NLI داخل RAGAS یا DeepEval |
الگوی کلی در سال 2026: NLI چسب زخمِ همهکارهی فهم متن است. هر زمان با این سؤال روبهرو شدید که «آیا متن الف مؤید متن ب است؟» یا «آیا متن الف متن ب را نقض میکند؟»، قبل از اینکه سراغ یک فراخوانی LLM دیگر بروید، به NLI رجوع کنید.
تحویل پروژه
این فایل را در مسیر outputs/skill-nli-picker.md ذخیره کنید:
---
name: nli-picker
description: Pick an NLI model, label template, and evaluation setup for a classification / faithfulness / zero-shot task.
version: 1.0.0
phase: 5
lesson: 21
tags: [nlp, nli, zero-shot]
---

Given a use case (faithfulness check, zero-shot classification, document-level inference), output:

1. Model. Named NLI checkpoint. Reason tied to domain, length, language.
2. Template (if zero-shot). Verbalization pattern. Example.
3. Threshold. Entailment cutoff for the decision rule. Reason based on calibration.
4. Evaluation. Accuracy on held-out labeled set, hypothesis-only baseline, adversarial subset.

Refuse to ship zero-shot classification without a 100-example labeled sanity check. Refuse to use a sentence-level NLI model on document-length premises. Flag any claim that NLI solves hallucination — it reduces it; it does not eliminate it.تمرینها
- ساده. مدل
facebook/bart-large-mnliرا روی 20 سهتایی دستساز (مقدمه، فرضیه، برچسب) از هر سه کلاس اجرا و دقت آن را اندازهگیری کنید. تلههای رقابتی مبتنی بر «هیوریستیک زیردنباله» اضافه کنید (مانند «من کیک را نخوردم» در برابر «من کیک را خوردم») و ببینید آیا مدل فریب میخورد یا خیر. - متوسط. سه قالبِ
"This text is about {label}"،"The topic is {label}"و"{label}"را روی 100 تیتر خبری از AG News مقایسه کرده و دامنهی تغییرات دقت را گزارش کنید. - سخت. یک ابزار سنجش وفاداری پاسخ در RAG بسازید: خرد کردن پاسخ به ادعاهای اتمیک + بررسی NLI برای هر ادعا. سیستم را روی 50 پاسخ تولیدشدهی RAG همراه با کانتکست مرجع ارزیابی کنید و نرخ مثبت کاذب و منفی کاذب را در مقایسه با برچسبهای دستی بسنجید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای دقیق فنی |
|---|---|---|
| NLI | استنتاج زبان طبیعی | دستهبندی سهحالتهی رابطهی بین مقدمه و فرضیه. |
| RTE | تشخیص استلزام متنی | نام قدیمیتر NLI؛ دقیقاً همان وظیفه است. |
| Entailment | «t یعنی h» | خوانندهی معمولی با خواندن t نتیجه میگیرد که h درست است. |
| Contradiction | «t نقضکنندهی h است» | خوانندهی معمولی با خواندن t نتیجه میگیرد که h نادرست است. |
| Neutral | «نامشخص» | هیچ استنتاجی از t به h در هیچ جهتی ممکن نیست. |
| Zero-shot classification | استفاده از NLI به عنوان کلاسیفایر | تبدیل برچسبها به فرضیه، و انتخاب بالاترین احتمال استلزام. |
| Faithfulness | آیا پاسخ مستند است؟ | اجرای NLI روی زوج (کانتکستِ بازیابیشده، پاسخ تولیدشده). |
منابع بیشتر
- Bowman et al. (2015). A large annotated corpus for learning natural language inference — مجموعهدادهی SNLI.
- Williams, Nangia, Bowman (2017). A Broad-Coverage Challenge Corpus for Sentence Understanding through Inference — مجموعهدادهی MultiNLI.
- Nie et al. (2019). Adversarial NLI — بنچمارک ANLI.
- Yin, Hay, Roth (2019). Benchmarking Zero-shot Text Classification — بررسی رویکرد استفاده از NLI بهعنوان کلاسیفایر.
- He et al. (2021). DeBERTa: Decoding-enhanced BERT with Disentangled Attention — مدل پرکاربرد NLI در سال 2026.