
استخراج اطلاعات از متن زمانی که از نام صریح نهادها استفاده میشود کار آسانی است؛ اما در زبان طبیعی افراد و شرکتها اغلب با ضمایری مانند «او»، «آنها» یا توصیفهایی نظیر «مدیرعامل» یا «این سازمان» خطاب میشوند. بدون تشخیص اینکه هر اشاره به کدام موجودیت برمیگردد، پایپلاینهای بازشناسی موجودیتهای نامدار (NER) بخش بزرگی از اطلاعات کلیدی سند را از دست میدهند.
رفع ابهام مرجع (Coreference Resolution) همان حلقهی گمشدهای است که ارجاعات سطحی و پراکندهی متن را شناسایی کرده و آنها را به موجودیتهای واقعی در دنیای خارج متصل میکند. تسلط بر این تکنیک برای طراحی سامانههای پاسخگویی به سؤال، خلاصهسازی و ساخت گرافهای دانش دقیق در زبانهای مختلف از جمله فارسی و انگلیسی ضروری است.
«به او زنگ زد. جواب نداد. دکتر ناهار بود.» سه ارجاع به دو نفر، بدون اینکه نام کسی برده شود. رفع ابهام مرجع (Coreference Resolution) مشخص میکند کی به کیست.
صورتمسئله
تمام اشارهها به شرکت Apple را از یک مقالهی 300کلمهای استخراج کنید. وقتی در متن مستقیماً واژهی «Apple» آمده کار ساده است؛ اما وقتی میگوید «این شرکت»، «آنها»، «غول فناوری کوپرتینو» یا «کمپانی جابز»، کار گره میخورد. اگر نتوانید این اشارهها را به همان موجودیت واحد پیوند دهید، پایپلاین NER شما 60 تا 80 درصد ارجاعها را از دست میدهد.
رفع ابهام مرجع تمام عبارتهایی را که به یک موجودیت یکسان در دنیای واقعی اشاره دارند، درون یک خوشه قرار میدهد. این کار در واقع چسب اتصال پردازش زبان طبیعیِ سطحِ متن (مثل NER و تجزیهی نحوی) به لایههای معنایی پاییندستی (مانند استخراج اطلاعات، سامانههای پاسخگویی به پرسش، خلاصهسازی و گرافهای دانش) است.
چرا در سال 2026 اهمیت دارد:
- خلاصهسازی: تفاوت میان «مدیرعامل اعلام کرد...» و «تیم کوک اعلام کرد...»؛ خلاصه باید نام مدیرعامل را ذکر کند.
- پاسخگویی به پرسشها: برای پاسخ به «او به چه کسی زنگ زد؟»، ابتدا باید بدانیم «او» کیست.
- استخراج اطلاعات: اگر گراف دانش عبارتهای «PER1 اپل را تأسیس کرد» و «جابز اپل را تأسیس کرد» را دو مدخل جداگانه در نظر بگیرد، خروجی نادرست است.
- استخراج اطلاعات از چندین سند: merge کردن اشارهها در مقالههای مختلفی که به یک رویداد واحد پرداختهاند، از جنس رفع ابهام مرجع بینسندی (Cross-document coreference) است.
مفاهیم کلیدی
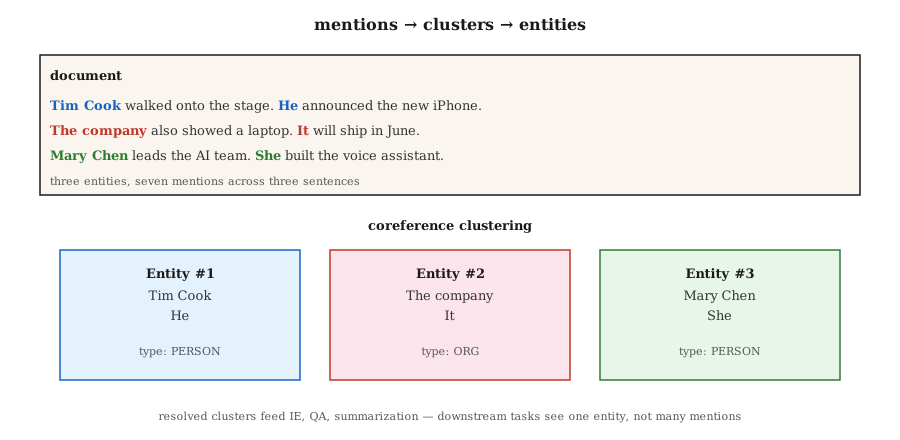
مسئله. ورودی: یک سند. خروجی: خوشهبندی اشارهها (بخشهایی از متن یا Spans) بهطوریکه هر خوشه به یک موجودیت مشخص اشاره کند.
انواع اشاره (Mention types):
- موجودیت نامدار (Named entity): «تیم کوک»
- اسمی (Nominal): «مدیرعامل»، «این شرکت»
- ضمیری (Pronominal): «او»، «آنها»، «آن»
- بدل (Appositive): «تیم کوک، مدیرعامل اپل،»
معماریها:
- قاعدهمحور (Hobbs, 1978): رفع ابهام ضمیرها بر پایهی درخت نحوی و با قواعد گرامری. یک خطپایهی خوب که در زمینهی ضمایر هنوز هم شکستدادنش بهطرز شگفتآوری سخت است.
- دستهبندی جفتاشاره (Mention-pair classifier): برای هر جفت اشارهی ، پیشبینی اینکه آیا هممرجع هستند یا نه. سپس خوشهبندی با کلوژر متعدی (Transitive closure). این روش تا پیش از سال 2016 روش استاندارد بود.
- رتبهبندی اشاره (Mention-ranking): برای هر اشاره، مرجعهای قبلی احتمالی (از جمله گزینهی «بدون مرجع») رتبه داده میشوند و بهترین گزینه انتخاب میشود.
- سرتاسری بر پایهی بازه (Span-based end-to-end / Lee et al., 2017): مبتنی بر انکودر ترنسفورمر. تمام بازههای کاندیدا تا یک سقف طولی مشخص فهرست میشوند؛ امتیاز اشاره بودن آنها محاسبه و احتمال مرجع بودن برای هر بازه پیشبینی میشود. در نهایت خوشهبندی بهصورت حریصانه (Greedy) انجام میگیرد. این ساختار انتخاب پیشفرض و مدرن امروزی است.
- زایشی (از سال 2024 به بعد): پرامپت دادن به یک مدل زبانی بزرگ: «تمام ضمایر این متن و مرجع هر کدام را فهرست کن». برای موارد ساده عالی کار میکند، اما روی سندهای طولانی و اشارههای کمتکرار به چالش میخورد.
معیارهای ارزیابی. چون هیچ معیار واحدی کیفیت خوشهبندی را کامل نشان نمیدهد، پنج معیار استاندارد (MUC، B³، CEAF، BLANC، LEA) به کار میروند. میانگین سه معیار اول با عنوان CoNLL F1 گزارش میشود. بهترین نتیجهی کنونی (SOTA) در سال 2026 روی بنچمارک CoNLL-2012 حدود 83 F1 است.
موارد چالشبرانگیز شناختهشده:
- توصیفهای معرفه که به موجودیتهای معرفیشده در چندین صفحهی قبل برمیگردند.
- ارجاع پلزننده (Bridging anaphora)؛ مثلاً عبارت «چرخها» که به خودرویی که پیشتر ذکر شده اشاره دارد.
- مرجعهای ناآشکار (Zero anaphora) در زبانهایی مانند چینی و ژاپنی.
- پیشمرجعی (Cataphora) یا آمدن ضمیر پیش از مرجع: «وقتی او وارد شد، مریم لبخند زد.»
پیادهسازی
گام 1: مدل عصبی ازپیشآموزشدیده برای رفع ابهام مرجع (AllenNLP / spaCy-experimental)
import spacy
nlp = spacy.load("en_coreference_web_trf")   # experimental model
doc = nlp("Apple announced new products. The company said it would ship them soon.")
for cluster in doc._.coref_clusters:
    print(cluster, "->", [m.text for m in cluster])
در یک سند طولانیتر، خروجی چیزی شبیه به این خواهد بود:
- خوشهی 1: [Apple, The company, it]
- خوشهی 2: [new products, them]
گام 2: رفعکنندهی ضمیر قاعدهمحور (برای یادگیری)
برای مشاهدهی پیادهسازی متکی صرف به کتابخانهی استاندارد پایتون، فایل code/main.py را ببینید:
- استخراج اشارهها: موجودیتهای نامدار (بازههایی با حروف بزرگ)، ضمایر (جستوجو در دیکشنری)، توصیفهای معرفه («the X»).
- برای هر ضمیر، K اشارهی قبلی بررسی و بر این اساس امتیازدهی میشوند:
- تطابق جنسیت و شمار (روش هیوریستیک)
- نزدیکی (اشارهی نزدیکتر برنده است)
- نقش نحوی (اولویت با نهاد یا فاعل)
- پیوند به مرجعی که بالاترین امتیاز را کسب کند.
این روش قابل رقابت با مدلهای عصبی نیست؛ اما فضای جستوجو و تصمیمهایی را که یک مدل سرتاسری باید بگیرد بهخوبی نشان میدهد.
گام 3: استفاده از مدلهای زبانی برای رفع ابهام مرجع
prompt = f"""Text: {text}

List every pronoun and noun phrase that refers to a person or company.
Cluster them by what they refer to. Output JSON:
[{{"entity": "Apple", "mentions": ["Apple", "the company", "it"]}}, ...]
"""
دو حالت خطا که باید مراقبشان باشید: اول، merge کردن بیش از حد توسط مدلهای زبانی (مثلاً یکی گرفتن «him» و «her» درحالیکه به دو فرد مجزا اشاره دارند). دوم، نادیدهگرفتن خاموش برخی اشارهها در متنهای طولانی. همیشه خروجی را با آفست کاراکتری بازهها (Span offsets) اعتبارسنجی کنید.
گام 4: ارزیابی
اسکریپت استاندارد conll-2012 معیارهای MUC، B³ و CEAF-φ4 را محاسبه و میانگین آنها را گزارش میکند. برای ارزیابی داخلی، کار را با دقت (Precision) و بازخوانی (Recall) در سطح بازهها روی مجموعهی تست برچسبگذاریشده شروع کنید، سپس امتیاز F1 اتصال اشارهها (Mention-linking) را اضافه کنید.
خطاهای رایج
- انفجار تکعضویها (Singleton explosion): بعضی سیستمها هر اشاره را یک خوشهی مستقل در نظر میگیرند. معیار B³ به این خطا آسان میگیرد، اما MUC آن را جریمه میکند. همیشه هر سه معیار را همزمان بررسی کنید.
- افت کیفیت ضمایر در بافتهای طولانی: در سندهای بالای 2,000 توکن، امتیاز F1 حدود 15 واحد افت میکند. متنها را با دقت قطعهبندی (Chunk) کنید.
- پیشفرضهای جنسیتی: قواعد هاردکدشدهی جنسیتی روی ارجاعهای نانباینری، سازمانها و حیوانات پاسخگو نیستند. از مدلهای آموزشدیده یا روشهای امتیازدهی خنثی استفاده کنید.
- انحراف مدلهای زبانی در اسناد بلند: یک فراخوانی سادهی API نمیتواند اشارهها را در بیش از 50 پاراگراف بدون خطا خوشهبندی کند. از روش پنجرهی لغزان (Sliding-window) همراه با merge استفاده کنید.
کاربرد در عمل
ترکیب ابزارهای پیشنهادی در سال 2026:
| سناریو | انتخاب مناسب |
|---|---|
| انگلیسی، سند تکی | en_coreference_web_trf (از spaCy-experimental) یا مدل عصبی AllenNLP |
| چندزبانه | SpanBERT یا XLM-R آموزشدیده روی OntoNotes یا CoNLL چندزبانه |
| رفع ابهام رویدادها بین چند سند | مدلهای سرتاسری تخصصی (SOTA سالهای 2025 تا 2026) |
| خطپایهی سریع با مدلهای زبانی | GPT-4o یا Claude همراه با پرامپت خروجی ساختاریافته برای رفع ابهام مرجع |
| سیستمهای گفتوگوی پروداکشن | روش قاعدهمحور رزرو (Fallback) + مدل عصبی اصلی + بازبینی دستی برای موارد حیاتی |
الگوی پیادهسازی عملیاتی در سال 2026: ابتدا NER را اجرا کنید، سپس رفع ابهام مرجع را انجام دهید و در نهایت خوشههای مرجع را در موجودیتهای NER ادغام (merge) کنید. با این کار، تسکهای پاییندستی بهجای مواجهه با چندین اشاره، به ازای هر خوشه با یک موجودیت واحد روبهرو میشوند.
تحویل نهایی
محتوا را در فایل outputs/skill-coref-picker.md ذخیره کنید:
---
name: coref-picker
description: Pick a coreference approach, evaluation plan, and integration strategy.
version: 1.0.0
phase: 5
lesson: 24
tags: [nlp, coref, information-extraction]
---

Given a use case (single-doc / multi-doc, domain, language), output:

1. Approach. Rule-based / neural span-based / LLM-prompted / hybrid. One-sentence reason.
2. Model. Named checkpoint if neural.
3. Integration. Order of operations: tokenize → NER → coref → downstream task.
4. Evaluation. CoNLL F1 (MUC + B³ + CEAF-φ4 average) on held-out set + manual cluster review on 20 documents.

Refuse LLM-only coref for documents over 2,000 tokens without sliding-window merge. Refuse any pipeline that runs coref without a mention-level precision-recall report. Flag gender-heuristic systems deployed in demographically diverse text.تمرینها
- ساده. رفعکنندهی قاعدهمحور موجود در
code/main.pyرا روی 5 پاراگراف دستساز اجرا کنید. دقت اتصال اشارهها را در مقایسه با دادههای مرجع بسنجید. - متوسط. یک مدل عصبی ازپیشآموزشدیده را روی یک مقالهی خبری اجرا کنید. خوشهها را با برچسبگذاری دستی خودتان مقایسه کنید. مدل در چه جاهایی اشتباه کرد؟
- پیشرفته. یک پایپلاین NER تقویتشده با رفع ابهام مرجع بسازید: اول NER، سپس merge کردن بر اساس خوشههای مرجع. میزان بهبود پوشش موجودیتها را روی 100 مقاله در مقایسه با حالت NERِ تنها اندازه بگیرید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای دقیق علمی |
|---|---|---|
| اشاره (Mention) | ارجاع یا اشاره در متن | بازهای از متن که به یک موجودیت دلالت دارد (نام، ضمیر، عبارت اسمی). |
| مرجع (Antecedent) | چیزی که «آن» به آن برمیگردد | اشارهی قبلی در متن که اشارهی بعدی با آن هممرجع است. |
| خوشه (Cluster) | اشارههای یک موجودیت | مجموعهای از اشارهها که همگی به یک موجودیت واقعی در دنیای خارج دلالت دارند. |
| پسمرجعی (Anaphora) | اشاره به قبل | اشارهی بعدی به عبارتی در بخشهای قبلی برمیگردد («او» ← «جان»). |
| پیشمرجعی (Cataphora) | اشاره به بعد | اشارهی قبلی به عبارتی در بخشهای بعدی برمیگردد («وقتی او رسید، جان...»). |
| ارجاع پلزننده (Bridging) | اشارهی ضمنی | «یک ماشین خریدم. چرخهایش خراب بود.» (چرخهای «آن» ماشین). |
| امتیاز CoNLL F1 | عدد روی لیدربوردها | میانگین نمرات F1 حاصل از معیارهای MUC، B³ و CEAF-φ4. |
برای مطالعهی بیشتر
- کتاب پردازش زبان و گفتار Jurafsky & Martin (ویرایش سوم)، فصل 26 — Coreference Resolution and Entity Linking؛ مرجع و سرفصل آموزشی استاندارد.
- Lee et al. (2017). End-to-end Neural Coreference Resolution؛ مدل سرتاسری مبتنی بر بازه.
- Joshi et al. (2020). SpanBERT؛ پیشآموزش تخصصی برای بهبود عملکرد رفع ابهام مرجع.
- Pradhan et al. (2012). CoNLL-2012 Shared Task؛ بنچمارک استاندارد ارزیابی.
- Hobbs (1978). Resolving Pronoun References؛ مقالهی کلاسیک روشهای قاعدهمحور.