
حجم محتوای متنی، مقالههای علمی و گزارشهای خبری بسیار فراتر از زمان مطالعهی روزمرهی ماست. خلاصهسازی خودکار متن (Text Summarization) ابزار اصلی برای استخراج اطلاعات کلیدی در چند ثانیه است. با این حال، تفاوت میان انتخاب جملات کلیدی اصلی و بازنویسی مفهوم متن معمولاً نادیده گرفته میشود که به تولید نتایج گمراهکننده یا حتی توهم اطلاعات ناموجود ختم میگردد.
در این درس هر دو پارادایم اصلی را بهصورت عملی پیادهسازی میکنید: خلاصهسازی استخراجی (Extractive) با الگوریتم مبتنی بر گراف TextRank که خروجی امن و بدون ریسک توهم میدهد، و خلاصهسازی انتزاعی (Abstractive) با مدل انکودر-دیکودر BART که متنی روان و بازنویسیشده تولید میکند. در ادامه معیارهای ارزیابی مانند ROUGE و روشهای سنجش صحت فکتها (Factuality) را بررسی خواهیم کرد تا سامانهی خلاصهسازی شما در محیط پروداکشن قابل اعتماد باشد.
اگر برای دانلود مدلهای پیشآموزشدیده از Hugging Face از داخل ایران اقدام میکنید، توجه داشته باشید که دریافت وزنها گاهی با افت سرعت یا ناپایداری روبهرو میشود. مدلهای سبکی مانند BART یا پیادهسازیهای پایهای TextRank روی پردازندهی مرکزی (CPU) یا تراشههای Apple Silicon نیز بدون نیاز به کارتهای گرافیک ابری گرانقیمت بهخوبی اجرا میشوند.
سامانههای استخراجی به شما میگویند متن چه گفته است؛ سامانههای انتزاعی میگویند منظور نویسنده چه بوده است. دو مسئلهی کاملاً متفاوت با چالشها و خطاهای متفاوت.
صورت مسئله
یک مقالهی خبری 2000 کلمهای در فید شما ظاهر میشود و شما چکیدهای 120 کلمهای از آن میخواهید. دو راه پیش رو دارید: یا سه تا از مهمترین جملههای مقاله را گلچین کنید (استخراجی یا Extractive)، یا کل مطلب را با کلمات خودتان بازنویسی کنید (انتزاعی یا Abstractive). هر دو روش را خلاصهسازی (Summarization) مینامند، اما در اصل با دو مسئلهی کاملاً متفاوت سروکار داریم.
خلاصهسازی استخراجی یک مسئلهی رتبهبندی (Ranking) است: به تکتک جملهها امتیاز بدهید و k جملهی برتر را برگردانید. خروجی همیشه از نظر گرامری درست است، چون عیناً از متن برداشته میشود. ریسک اصلیاش جا انداختن نکاتی است که در جایجای مقاله پراکندهاند.
خلاصهسازی انتزاعی یک مسئلهی تولید متن (Generation) است: یک ترنسفورمر متنی تازه تولید میکند که مشروط به ورودی است. خروجی، متنی روان و فشرده است، اما ممکن است فکتهایی را توهم (Hallucinate) کند که اصلاً در منبع نبودهاند. ریسک بزرگ این روش، بافتن اطلاعات نادرست با اعتمادبهنفس بالاست.
در این درس هر دو سیستم را میسازیم و حالتهای شکست (Failure modes) ویژهی هرکدام را بررسی میکنیم.
مفاهیم پایه
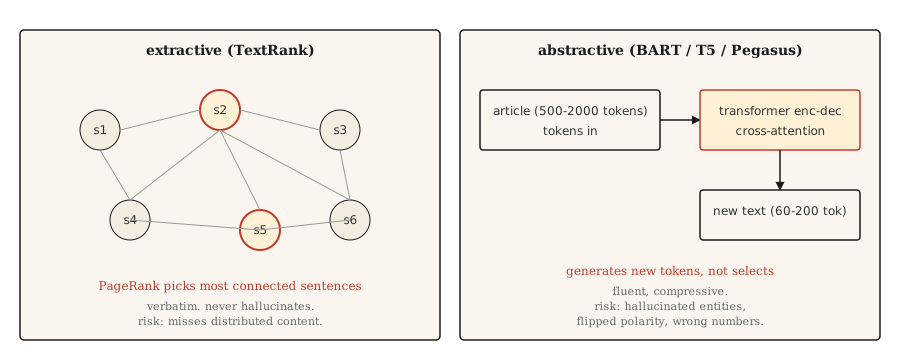
استخراجی. مقاله را مثل گرافی در نظر بگیرید که در آن جملهها گره و شباهت میان آنها یال است. الگوریتم PageRank (یا چیزی شبیه به آن) را روی گراف اجرا کنید تا جملهها را بر اساس میزان ارتباطشان با بقیهی متن امتیازدهی کند. جملاتی که بالاترین امتیاز را بیاورند خلاصه را تشکیل میدهند. پیادهسازی مرجع و کلاسیک این روش TextRank است (میهالچا و تارائو، 2004).
انتزاعی. یک مدل انکودر-دیکودر ترنسفورمر (مثل BART، T5 یا Pegasus) را روی جفتهای «سند-خلاصه» فاینتیونینگ کنید. در زمان استنتاج، مدل متن را میخواند و خلاصه را توکنبهتوکن از طریق کراس-اتنشن (Cross-attention) تولید میکند. بهویژه مدل Pegasus از هدف پیشآموزش «حذف جملات مهم» (Gap-sentence) استفاده میکند که باعث میشود حتی بدون فاینتیونینگ سنگین، در خلاصهسازی عالی عمل کند.
ارزیابی با ROUGE (معیار ارزیابی خلاصهسازیِ معطوف به بازخوانی یا Recall-Oriented Understudy for Gisting Evaluation). معیارهای ROUGE-1 و ROUGE-2 همپوشانی تکواژهها (Unigram) و دوواژهها (Bigram) را میسنجند. معیار ROUGE-L طولانیترین زیردنبالهی مشترک (LCS) را ارزیابی میکند. هرچه عدد بالاتر باشد بهتر است؛ امتیاز ROUGE-L برابر 40 «خوب» و 50 «استثنایی» است. همهی مقالهها هر سه را گزارش میکنند. برای محاسبه از پکیج rouge-score استفاده کنید.
پیادهسازی
گام 1: TextRank (استخراجی)
import math
import re
from collections import Counter


def sentence_split(text):
    return re.split(r"(?<=[.!?])\s+", text.strip())


def similarity(s1, s2):
    w1 = Counter(s1.lower().split())
    w2 = Counter(s2.lower().split())
    intersection = sum((w1 & w2).values())
    denom = math.log(len(w1) + 1) + math.log(len(w2) + 1)
    if denom == 0:
        return 0.0
    return intersection / denom


def textrank(text, top_k=3, damping=0.85, iterations=50, epsilon=1e-4):
    sentences = sentence_split(text)
    n = len(sentences)
    if n <= top_k:
        return sentences

    sim = [[0.0] * n for _ in range(n)]
    for i in range(n):
        for j in range(n):
            if i != j:
                sim[i][j] = similarity(sentences[i], sentences[j])

    scores = [1.0] * n
    for _ in range(iterations):
        new_scores = [1 - damping] * n
        for i in range(n):
            total_out = sum(sim[i]) or 1e-9
            for j in range(n):
                if sim[i][j] > 0:
                    new_scores[j] += damping * sim[i][j] / total_out * scores[i]
        if max(abs(s - ns) for s, ns in zip(scores, new_scores)) < epsilon:
            scores = new_scores
            break
        scores = new_scores

    ranked = sorted(range(n), key=lambda k: scores[k], reverse=True)[:top_k]
    ranked.sort()
    return [sentences[i] for i in ranked]
دو نکته شایستهی یادآوری است: تابع شباهت از اشتراک کلماتِ مقیاسشده با لگاریتم بهره میبرد که نسخهی اصلی TextRank است. شباهت کسینوسی بر روی بردارهای TF-IDF هم جواب میدهد. ضریب میرایی (Damping factor) معادل 0.85 و تعداد تکرارها نیز همان مقادیر پیشفرض PageRank هستند.
گام 2: مدل انتزاعی با BART
from transformers import pipeline

summarizer = pipeline("summarization", model="facebook/bart-large-cnn")

article = """(long news article text)"""

summary = summarizer(article, max_length=120, min_length=60, do_sample=False)
print(summary[0]["summary_text"])
مدل BART-large-CNN روی دادههای CNN/DailyMail فاینتیونینگ شده است و در همان حالت اولیه خلاصههایی به سبک ژورنالیستی تحویل میدهد. برای حوزههای دیگر (مقالههای علمی، دیالوگها، اسناد حقوقی)، از چکپوینت متناظر در Pegasus استفاده کنید یا آن را روی دادههای حوزهی مقصد فاینتیونینگ کنید.
گام 3: ارزیابی با ROUGE
from rouge_score import rouge_scorer

scorer = rouge_scorer.RougeScorer(["rouge1", "rouge2", "rougeL"], use_stemmer=True)
scores = scorer.score(reference_summary, generated_summary)
print({k: round(v.fmeasure, 3) for k, v in scores.items()})
همیشه ریشهیابی کلمات (Stemming) را فعال کنید؛ وگرنه واژههایی مثل "running" و "run" دو کلمهی متفاوت شمرده میشوند و ROUGE نمرهی کمتری نسبت به واقعیت محاسبه میکند.
فراتر از ROUGE (ارزیابی خلاصهسازی در سال 2026)
معیار ROUGE بیست سال شاخص غالب خلاصهسازی بوده، اما در سال 2026 بهتنهایی کافی نیست. فراتحلیل بزرگی روی مقالههای تولید متن طبیعی (NLG) نشان میدهد:
- BERTScore (شباهت امبدینگ متنی) تا اواخر 2023 جا افتاد و حالا در بیشتر مقالههای خلاصهسازی کنار ROUGE گزارش میشود.
- BARTScore ارزیابی را یک مسئلهی تولید میبیند: به این صورت به خلاصه امتیاز میدهد که یک مدل BART پیشآموزشدیده چقدر احتمال میدهد با داشتن متن مبدأ، چنین خلاصهای تولید شود.
- MoverScore (فاصلهی زمینپیما روی امبدینگهای متنی) در سال 2025 به صدر بنچمارکهای خلاصهسازی رسید، چون همپوشانی معنایی را بسیار بهتر از ROUGE ثبت میکند.
- روشهای FactCC و وفاداری مبتنی بر پرسشوپاسخ (QA-based faithfulness) که در سالهای 2021 تا 2023 رایج بودند، امروزه اغلب با G-Eval جایگزین شدهاند (زنجیرهای از پرامپتهای GPT-4 که انسجام، سازگاری، روانی و مرتبط بودن را با استدلال زنجیرهی تفکر میسنجد).
- در صورت طراحی دقیق ملاکها (Rubrics)، روشهای داوری مبتنی بر مدل زبانی مانند G-Eval در حدود 80% موارد با قضاوت انسان تطابق دارند.
توصیه برای محیط پروداکشن: ROUGE-L را برای مقایسه با کارهای گذشته، BERTScore را برای همپوشانی معنایی، و G-Eval را برای انسجام و صحت فکتها گزارش کنید. نتایج را حتماً با 50 تا 100 خلاصهی برچسبخورده توسط انسان کالیبره کنید.
گام 4: مسئلهی صحت فکتها (Factuality)
خلاصههای انتزاعی بسیار مستعد توهم هستند. خلاصههای استخراجی خطر توهم به مراتب کمتری دارند، چون متن عیناً از منبع کپی میشود؛ هرچند اگر جملات بریدهشده از بافت اصلی خارج شوند، قدیمی باشند یا خارج از ترتیب چیده شوند، باز هم میتوانند گمراهکننده باشند. همین دلیل بزرگترین عاملی است که چرا سامانههای پروداکشن در حوزههای مرتبط با انطباق با قوانین (Compliance)، همچنان روشهای استخراجی را ترجیح میدهند.
انواع رایج توهم:
- جابهجایی موجودیت (Entity swap): منبع میگوید "John Smith"، خلاصه میگوید "John Brown".
- تغییر ارقام (Number drift): منبع میگوید "25,000"، خلاصه میگوید "25 million".
- معکوس شدن جهت گزاره (Polarity flip): منبع میگوید "پیشنهاد را رد کرد"، خلاصه میگوید "پیشنهاد را پذیرفت".
- جعل فکت (Fact invention): منبع اصلاً نامی از مدیرعامل نبرده، خلاصه میگوید مدیرعامل طرح را تأیید کرده است.
روشهای کارآمد ارزیابی:
- FactCC: یک کلاسیفایر دودویی که روی رابطهی استلزام میان جملهی منبع و خلاصهی تولیدشده آموزش دیده و فکتمحور بودن یا نبودن را پیشبینی میکند.
- صحت فکت بر پایهی پرسشوپاسخ (QA-based factuality): از یک مدل پرسشوپاسخ، سوالاتی بپرسید که جوابشان در متن اصلی است. اگر خلاصه به پاسخهای متفاوتی اشاره کرد، به آن برچسب خطا بزنید.
- معیار F1 در سطح موجودیتها (Entity-level F1): موجودیتهای نامدار را در منبع و خلاصه مقایسه کنید. موجودیتهایی که تنها در خلاصه ظاهر میشوند، مشکوک هستند.
برای هر محصول پروداکشنی که مستقیماً به دست کاربر میرسد و درستی فکتها در آن حیاتی است (اخبار، پزشکی، حقوقی، مالی)، روش استخراجی گزینهی امنتر و پیشفرض است. روش انتزاعی حتماً به یک چرخهی اعتبارسنجی فکت در فرآیند نیاز دارد.
کاربرد عملی
پشتهی فناوری در سال 2026:
| مورد کاربرد | گزینهی پیشنهادی |
|---|---|
| اخبار، خلاصهی 3 تا 5 جملهای، انگلیسی | facebook/bart-large-cnn |
| مقالههای علمی | google/pegasus-pubmed یا نسخهی تنظیمشدهی T5 |
| چندسندی و متنهای طولانی | هر LLM با پنجرهی زمینهی بالای 32k همراه با پرامپت |
| خلاصهسازی گفتگوها | philschmid/bart-large-cnn-samsum |
| استخراجی، ذاتاً با حداقل ریسک توهم | TextRank یا الگوریتمهای LSA / LexRank از کتابخانهی sumy |
در سال 2026، زمانی که محدودیت پردازشی وجود نداشته باشد، مدلهای زبانی با پنجرهی زمینهی طولانی معمولاً مدلهای تخصصی را شکست میدهند. هزینهی مالی و بازتولیدپذیری، نقطهی مصالحهی این ماجراست؛ مدلهای تخصصی خروجیهای باثباتتری ارائه میدهند.
انتشار در محیط عملیاتی
این راهنما را در فایل outputs/skill-summary-picker.md ذخیره کنید:
---
name: summary-picker
description: Pick extractive or abstractive, named library, factuality check.
version: 1.0.0
phase: 5
lesson: 12
tags: [nlp, summarization]
---

Given a task (document type, compliance requirement, length, compute budget), output:

1. Approach. Extractive or abstractive. Explain in one sentence why.
2. Starting model / library. Name it. `sumy.TextRankSummarizer`, `facebook/bart-large-cnn`, `google/pegasus-pubmed`, or an LLM prompt.
3. Evaluation plan. ROUGE-1, ROUGE-2, ROUGE-L (use rouge-score with stemming). Plus factuality check if abstractive.
4. One failure mode to probe. Entity swap is the most common in abstractive news summarization; flag samples where source entities do not appear in summary.

Refuse abstractive summarization for medical, legal, financial, or regulated content without a factuality gate. Flag input over the model's context window as needing chunked map-reduce summarization (not just truncation).تمرینها
- ساده. TextRank را روی 5 مقالهی خبری اجرا کنید. 3 جملهی برتر را با خلاصهی مرجع بسنجید و ROUGE-L را اندازه بگیرید. برای مقالاتی به سبک CNN/DailyMail باید به ROUGE-L بین 30 تا 45 برسید.
- متوسط. ارزیابی صحت فکت را در سطح موجودیت پیادهسازی کنید: موجودیتهای نامدار را از متن اصلی و خلاصه استخراج کنید (با spaCy)، بازخوانی موجودیتهای منبع در خلاصه و دقتِ موجودیتهای خلاصه نسبت به منبع را به دست آورید. دقت بالا و بازخوانی پایین یعنی خلاصهای امن ولی بسیار کوتاه؛ دقت پایین هم یعنی توهم موجودیتها رخ داده است.
- پیشرفته. مدل BART-large-CNN را با یک مدل زبانی بزرگ (مثل Claude یا GPT-4) روی 50 مقالهی CNN/DailyMail مقایسه کنید. ROUGE-L، درستی فکتها (با F1 موجودیتها) و هزینهی مالی هر خلاصه را گزارش دهید و بنویسید هر مدل در چه سناریویی برنده میشود.
واژگان کلیدی
| اصطلاح | در گفتار عامیانه | معنای دقیق فنی |
|---|---|---|
| استخراجی (Extractive) | گلچین جملهها | استخراج و بازگرداندن عین جملات از منبع؛ هرگز دچار توهم نمیشود. |
| انتزاعی (Abstractive) | بازنویسی | تولید متنی نو با تکیه بر منبع؛ امکان توهم وجود دارد. |
| ROUGE | سنجهی خلاصه | همپوشانی N-gram یا LCS میان خروجی سامانه و خلاصهی مرجع. |
| TextRank | روش استخراجی مبتنی بر گراف | اجرای PageRank روی گراف شباهت جملات. |
| صحت فکتها (Factuality) | آیا درست است؟ | اینکه ادعاهای موجود در خلاصه تا چه حد مستند به منبع هستند. |
| توهم (Hallucination) | محتوای ساختگی | مطالبی در خلاصه که منبع آنها را تایید نمیکند. |
منابع برای مطالعهی بیشتر
- Mihalcea and Tarau (2004). TextRank: Bringing Order into Texts — مقالهی کلاسیک و مبنایی خلاصهسازی استخراجی.
- Lewis et al. (2019). BART: Denoising Sequence-to-Sequence Pre-training — مقالهی معرفی BART.
- Zhang et al. (2019). PEGASUS: Pre-training with Extracted Gap-sentences — مقالهی خلاصهسازی با Pegasus و هدف gap-sentence.
- Lin (2004). ROUGE: A Package for Automatic Evaluation of Summaries — مقالهی معرفی ROUGE.
- Maynez et al. (2020). On Faithfulness and Factuality in Abstractive Summarization — مقالهی چشمانداز ارزیابی وفاداری و فکتها در خلاصهسازی انتزاعی.