
شبیهسازی صدا (Voice Cloning) و تبدیل صدا (Voice Conversion) مرزهای تولید محتوا، دوبله و دستیارهای صوتی را متحول کردهاند؛ بهطوریکه تنها با چند ثانیه نمونهی صوتی میتوان هویت یک صدا را بازتولید کرد یا گفتار فردی را به فرد دیگر تغییر داد. در این درس میآموزید که مدلهای صوتی نوین چگونه ویژگیهای هویت گوینده را از محتوای کلام تفکیک میکنند و چطور بدون آموزش سنگین، خروجیهای واقعی بسازید.
اگر از داخل ایران قصد دانلود مدلهای متنباز صوتی از Hugging Face را داشته باشید یا بخواهید بستههای پایتونی را نصب کنید، احتمالاً با ناپایداری یا کندی شبکه مواجه میشوید؛ در چنین شرایطی تنظیم میرورهای معتبر یا استفاده از ابزارهای مدیریت دانلود راهگشاست. از سوی دیگر، سرویسهای تجاری کلود مانند ElevenLabs نیازمند پرداخت ارزی مستقیم هستند که با کارتهای بانکی داخلی ممکن نیست؛ با این حال، اجرای مدلهای متنباز این درس با پردازندههای گرافیکی معمولی در دسترس خواهد بود.
شبیهسازی صدا متن شما را با صدای فردی دیگر میخواند. تبدیل صدا، صدای شما را به صدای فردی دیگر بازنویسی میکند و در عین حال گفتههایتان را دستنخورده نگه میدارد. هر دو متکی بر یک تجزیهاند: جداسازی هویت گوینده از محتوا.
صورت مسئله
در سال 2026، یک قطعه صوتی 5 ثانیهای برای ساخت کلونی باکیفیت از صدای هر فردی روی یک پردازنده گرافیکی (GPU) معمولی کفایت میکند. سرویسهای ElevenLabs، F5-TTS، OpenVoice v2 و VoiceBox همگی شبیهسازی صفر-نمونه (Zero-shot) یا چند-نمونه ارائه میدهند. این فناوری هم موهبت است (تبدیل متن به گفتار برای دسترسیپذیری، دوبله، صداهای کمکی) و هم سلاح (تماسهای کلاهبرداری، دیپفیکهای سیاسی، سرقت مالکیت فکری).
دو وظیفه با ارتباط بسیار نزدیک:
- شبیهسازی صدا (سمت TTS): متن + صدای مرجع 5 ثانیهای ← خروجی صوتی با همان صدا.
- تبدیل صدا (سمت گفتار): صوت مبدأ (شخص A که عبارت X را میگوید) + صدای مرجع شخص B ← خروجی صوتی از گفتن عبارت X با صدای شخص B.
هر دو روش، شکل موج صوتی را به سه بخش (محتوا، گوینده، عروض) تجزیه میکنند و محتوای یک منبع را با گویندهی منبع دیگر درمیآمیزند.
محدودیت کلیدی انتشار محصول در سال 2026: درج واترمارک و گیتهای احراز رضایت طبق قوانین اتحادیه اروپا (AI Act، لازمالاجرا از اوت 2026) و کالیفرنیا (AB 2905، لازمالاجرا از 2025) الزامی هستند. پایپلاین شما باید واترمارکی ناملموس درج کند و از کلونهای بدون رضایت سر باز زند.
درک مفاهیم
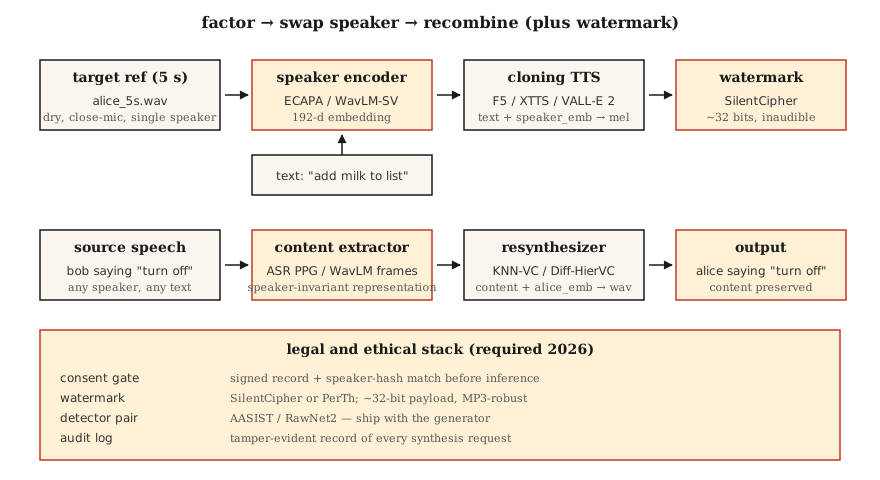
شبیهسازی صفر-نمونه. یک کلیپ 5 ثانیهای را به مدلی میدهید که روی صدای هزاران گوینده آموزش دیده است. انکودر گوینده این کلیپ را به یک امبدینگ گوینده نگاشت میکند؛ دیکودر TTS نیز بر اساس آن امبدینگ بههمراه متن ورودی، صدا را تولید میکند.
موارد استفاده: F5-TTS (2024)، YourTTS (2022)، XTTS v2 (2024)، OpenVoice v2 (2024).
فاینتیونینگ چند-نمونه. بین 5 تا 30 دقیقه از صدای هدف را ضبط میکنید. مدل پایه را به مدت یک ساعت با LoRA فاینتیون میکنید. کیفیت خروجی از حد «قابل قبول» به سطحی جهش میکند که با صدای واقعی «غیرقابل تشخیص» است. Coqui و ElevenLabs هر دو از این الگو پشتیبانی میکنند؛ کامیونیتی نیز از آن همراه با F5-TTS بهره میبرد.
تبدیل صدا (VC). شامل دو رویکرد اصلی:
- بازشناسی-سنتز (Recognition-synthesis). اجرای مدلی شبیه به ASR برای استخراج بازنمایی محتوا (مانند احتمالات پسین واجها بهصورت نرم یا همان PPGها)، و سپس سنتز مجدد آن با امبدینگ گویندهی هدف. این روش در برابر زبان و لهجه مقاوم است. موارد استفاده: KNN-VC (2023)، Diff-HierVC (2023).
- جداسازی ویژگیها (Disentanglement). آموزش یک اتوانکودر که محتوا، گوینده و عروض را در فضای نهان (latent space) و در گلوگاه شبکه از یکدیگر تفکیک میکند. در زمان استنتاج، امبدینگ گوینده جایگزین میشود. کیفیت پایینتر اما سرعت بالاتری دارد. موارد استفاده: AutoVC (2019)، گونههای مختلف VITS-VC.
شبیهسازی مبتنی بر کدک عصبی (از سال 2024 به بعد). مدلهای VALL-E، VALL-E 2، NaturalSpeech 3 و VoiceBox با صوت مانند توکنهای گسستهی حاصل از SoundStream یا EnCodec برخورد میکنند و یک مدل بزرگ خودبازگشتی (Autoregressive) یا تطبیق جریان (Flow-matching) را روی این توکنهای کدک آموزش میدهند. کیفیت این روش در پرامپتهای کوتاه تنه به تنهی ElevenLabs میزند.
بخش اخلاقی ماجرا؛ یک ضرورت، نه امکان اختیاری
واترمارکگذاری. ابزارهای PerTh (Perth) و SilentCipher (2024) یک شناسهی حدوداً 16 تا 32 بیتی را بهشکلی ناملموس درون صوت تعبیه میکنند. این شناسه در برابر فشردهسازی مجدد، استریمینگ و ویرایشهای معمول دستنخورده باقی میماند. این ابزارها متنباز و آمادهی محیط پروداکشن هستند.
گیتهای احراز رضایت. هر خروجی شبیهسازیشده باید به یک سند رضایت قابلراستیآزمایی متصل باشد؛ مثلاً: «اینجانب روهیت، در تاریخ 2026-04-22، اجازهی استفاده از این صدا را برای هدف X صادر میکنم.» این دادهها باید در یک لاگ ضددستکاری ذخیره شوند.
تشخیص جعل. مدلهای AASIST، RawNet2 و Wav2Vec2-AASIST بهعنوان ابزارهای تشخیص دیپفیک عرضه شدهاند. مسابقهی ASVspoof 2025 نرخهای خطای مساوی (EER) بین 0.8 تا 2.3 درصد را برای مدلهای مدرن تشخیصدهنده در برابر خروجیهای ElevenLabs، VALL-E 2 و Bark گزارش کرده است.
ارقام و آمار (2026)
| مدل | بدون نمونه قبلی؟ | SECS (شباهت به هدف) | WER (وضوح گفتار) | تعداد پارامترها |
|---|---|---|---|---|
| F5-TTS | بله | 0.72 | 2.1% | 335M |
| XTTS v2 | بله | 0.65 | 3.5% | 470M |
| OpenVoice v2 | بله | 0.70 | 2.8% | 220M |
| VALL-E 2 | بله | 0.77 | 2.4% | 370M |
| VoiceBox | بله | 0.78 | 2.1% | 330M |
امتیاز SECS بالاتر از 0.70 معمولاً از نظر بیشتر شنوندگان تفاوت محسوسی با صدای هدف ندارد.
پیادهسازی از صفر
مرحلهی 1: تجزیه با رویکرد بازشناسی-سنتز (دموی کدمحور در main.py)
def clone_pipeline(ref_audio, text, target_embedder, tts_model):
    speaker_emb = target_embedder.encode(ref_audio)
    mel = tts_model(text, speaker=speaker_emb)
    return vocoder(mel)
از نظر مفهومی ساده است؛ بخش اصلی پیادهسازی در tts_model و انکودر گوینده قرار دارد.
مرحلهی 2: شبیهسازی صفر-نمونه با F5-TTS
from f5_tts.api import F5TTS
tts = F5TTS()
wav = tts.infer(
    ref_file="rohit_5s.wav",
    ref_text="The quick brown fox jumps over the lazy dog.",
    gen_text="Please add milk and bread to my list.",
)
متن مرجع باید موبهمو با فایل صوتی همخوانی داشته باشد؛ هرگونه ناهمخوانی فرآیند همترازی را بر هم میزند.
مرحلهی 3: تبدیل صدا با KNN-VC
import torch
from knnvc import KNNVC  # 2023 model, https://github.com/bshall/knn-vc
vc = KNNVC.load("wavlm-base-plus")
out_wav = vc.convert(source="my_voice.wav", target_pool=["alice_1.wav", "alice_2.wav"])
مدل KNN-VC با استفاده از WavLM، امبدینگهای فریمبهفریم را برای فایل صوتی مبدأ و مجموعهی هدف استخراج میکند؛ سپس هر فریم مبدأ را با نزدیکترین همسایهاش در مجموعهی هدف جایگزین میسازد. این روش ناپارامتری است و حتی با یک دقیقه گفتار از صدای هدف بهخوبی کار میکند.
مرحلهی 4: درج واترمارک
from silentcipher import SilentCipher
sc = SilentCipher(model="2024-06-01")
payload = b"consent_id:abc123;ts:1745353200"
watermarked = sc.embed(wav, sr=24000, message=payload)
detected = sc.detect(watermarked, sr=24000)   # returns payload bytes
یک دادهی حدوداً 32 بیتی که حتی پس از تبدیل مجدد به MP3 و اعمال نویز جزئی، قابل شناسایی است.
مرحلهی 5: گیت احراز رضایت
def cloned_inference(text, ref_audio, consent_record):
    assert verify_signature(consent_record), "Signed consent required"
    assert consent_record["speaker_id"] == hash_speaker(ref_audio)
    wav = tts.infer(ref_file=ref_audio, gen_text=text)
    wav = watermark(wav, payload=consent_record["id"])
    return wav
استفاده از ابزارهای واقعی
استک پیشنهادی سال 2026:
| سناریو | انتخاب |
|---|---|
| شبیهسازی 5 ثانیهای بدون نمونه قبلی، متنباز | F5-TTS یا OpenVoice v2 |
| شبیهسازی تجاری در محیط پروداکشن | ElevenLabs Instant Voice Clone v2.5 |
| تبدیل صدا (بازنویسی) | KNN-VC یا Diff-HierVC |
| فاینتیونینگ برای چندین گوینده | StyleTTS 2 + آداپتور گوینده |
| شبیهسازی چندزبانه | XTTS v2 یا VALL-E X |
| تشخیص دیپفیک | Wav2Vec2-AASIST |
چالشها و خطاهای رایج
- ناهمخوانی متن و صوت مرجع. مدلهایی مثل F5-TTS الزام دارند که متن مرجع، حتی در علائم نگارشی، دقیقاً با صوت مرجع همخوانی داشته باشد.
- وجود بازگشت صدا (Reverb) در فایل مرجع. پژواک، کیفیت کلون را نابود میکند. صدا را خشک و با میکروفون نزدیک ضبط کنید.
- تضاد احساسی. اگر صدای مرجع «شاد و پرانرژی» باشد، تمام جملات بعدی با همان لحن شاد شبیهسازی میشوند. لحن صدای مرجع را متناسب با کاربرد نهایی انتخاب کنید.
- نشت زبان (Language leakage). شبیهسازی صدای یک انگلیسیزبان و وادار کردن مدل به فرانسوی صحبت کردن، اغلب لهجهی زبان مبدأ را منتقل میکند؛ برای این سناریوها از مدلهای چندزبانه (مانند XTTS و VALL-E X) استفاده کنید.
- نبود واترمارک. ارائهی محصول بدون واترمارک از اوت 2026 در اتحادیه اروپا منع قانونی دارد.
خروجی این درس
خروجی کار را در مسیر outputs/skill-voice-cloner.md ذخیره کنید. یک پایپلاین شبیهسازی یا تبدیل صدا طراحی کنید که مجهز به گیت احراز رضایت، سیستم واترمارکگذاری و شاخصهای کیفی مشخص باشد.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. این اسکریپت جابهجایی امبدینگ گوینده را با محاسبهی شباهت کسینوسی میان دو «گوینده» قبل و بعد از جابهجایی نمایش میدهد. - متوسط. با استفاده از OpenVoice v2 صدای خودتان را کلون کنید. شاخص SECS میان صدای مرجع و صدای شبیهسازیشده را اندازه بگیرید. میزان CER را با استفاده از Whisper محاسبه کنید.
- پیشرفته. با SilentCipher روی 20 فایل شبیهسازیشده واترمارک درج کنید؛ آنها را به فرمت MP3 با نرخ بیت 128 kbps انکود و دیکود کنید؛ سپس دادهی تعبیهشده را استخراج و نرخ دقت بیتها (bit-accuracy) را گزارش دهید.
اصطلاحات کلیدی
| اصطلاح | آنچه به زبان میآورند | معنای واقعی آن |
|---|---|---|
| کلون صفر-نمونه (Zero-shot clone) | 5 ثانیه صدا برای کار کافی است | مدل پیشآموزشدیده + امبدینگ گوینده؛ بدون نیاز به بازآموزی. |
| PPG | نگارهی پسین واجشناختی (Phonetic posteriorgram) | مقادیر پسین واجها در هر فریم ASR بهعنوان بازنمایی مستقل از زبان محتوا. |
| KNN-VC | تبدیل بر اساس نزدیکترین همسایه | جایگزینی هر فریم مبدأ با نزدیکترین فریم موجود در مجموعهی هدف. |
| کدک عصبی TTS | رویکرد سبک VALL-E | مدل AR روی توکنهای EnCodec یا SoundStream. |
| واترمارک (Watermark) | امضای ناملموس | بیتهای تعبیهشده درون صوت که در فشردهسازی مجدد از بین نمیروند. |
| SECS | میزان شباهت شبیهسازی | شباهت کسینوسی میان امبدینگهای گویندهی هدف و خروجی شبیهسازیشده. |
| AASIST | تشخیصدهندهی دیپفیک | مدل ضدجعل که گفتار سنتزشده را شناسایی میکند. |
برای مطالعهی بیشتر
- Chen et al. (2024). F5-TTS — پیشرفتهترین ابزار متنباز شبیهسازی صفر-نمونه.
- Baevski et al. / Microsoft (2023). VALL-E و VALL-E 2 (2024) — تبدیل متن به گفتار بر پایهی کدک عصبی.
- Qian et al. (2019). AutoVC — تبدیل صدا با روش جداسازی ویژگیها.
- Baas, Waubert de Puiseau, Kamper (2023). KNN-VC — تبدیل صدای بازیابیمحور.
- SilentCipher (2024) — Audio Watermarking — سیستم واترمارک صوتی 32 بیتی و آمادهی استفاده در پروداکشن.
- نتایج مسابقه ASVspoof 2025 — رقابت نفسگیر میان ابزارهای تشخیص و سنتز صدا، بهروزرسانیشده در 2026.