
سیستمهای تبدیل گفتار به متن (ASR) به محتوای کلام گوش میدهند، اما در سناریوهای احراز هویت، نظارت امنیتی یا پیادهسازی متن جلسات چندنفره، پرسش اساسی این است: «چه کسی صحبت کرد؟» تشخیص هویت گوینده و تأیید هویت بیومتریک از روی صوت، مسئلهای کلاسیک است که در سالهای اخیر با ورود امبدینگهای عمیق مانند ECAPA-TDNN و WavLM دگرگون شده است.
در محیطهای عملیاتی، چالش اصلی پیادهسازی صرفاً استخراج ویژگی نیست؛ بلکه تنظیم دقیق آستانهی تصمیمگیری بر اساس معیار نرخ خطای برابر (EER)، مدیریت تفاوتهای کانال صوتی (مثل میکروفون موبایل در برابر لپتاپ) و اجرای کمتاخیر مدلها روی سختافزارهای مختلف است. این درس پایپلاین کامل تأیید هویت 1:1 و جداسازی گویندگان (Diarization) را پوشش میدهد.
اگر برای دانلود مدلهای از پیشآموزشدیده مانند چکپوینتهای SpeechBrain یا Hugging Face از داخل ایران اقدام میکنید، به یاد داشته باشید که بارگیری از این مخازن گاهی ناپایدار یا کند است. با این حال، مدلهای پایه سبک مانند ECAPA-TDNN یا x-vector به منابع پردازشی سنگین نیاز ندارند و برای آزمون و استنتاج بهراحتی روی CPU یا پردازندههای معمول شخصی اجرا میشوند.
سیستمهای ASR میپرسند «چه چیزی گفته شد؟» اما سیستمهای تشخیص گوینده میپرسند «چه کسی آن را گفت؟» ریاضیات هر دو شبیه به هم است — امبدینگها بهعلاوهی شباهت کسینوسی (Cosine Similarity) — اما تمام تصمیمگیریهای پروداکشن به یک عدد وابسته است: EER.
صورت مسئله
کاربر یک عبارت عبور را به زبان میآورد. میخواهید بدانید: آیا این شخص همان کسی است که ادعا میکند (تأیید هویت یا verification، حالت 1:1)، یا نفر اول در بانک گویندگان ثبتنامشدهی شماست (شناسایی هویت یا identification، حالت 1:N)؟ یا هیچکدام — یعنی با گویندهای ناشناس طرف هستیم (مجموعهباز یا open-set)؟
پیش از سال 2018: ترکیب GMM-UBM به همراه i-vectorها به کار میرفت؛ EER معقولی داشتند اما در برابر تغییر کانال صوتی (مثلاً تلفن در برابر لپتاپ) و احساسات بسیار شکننده بودند. سالهای 2018 تا 2022: دوران x-vectorها (بکبون TDNN آموزشدیده با حاشیهی زاویهای). از سال 2022 به بعد: امبدینگهای ECAPA-TDNN و WavLM-large وارد میدان شدند. تا سال 2026، سه مدل و یک معیار ارزیابی بر این حوزه حاکم شدهاند.
این معیار EER (نرخ خطای برابر یا Equal Error Rate) است. آستانهی تصمیمگیریتان را طوری تنظیم کنید که نرخ پذیرش نادرست (False Accept Rate) با نرخ رد نادرست (False Reject Rate) برابر شود؛ نقطهی تلاقی این دو همان EER است. این معیار در تمام مقالهها، لیدربوردها و مذاکرات خرید به کار میرود.
مبانی نظری
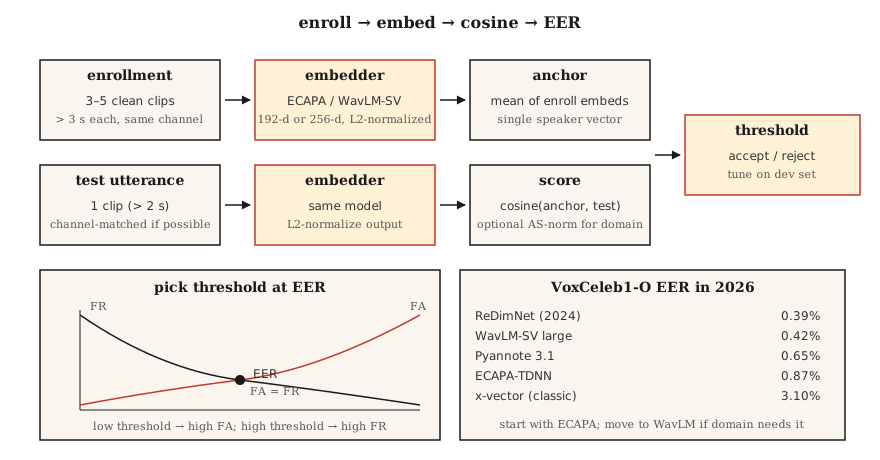
پایپلاین. ثبتنام (Enrollment): 5 تا 30 ثانیه از صدای گویندهی هدف را ضبط کنید؛ یک امبدینگ با بعد ثابت بسازید (192 بعد برای ECAPA-TDNN و 256 بعد برای WavLM-large). تأیید هویت (Verification): امبدینگ گفتار آزمون را به دست آورید؛ شباهت کسینوسی را محاسبه کنید و حاصل را با یک آستانه بسنجید.
مدل ECAPA-TDNN (معرفیشده در 2020، همچنان پیشتاز در 2026). شبکهی عصبی با تأخیر زمانی به همراه اتنشن، انتشار و تجمیع کانالی تأکیدشده (Emphasized Channel Attention, Propagation and Aggregation - Time-Delay Neural Network). این مدل از بلوکهای کانولوشن یکبعدی با squeeze-excitation و ادغام با اتنشن چندسر (multi-head attention pooling) استفاده میکند و در نهایت با یک لایهی خطی به خروجی 192-بعدی میرسد. آموزش آن روی VoxCeleb 1+2 (شامل 2,700 گوینده و 1.1 میلیون قطعه گفتار) و با تابع زیان (loss) حاشیهی زاویهای جمعپذیر (AAM-softmax) انجام شده است.
مدل WavLM-SV (از 2022 به بعد). فاینتیون کردن یک بکبون یادگیری خودنظارتی (SSL) از نوع WavLM-large با تابع زیان AAM. کیفیت بالاتری دارد اما کندتر است — بیش از 300 مگابایت در مقایسه با 15 مگابایت.
مدل x-vector (خط مبنا). معماری TDNN بهعلاوهی ادغام آماری (statistics pooling). یک کلاسیکِ ماندگار؛ هنوز هم روی CPU و لبه (edge) کاربرد دارد.
تابع زیان AAM-softmax. همان سافتمکس استاندارد با افزودن حاشیهی m در فضای زاویهای: cos(θ + m) برای کلاس درست. این فرمول شبکه را وادار میکند تا بین کلاسها فاصلهی زاویهای بیندازد. مقادیر معمول آن m=0.2 و ضریب مقیاس s=30 است.
امتیازدهی
- شباهت کسینوسی بین امبدینگهای ثبتنام و آزمون؛ با تصمیمگیری مبتنی بر آستانه.
- روش PLDA (تحلیل ممیز خطی احتمالاتی). نگاشت امبدینگها به یک فضای پنهان که در آن نسبت درستنمایی برای وضعیت «گویندهی یکسان» در برابر «گویندهی متفاوت»، فرم بسته دارد. افزودن این روش روی شباهت کسینوسی، EER را بین 10 تا 20 درصد کاهش میدهد. تا قبل از 2020 روش استانداردی بود، اما اکنون فقط در سناریوهای مجموعهبسته به کار میرود.
- نرمالسازی امتیاز (Score normalization). روشهای
S-normیاAS-norm: نرمالسازی هر امتیاز بر اساس میانگین و انحراف معیار گروهی از گویندگان متقلب (cohort). این کار برای ارزیابی میاندامنهای ضروری است.
اعدادی که باید بدانید (2026)
| مدل | EER روی VoxCeleb1-O | تعداد پارامترها | نرخ پردازش (A100) |
|---|---|---|---|
| x-vector (کلاسیک) | 3.10% | 5 M | 400× RT |
| ECAPA-TDNN | 0.87% | 15 M | 200× RT |
| WavLM-SV large | 0.42% | 316 M | 20× RT |
| قطعهبندی + امبدینگ Pyannote 3.1 | 0.65% | 6 M | 100× RT |
| ReDimNet (2024) | 0.39% | 24 M | 100× RT |
جداسازی گویندگان (Diarization)
«چه کسی کِی صحبت کرد؟» در یک فایل صوتی چندگوینده. پایپلاین کار: VAD ← قطعهبندی ← استخراج امبدینگ هر قطعه ← خوشهبندی (تراکمی یا طیفی) ← هموارسازی مرزها. استک مدرن برای این کار pyannote.audio نسخهی 3.1 است که قطعهبندی گوینده، امبدینگ و خوشهبندی را پشت یک فراخوانی ساده تجمیع میکند. نرخ خطای جداسازی گویندگان (DER) برای SOTA در سال 2026 روی مجموعهدادهی AMI حدود 15% است (در مقایسه با 23% در سال 2022).
پیادهسازی از صفر
مرحلهی 1: ساخت امبدینگ ساده با آمارههای MFCC
def embed_mfcc_stats(signal, sr):
    frames = featurize_mfcc(signal, sr, n_mfcc=13)
    mean = [sum(f[i] for f in frames) / len(frames) for i in range(13)]
    std = [
        math.sqrt(sum((f[i] - mean[i]) ** 2 for f in frames) / len(frames))
        for i in range(13)
    ]
    return mean + std  # 26-d
این پیادهسازی ابداً SOTA نیست و فقط جنبهی آموزشی دارد. فایل code/main.py از همین روش برای اثبات مفهوم روی دادههای ساختگی گویندگان استفاده میکند.
مرحلهی 2: شباهت کسینوسی + آستانه
def cosine(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    na = math.sqrt(sum(x * x for x in a))
    nb = math.sqrt(sum(x * x for x in b))
    return dot / (na * nb) if na and nb else 0.0

def verify(enroll, test, threshold=0.75):
return cosine(enroll, test) >= thresholdمرحلهی 3: محاسبهی EER از جفتهای شباهت
def eer(same_scores, diff_scores):
    thresholds = sorted(set(same_scores + diff_scores))
    best = (1.0, 1.0, 0.0)  # (fa, fr, threshold)
    for t in thresholds:
        fr = sum(1 for s in same_scores if s < t) / len(same_scores)
        fa = sum(1 for s in diff_scores if s >= t) / len(diff_scores)
        if abs(fa - fr) < abs(best[0] - best[1]):
            best = (fa, fr, t)
    return (best[0] + best[1]) / 2, best[2]
خروجی بهصورت (eer, threshold_at_eer) بازگردانده میشود؛ هر دو را گزارش کنید.
مرحلهی 4: پیادهسازی عملیاتی با SpeechBrain
from speechbrain.pretrained import EncoderClassifier
clf = EncoderClassifier.from_hparams(source="speechbrain/spkrec-ecapa-voxceleb")
# ثبتنام (enroll): میانگینگیری از امبدینگهای 3 تا 5 نمونه تمیز
enroll = torch.stack([clf.encode_batch(load(x)) for x in enrollment_clips]).mean(0)
# verify
score = clf.similarity(enroll, clf.encode_batch(load("test.wav"))).item()
verdict = score > 0.25 # ECAPA typical threshold; tune on your dataمرحلهی 5: جداسازی گویندگان با pyannote
from pyannote.audio import Pipeline

pipe = Pipeline.from_pretrained("pyannote/speaker-diarization-3.1")
diarization = pipe("meeting.wav", num_speakers=None)
for turn, _, speaker in diarization.itertracks(yield_label=True):
    print(f"{turn.start:.1f}–{turn.end:.1f}  {speaker}")
استفاده از ابزارهای واقعی
استک پیشنهادی سال 2026:
| موقعیت | انتخاب مناسب |
|---|---|
| تأیید هویت 1:1 در مجموعهبسته، روی دستگاه لبه | ECAPA-TDNN + آستانهی کسینوسی |
| تأیید هویت در مجموعهباز، روی ابری | WavLM-SV + AS-norm |
| جداسازی گویندگان (جلسات، پادکستها) | pyannote/speaker-diarization-3.1 |
| مقابله با جعل هویت (تشخیص بازپخش / دیپفیک) | AASIST یا RawNet2 |
| تعبیهشدهی بسیار سبک (تشخیص کلمهی کلیدی + ثبتنام) | Titanet-Small (از NeMo) |
دامهای رایج
- عدمتطابق کانال صوتی (Channel mismatch). مدلی که روی VoxCeleb (ویدیوهای وب) آموزش دیده، با صوت تماس تلفنی متفاوت است. همیشه مدل را روی کانال صوتی هدف ارزیابی کنید.
- قطعات گفتار کوتاه. اگر طول صوت آزمون کمتر از 3 ثانیه باشد، EER بهشدت افت میکند.
- ثبتنام با صدای نویزدار. حتی یک نمونهی نویزدار در زمان ثبتنام، بردار مبنا را خراب میکند. حداقل از 3 نمونهی تمیز استفاده کنید و میانگین بگیرید.
- آستانهی ثابت در شرایط گوناگون. آستانه را همیشه روی یک مجموعهی توسعهی نگهداشتهشده (held-out dev set) از همان دامنهی هدف تنظیم کنید.
- محاسبهی کسینوس روی امبدینگهای نرمالنشده. ابتدا بردارهای امبدینگ را نرمالسازی L2 کنید؛ در غیر این صورت اندازهی بردار بر شباهت زاویهای غلبه میکند.
خروجی این درس
نتایج را در outputs/skill-speaker-verifier.md ذخیره کنید. مدل، پروتکل ثبتنام، برنامهی تنظیم آستانه و تمهیدات ضدجعل را مشخص کنید.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. این کد «گویندگان» ساختگی (با مشخصات لحنی متفاوت) میسازد، آنها را ثبتنام میکند و EER را روی یک فهرست آزمون 100 جفتی میسنجد. - متوسط. از مدل ECAPA در کتابخانهی SpeechBrain روی 30 قطعه گفتار از VoxCeleb1 (شامل 5 گوینده و هر کدام 6 قطعه) استفاده کنید. EER را با شباهت کسینوسی در برابر PLDA مقایسه کنید.
- سخت. پایپلاین کامل ثبتنام ← جداسازی گویندگان ← تأیید هویت را با
pyannote.audioبسازید. سپس DER را روی مجموعهی توسعهی AMI ارزیابی کنید.
اصطلاحات کلیدی
| اصطلاح | آنچه در گفتوگوها میگویند | مفهوم واقعی |
|---|---|---|
| EER | معیار شاخص و اصلی | آستانهای که در آن خطای پذیرش نادرست با خطای رد نادرست برابر میشود. |
| Verification | حالت 1:1 | «آیا این فرد آلیس است؟» |
| Identification | حالت 1:N | «چه کسی دارد صحبت میکند؟» |
| Open-set | احتمال وجود گویندهی ناشناس | مجموعهی آزمون میتواند شامل گویندگانی باشد که ثبتنام نشدهاند. |
| Enrollment | ثبتنام کردن | محاسبهی امبدینگ مرجع برای یک گوینده. |
| AAM-softmax | تابع زیان اصلی | سافتمکس با حاشیهی زاویهای جمعپذیر؛ خوشهها را وادار به فاصلهگرفتن از یکدیگر میکند. |
| PLDA | روش امتیازدهی کلاسیک | تحلیل ممیز خطی احتمالاتی؛ امتیازدهی مبتنی بر نسبت درستنمایی روی امبدینگها. |
| DER | معیار جداسازی گویندگان | نرخ خطای جداسازی گویندگان — حاصلجمع خطای عدمتشخیص، هشدار نادرست و تداخل گوینده. |
برای مطالعهی بیشتر
- Snyder et al. (2018). X-Vectors: Robust DNN Embeddings for Speaker Recognition — مقالهی کلاسیک معرفی امبدینگهای عمیق.
- Desplanques et al. (2020). ECAPA-TDNN — معماری مسلط در سالهای 2020 تا 2026.
- Chen et al. (2022). WavLM: Large-Scale Self-Supervised Pre-Training for Full Stack Speech Processing — بکبون SSL برای تأیید هویت و جداسازی گویندگان.
- Bredin et al. (2023). pyannote.audio 3.1 — استک پروداکشن برای جداسازی گویندگان و استخراج امبدینگ.
- لیدربورد VoxCeleb (بهروزرسانی 2026) — رتبهبندی فعلی مدلها بر اساس معیار EER.