
مدلهای زبانی مدرن زبان توکنها را میفهمند، در حالی که صدا دادهای پیوسته و با فرکانس بالاست. اگر بخواهید با مدلهای زایشی مشابه GPT به تولید یا ویرایش صدا بپردازید، بزرگترین چالش تبدیل این شکلموج پیوسته به دنبالهای فشرده از توکنهای گسسته است، بدون اینکه کیفیت شنیداری یا هویت گوینده از بین برود.
کدکهای صوتی عصبی (Neural Audio Codecs) مانند EnCodec، DAC، SNAC و Mimi این وظیفه را به دوش میکشند. این سیستمها به کمک کوانتیزاسیون برداری باقیمانده (RVQ) و تفکیک هوشمندانهی مؤلفههای معنایی از ویژگیهای آکوستیک، به مدلهای زبانی اجازه میدهند صوت را همانند کلمات پردازش و تولید کنند.
دریافت وزنهای مدلهای صوتی یا دانلود پکیجها ممکن است گاهی از طریق PyPI یا Hugging Face با اختلال یا افت سرعت همراه باشد که تنظیم میرورهای داخلی یا استفاده از ابزارهای مدیریت بستهی سریعتر روند را تسهیل میکند. همچنین بررسی این کدکها با ابعاد کوچک یا نرخ فریمهای بهینه به راحتی روی سختافزارهای محلی و CPU نیز قابل آزمایش است.
در سال 2026، تولید صدا تقریباً تماماً بر پایهی توکنها انجام میشود. مدلهای EnCodec، SNAC، Mimi و DAC شکلموجهای پیوسته (waveforms) را به دنبالههای گسستهای تبدیل میکنند که یک ترنسفورمر (Transformer) میتواند آنها را پیشبینی کند. تفکیک توکنهای معنایی از صوتی (semantic-vs-acoustic token split) — که در آن اولین کتاب کد (codebook) نقش معنایی دارد و بقیه نقش صوتی — مهمترین تحول معماری در صوت پس از ترنسفورمر به شمار میرود.
صورت مسئله
مدلهای زبانی با توکنهای گسسته کار میکنند، در حالی که صدا پیوسته است. اگر برای گفتار یا موسیقی مدلی با معماری مشابه مدلهای زبانی بزرگ (LLM) میخواهید — مانند MusicGen، Moshi، Sesame CSM، VibeVoice یا Orpheus — پیش از هر چیز به یک کدک صوتی عصبی (neural audio codec) نیاز دارید: انکودری آموزشپذیر که صدا را به دامنهی محدودی از توکنها گسسته کند، و دیکودری متناظر که شکلموج را دوباره بازسازی کند.
در این میان، دو خانوادهی اصلی شکل گرفتهاند:
- کدکهای مبتنی بر اولویت بازسازی (Reconstruction-first codecs) — مانند EnCodec و DAC. این مدلها کیفیت ادراکی صدا را بهینهسازی میکنند. توکنهای آنها «صوتی» هستند؛ یعنی همهچیز از جمله هویت گوینده، طنین صدا (timbre) و نویز پسزمینه را ثبت میکنند.
- کدکهای مبتنی بر اولویت معنایی (Semantic-first codecs) — مانند Mimi (محصول Kyutai) و SpeechTokenizer. در این مدلها، اولین کتاب کد مجبور میشود محتوای زبانی و آوایی را کدگذاری کند (معمولاً از طریق تقطیر دانش (Distillation) از WavLM). کتابهای کد بعدی جزئیات صوتی را ذخیره میکنند.
یافتهی کلیدی سالهای 2024 تا 2026 این است: تولید صدا از متن با کدکهای مبتنی بر بازسازیِ صرف، گفتاری مات و نامفهوم تحویل میدهد. مدل زبانی روی توکنهای کدک مجبور است هم ساختار زبان و هم ساختار آکوستیک را درون یک کتاب کد واحد یاد بگیرد، و این رویکرد مقیاسپذیر نیست. تفکیک این دو — کتاب کد معنایی 0، و کتابهای کد صوتی 1 تا N — همان چیزی است که Moshi و Sesame CSM را به کار انداخته است.
مفاهیم پایه
ترفند اصلی: کوانتیزاسیون برداری باقیمانده (RVQ)
به جای استفاده از یک کتاب کد بزرگ (که برای دستیابی به کیفیت مطلوب به میلیونها کد نیاز دارد)، تمام کدکهای صوتی مدرن از RVQ (مخفف Residual Vector Quantization) استفاده میکنند: آبشاری از کتابهای کد کوچک. اولین کتاب کد خروجی انکودر را کوانتایز میکند؛ دومین کتاب کد خطای باقیمانده (residual) را کوانتایز میکند، و این روند به همین ترتیب ادامه مییابد. هر کتاب کد شامل 1024 کد است. در نتیجه 8 کتاب کد، واژگان مؤثری معادل فراهم میآورند.
در زمان استنتاج، دیکودر تمام کدهای انتخابشده در هر فریم را با هم جمع میکند تا سیگنال صوتی را بازسازی کند.
چهار کدک مهم در سال 2026
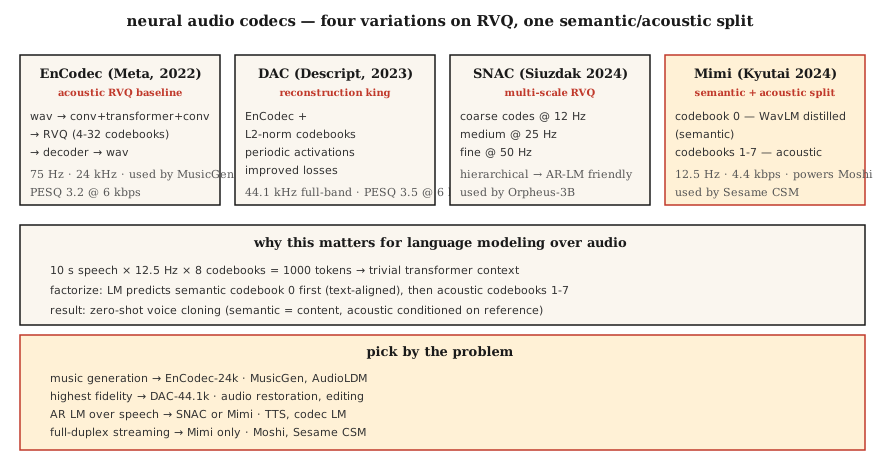
EnCodec (متا، 2022). مدل پایهی استاندارد. ساختار انکودر-دیکودر روی شکلموج به همراه گلوگاه RVQ. با نرخ نمونهبرداری 24 kHz، قابلیت پشتیبانی از 32 کتاب کد، و حالت پیشفرض 4 کتاب کد در نرخ 1.5 kbps. از معماری 1D conv + transformer + 1D conv بهره میبرد و در MusicGen استفاده شده است.
DAC (دیسکریپت، 2023). مبتنی بر RVQ با کتابهای کد نرمالسازیشده با نرم L2، توابع فعالساز (Activation function) متناوب و توابع زیان (loss) بهبودیافته. این مدل بالاترین دقت بازسازی را در میان تمام کدکهای متنباز دارد — به طوری که گاهی با 12 کتاب کد نمیتوان آن را از گفتار اصلی تشخیص داد. با نرخ 44.1 kHz تمامباند (full-band).
SNAC (هوبرت سیوزداک، 2024). ساختار RVQ چندمقیاسی (multi-scale) — کتابهای کد کلیتر با نرخ فریم پایینتری نسبت به کتابهای کد دقیق کار میکنند. این کدک صدا را به صورت سلسلهمراتبی مدلسازی میکند: یک «طرح کلی» در فرکانس حدود 12 Hz به همراه جزئیات در فرکانس 50 Hz. در مدل Orpheus-3B به کار رفته است؛ زیرا ساختار سلسلهمراتبی آن به خوبی روی تولید مبتنی بر مدل زبانی مینشیند.
Mimi (کیوتای، 2024). تحول بزرگ سال 2026. نرخ فریم فوقالعاده پایین 12.5 Hz، 8 کتاب کد در نرخ 4.4 kbps. کتاب کد 0 از طریق تقطیر دانش از WavLM آموزش دیده است — یعنی طوری آموزش دیده که ویژگیهای محتوای گفتاری WavLM را پیشبینی کند. کتابهای کد 1 تا 7 باقیماندههای صوتی هستند. این تفکیک هوشمندانه، زیربنای مدلهای Moshi (درس 15) و Sesame CSM است.
اهمیت نرخ فریم در مدلسازی زبانی
نرخ فریم پایینتر = دنبالهی کوتاهتر = مدل زبانی سریعتر.
| کدک | نرخ فریم | 1 ثانیه = N فریم | مناسب برای |
|---|---|---|---|
| EnCodec-24k | 75 Hz | 75 | موسیقی، صوت عمومی |
| DAC-44.1k | 86 Hz | 86 | موسیقی با وضوح بالا |
| SNAC-24k (کلی) | ~12 Hz | 12 | مدلهای زبانی خودبازگشتی با کارایی بالا |
| Mimi | 12.5 Hz | 12.5 | گفتار استریمینگ |
در فرکانس 12.5 Hz، یک گفتار 10 ثانیهای تنها 125 فریم کدک است — دنبالهای که یک ترنسفورمر به سادگی از پس پیشبینی آن برمیآید.
توکنهای معنایی در برابر صوتی
frame_t → [semantic_token_t, acoustic_token_0_t, acoustic_token_1_t, ..., acoustic_token_6_t]- توکن معنایی (کتاب کد 0 در Mimi): محتوای بیانشده — واجها، کلمات و محتوا — را کدگذاری میکند. این بخش از طریق یک تابع زیانِ پیشبینی کمکی از WavLM تقطیر شده است.
- توکنهای صوتی (کتابهای کد 1 تا 7): طنین صدا، هویت گوینده، آهنگ کلام (prosody)، نویز پسزمینه و جزئیات دقیق را ثبت میکنند.
یک مدل زبانی خودبازگشتی (AR LM) ابتدا توکن معنایی را (مشروط به متن) پیشبینی میکند و سپس به سراغ توکنهای صوتی (مشروط به توکن معنایی + نمونه مرجع گوینده) میرود. این تفکیک دلیل اصلی توانایی سیستمهای مدرن تبدیل متن به گفتار (TTS) در شبیهسازی صدا با روش صفر-داده (zero-shot) است: مدل معنایی محتوا را مدیریت میکند و مدل صوتی طنین صدا را به دست میگیرد.
کیفیت بازسازی در سال 2026 (بیت بر ثانیه؛ نرخ بیت پایینتر بهتر است)
| کدک | نرخ بیت | PESQ | ViSQOL |
|---|---|---|---|
| Opus-20kbps | 20 kbps | 4.0 | 4.3 |
| EnCodec-6kbps | 6 kbps | 3.2 | 3.8 |
| DAC-6kbps | 6 kbps | 3.5 | 4.0 |
| SNAC-3kbps | 3 kbps | 3.3 | 3.8 |
| Mimi-4.4kbps | 4.4 kbps | 3.1 | 3.7 |
کدکهای سنتی مانند Opus هنوز هم از نظر کیفیت ادراکی به ازای هر بیت برتری دارند. اما مزیت کدکهای عصبی در توکنهای گسسته (که Opus تولید نمیکند) و کیفیت در مدلهای زایشی (Generative model) است (یعنی آنچه مدل زبانی میتواند با این توکنها بسازد).
پیادهسازی
گام 1: انکود با EnCodec
from encodec import EncodecModel
import torch

model = EncodecModel.encodec_model_24khz()
model.set_target_bandwidth(6.0)  # kbps

wav = torch.randn(1, 1, 24000)
with torch.no_grad():
    encoded = model.encode(wav)
codes, scale = encoded[0]
# codes: (1, n_codebooks, n_frames), dtype=int64
تنظیم n_codebooks=8 در نرخ 6 kbps. هر کد بین 0 تا 1023 (10 بیتی) است.
گام 2: دیکود و سنجش بازسازی
with torch.no_grad():
    wav_recon = model.decode([(codes, scale)])

from torchaudio.functional import compute_deltas
import torch.nn.functional as F

mse = F.mse_loss(wav_recon[:, :, :wav.shape[-1]], wav).item()
گام 3: تفکیک معنایی-صوتی (به سبک Mimi)
from moshi.models import loaders
mimi = loaders.get_mimi()

with torch.no_grad():
    codes = mimi.encode(wav)  # shape (1, 8, frames@12.5Hz)

semantic = codes[:, 0]
acoustic = codes[:, 1:]
کتاب کد معنایی 0 با WavLM همراستاست. بنابراین میتوانید یک ترنسفورمرِ متن-به-معنا آموزش دهید — با دامنهی واژگانی بسیار کوچکتر نسبت به تبدیل مستقیم متن به صوت. سپس یک دیکودر جداگانهی صوت-به-شکلموج بر اساس نمونه صدای مرجع گوینده شرطیسازی میشود.
گام 4: چرا مدل زبانی خودبازگشتی روی توکنهای کدک کارآمد است
برای یک قطعه گفتار 10 ثانیهای با نرخ 12.5 Hz و 8 کتاب کدِ Mimi:
1000 توکن زمینهی کاری ناچیزی برای ترنسفورمر است. یک ترنسفورمر با 256 میلیون پارامتر میتواند 10 ثانیه گفتار را ظرف چند میلیثانیه روی یک GPU امروزی تولید کند.
کاربرد عملی
نگاشت مسئله → کدک:
| مسئله | کدک |
|---|---|
| تولید عمومی موسیقی | EnCodec-24k |
| بازسازی با بالاترین سطح وفاداری | DAC-44.1k |
| مدل زبانی خودبازگشتی روی گفتار (TTS) | SNAC یا Mimi |
| مکالمهی صوتی دوطرفهی استریمینگ (Full-duplex) | Mimi (12.5 Hz) |
| آرشیو جلوههای صوتی مشروط به متن | EnCodec + شرطگذاری T5 |
| ویرایش دقیق صوت | DAC + اینپینتینگ (Inpainting) |
قاعدهی سرانگشتی: اگر مدل زایشی میسازید، با Mimi یا SNAC شروع کنید. اگر دنبال یک پایپلاین (Pipeline) فشردهسازی هستید، سراغ Opus بروید.
دامهای رایج
- تعداد بیش از حد کتابهای کد. افزایش کتابهای کد وضوح صدا را خطی بالا میبرد، اما طول دنبالهی ورودی به مدل زبانی هم خطی رشد میکند. کار را روی 8 تا 12 متوقف کنید.
- ناهماهنگی نرخ فریم. آموزش مدل زبانی روی Mimi با نرخ 12.5 Hz و سپس فاینتیونینگ (Fine-tuning) آن روی EnCodec با نرخ 50 Hz بدون هیچ خطایی بیصدا شکست میخورد.
- فرض برابری همهی کتابهای کد. در Mimi، کتاب کد 0 محتوا را حمل میکند؛ از دست دادنش وضوح گفتار را کاملاً نابود میکند. در حالی که از دست رفتن کتاب کد 7 اصلاً به چشم نمیآید.
- اتکا به کیفیت بازسازی به عنوان تنها معیار. یک کدک میتواند بازسازی فوقالعادهای داشته باشد، اما اگر ساختار معنایی ضعیفی ارائه دهد، برای تولید مبتنی بر مدل زبانی کاملاً بیاستفاده است.
تحویل پروژه
خروجی را در مسیر outputs/skill-codec-picker.md ذخیره کنید. سیستمی طراحی کنید که بر اساس نوع تسک (تولیدی یا فشردهسازی)، کدک مناسب را انتخاب کند.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. این برنامه یک کوانتایزر نردهای اسباببازی به همراه باقیمانده را پیادهسازی کرده و خطای بازسازی (Reconstruction Error) را با افزودن کتابهای کد میسنجد. - متوسط. کتابخانهی
encodecرا نصب کنید و خروجی 1، 4، 8 و 32 کتاب کد را روی یک نمونه گفتار تست بررسی کنید. نمودار PESQ یا MSE را بر حسب نرخ بیت رسم کنید. - پیشرفته. مدل Mimi را لود کنید. یک کلیپ صوتی را انکود کنید. مقادیر کتاب کد 0 را با اعداد صحیح تصادفی جایگزین و سپس دیکود کنید. همین کار را برای کتاب کد 7 هم تکرار کنید. این دو خروجی تخریبشده را با هم مقایسه کنید — دستکاری کتاب کد 0 باید وضوح کلام را کاملاً از بین ببرد؛ در حالی که دستکاری کتاب کد 7 نباید تغییر محسوسی ایجاد کند.
اصطلاحات کلیدی
| اصطلاح | اصطلاح عامیانه | معنای دقیق فنی |
|---|---|---|
| RVQ | کوانتیزاسیون باقیمانده | آبشاری از کتابهای کد کوچک؛ هر مرحله باقیماندهی مرحلهی قبل را کوانتایز میکند. |
| نرخ فریم (Frame rate) | سرعت کدک | تعداد فریمهای توکن در ثانیه. نرخ کمتر = پردازش سریعتر مدل زبانی. |
| کتاب کد معنایی (Semantic codebook) | کتاب کد 0 (در Mimi) | کتاب کدی که از ویژگیهای خودنظارتی (SSL) تقطیر شده است و محتوا را ذخیره میکند. |
| کتابهای کد صوتی (Acoustic codebooks) | باقی کتابهای کد | طنین صدا، لحن، نویز و جزئیات دقیق. |
| PESQ / ViSQOL | کیفیت ادراکی | معیارهای عینی همبسته با نمرهی میانگین نظر کاربران (MOS). |
| EnCodec | کدک متا | مدل پایهی RVQ؛ استفادهشده در MusicGen. |
| Mimi | کدک کیوتای | با نرخ فریم 12.5 Hz؛ تفکیک معنایی-صوتی؛ موتور پیشران Moshi. |
برای مطالعهی بیشتر
- Défossez et al. (2023). EnCodec — مدل پایهی RVQ.
- Kumar et al. (2023). Descript Audio Codec (DAC) — کدک متنباز با بالاترین سطح وفاداری بازسازی.
- Siuzdak (2024). SNAC — معماری RVQ چندمقیاسی.
- Kyutai (2024). Mimi codec — تفکیک معنایی-صوتی و تقطیر دانش از WavLM.
- Borsos et al. (2023). AudioLM — الگوی دومرحلهای معنایی/صوتی.
- Zeghidour et al. (2021). SoundStream — کدک جریانپذیر RVQ اصلی با پشتیبانی از استریمینگ.