
تبدیل صوت به متن (Speech-to-Text یا ASR) یکی از مهمترین چالشهای مهندسی پردازش زبان و هوش مصنوعی است. مشکل بنیادین اینجاست که سیگنال صوتی بر خلاف متن، تناظر یکبهیک با حروف ندارد؛ گفتن یک کلمهی کوتاه ممکن است چند صد میلیثانیه یا بیش از یک ثانیه طول بکشد، سکوت در گفتار جریان دارد و تعداد توکنهای خروجی از قبل مشخص نیست.
برای حل این ناهمترازی، سه رویکرد اصلی شامل دستهبندی زمانی پیوندگرا (CTC)، ترنسدیوسر مبتنی بر شبکه بازگشتی (RNN-T) و مدلهای انکودر-دیکودر اتنشن (نظیر Whisper) تکامل یافتهاند. درک تفاوت میان این سه معماری به شما امکان میدهد بسته به نیاز پروژهتان—از پردازش بلادرنگ و استریمینگ با تاخیر کم گرفته تا رونویسی فوقدقیق و آفلاین—بهترین گزینه را انتخاب کنید.
اگر برای دانلود وزن مدلها یا کار با مخازنی مثل Hugging Face و PyPI با کندی یا اختلال دسترسی مواجهید، میتوانید از آینههای داخلی یا ابزارهای مدیریت بستهی سریعتر کمک بگیرید. همچنین اجرای مدلهای پایهی این درس با پردازندههای معمول یا سیستمهای شخصی کاملاً امکانپذیر است و برای گامهای اول نیازی به سختافزارهای گرانقیمت ابری نخواهید داشت.
تشخیص گفتار در واقع دستهبندی صوت در تکتک گامهای زمانی است؛ کلافی که یک مدل توالی با شناخت از زبان انگلیسی و سکوت، تکههایش را به هم پیوند میزند. CTC، RNN-T و اتنشن (attention) سه راهکار برای انجام این کار هستند. یکی را انتخاب کنید و دلیلش را بفهمید.
صورت مسئله
یک کلیپ صوتی 10 ثانیهای با نرخ 16 kHz در دست دارید و خروجی متنی "turn on the kitchen lights" را میخواهید. چالش اصلی ساختاری است: فریمهای صوتی تناظر یکبهیک با کاراکترها ندارند. ادای کلمهی "okay" ممکن است 200 میلیثانیه یا 1200 میلیثانیه طول بکشد. گفتار با سکوت تقطیع میشود. طول برخی واجها از بقیه بیشتر است و تعداد توکنهای خروجی را هم از پیش نمیدانید.
سه فرمولبندی برای حل این مسئله وجود دارد:
- CTC (دستهبندی زمانی پیوندگرا / Connectionist Temporal Classification): به ازای هر فریم، توزیع احتمالاتی روی توکنها تولید میکند که شامل یک توکن ویژهی blank نیز هست. هنگام رمزگشایی (decode)، تکرارها و توکنهای خالی ادغام و حذف میشوند. این روش غیرخودهمبسته (non-autoregressive) و سریع است و در مدلهایی مثل wav2vec 2.0 و MMS استفاده میشود.
- RNN-T (مبدل شبکه عصبی بازگشتی / Recurrent Neural Network Transducer): یک شبکهی توأم دارد که توکن بعدی را بر اساس فریم انکودر و توکنهای قبلی پیشبینی میکند. قابلیت استریمینگ دارد و در سامانهی تشخیص گفتار روی دستگاه گوگل و مدل Parakeet از NVIDIA به کار میرود.
- انکودر-دیکودر مبتنی بر اتنشن (Attention encoder-decoder): انکودر صدا را به وضعیتهای پنهان (hidden states) فشرده میکند و دیکودر با اتنشن متقاطع (cross-attention) توکنها را به شکل خودهمبسته میسازد. مدلهای Whisper و SeamlessM4T از این معماری استفاده میکنند.
در سال 2026، بهترین معیار خطای کلمه (WER) در مجموعهدادهی LibriSpeech test-clean برابر 1.4% (مدل Parakeet-TDT-1.1B از NVIDIA) و 1.58% (مدل Whisper-Large-v3-turbo) است. تفاوتها بسیار ناچیزند، اما تفاوتهای عملیاتی آنها هنگام استقرار بسیار چشمگیر است.
درک مفهومی
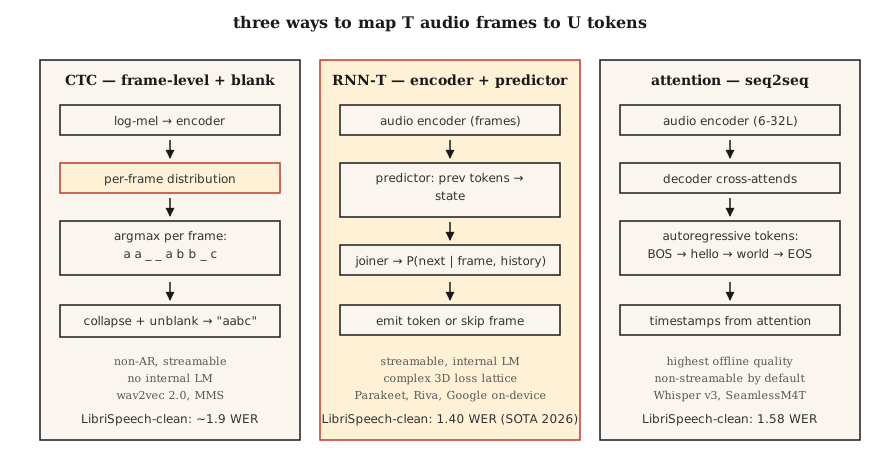
شهود CTC. فرض کنید انکودر به ازای هر کدام از T فریم، یک توزیع روی V+1 توکن خروجی میدهد (V کاراکتر به اضافهی blank). برای رشتهی هدف y با طول U < T، هر تراز فریمی که پس از ادغام و حذف موارد تکراری و blank به y تبدیل شود، به حساب میآید. تابع زیان (loss) در CTC روی تمام این ترازها مجموع میگیرد. استنتاج: محاسبهی argmax روی هر فریم، فشردهسازی تکرارها و حذف توکنهای blank.
مزایا: غیرخودهمبسته، پشتیبانی از استریمینگ و دید رو به جلو صفر (zero lookahead). نقطه ضعف: فرض استقلال شرطی (conditional independence)؛ پیشبینی هر فریم مستقل از بقیه است و در نتیجه مدل زبانی درونی وجود ندارد. راهحل: پیوند با یک مدل زبانی خارجی از طریق جستجوی پرتو یا تلفیق سطحی (shallow fusion).
شهود RNN-T. یک شبکهی پیشبین (predictor) اضافه میکند که تاریخچهی توکنها را تعبیه (embed) میکند و یک پیونددهنده (joiner) که وضعیت پیشبین را با فریم انکودر ترکیب کرده و توزیع توأم روی V+1 توکن میسازد (که +1 در اینجا توکن null / عدم تولید است). این ساختار وابستگی شرطی را که در CTC نادیده گرفته شده بود، به صورت صریح مدل میکند. از آنجا که هر گام فقط به فریمها و توکنهای گذشته مشروط است، قابلیت استریمینگ دارد.
مزایا: پشتیبانی از استریمینگ به همراه مدل زبانی درونی. نقطه ضعف: آموزش پیچیدهتر و پرمصرفتر از نظر حافظه (مشبکهی سهبعدی تابع زیان)؛ تا جایی که کرنلهای تابع زیان RNN-T خودشان یک شاخهی کامل از کتابخانههای نرمافزاری هستند.
انکودر-دیکودر اتنشن. انکودر (شامل 6 تا 32 لایهی ترنسفورمر) روی فریمهای log-mel اعمال میشود. دیکودر (با 6 تا 32 لایهی ترنسفورمر) با اتنشن متقاطع روی خروجیهای انکودر، توکنها را به شکل خودهمبسته تولید میکند. هیچ قید ترازی وجود ندارد؛ اتنشن میتواند به هر نقطهای از فایل صوتی نگاه کند. این ساختار امکان استریمینگ ندارد، مگر اینکه دامنهی اتنشن را محدود کنید (مانند Whisper-Streaming قطعهبندیشده، 2024).
مزایا: بالاترین کیفیت در ASR آفلاین و آموزش آسان با ابزارهای رایج seq2seq. نقطه ضعف: تاخیر خودهمبسته با طول خروجی متناسب است؛ پیادهسازی استریمینگ روی آن به مهندسی پیچیده نیاز دارد.
معیار WER: تنها عددی که اهمیت دارد
نرخ خطای کلمه (Word Error Rate) برابر است با ، که در آن نشاندهندهی جانشانیها (substitutions)، حذفها (deletions)، درجها (insertions) و تعداد کلمات مرجع است. این فرمول با فاصلهی ویرایشی لوناشتاین (Levenshtein) در سطح کلمه برابری میکند. هرچه کمتر باشد بهتر است. نرخ خطای بالای 20% عموماً غیرقابل استفاده است؛ در حالی که ارقام زیر 5% برای گفتار خواندهشده با دقت شنوایی انسان برابری میکند. ارقام ثبتشده روی بنچمارکهای استاندارد در سال 2026:
| مدل | LibriSpeech test-clean | LibriSpeech test-other | اندازه |
|---|---|---|---|
| Parakeet-TDT-1.1B | 1.40% | 2.78% | 1.1B پارامتر |
| Whisper-Large-v3-turbo | 1.58% | 3.03% | 809M |
| Canary-1B Flash | 1.48% | 2.87% | 1B |
| Seamless M4T v2 | 1.7% | 3.5% | 2.3B |
همهی این سیستمها مبتنی بر انکودر-دیکودر یا RNN-T هستند. سیستمهای صرفاً مبتنی بر CTC (مثل wav2vec 2.0) روی دادههای test-clean دقتی حدود 1.8 تا 2.1 درصد دارند.
پیادهسازی عملی
گام 1: رمزگشایی حریصانه (Greedy Decode) در CTC
def ctc_greedy(frame_logits, blank=0, vocab=None):
    # frame_logits: لیستی از بردارهای احتمال به ازای هر فریم
    preds = [max(range(len(p)), key=lambda i: p[i]) for p in frame_logits]
    out = []
    prev = -1
    for p in preds:
        if p != prev and p != blank:
            out.append(p)
        prev = p
    return "".join(vocab[i] for i in out) if vocab else out
دو قاعده دارد: تکرارهای پیاپی را ادغام کنید و توکنهای blank را دور بریزید. مثال: a a _ _ a b b _ c تبدیل میشود به a a b c.
گام 2: رمزگشایی با جستجوی پرتو در CTC
def ctc_beam(frame_logits, beam=8, blank=0):
    import math
    beams = [([], 0.0)]  # (tokens, log_prob)
    for p in frame_logits:
        log_p = [math.log(max(pi, 1e-10)) for pi in p]
        candidates = []
        for seq, lp in beams:
            for t, lpt in enumerate(log_p):
                new = seq[:] if t == blank else (seq + [t] if not seq or seq[-1] != t else seq)
                candidates.append((new, lp + lpt))
        candidates.sort(key=lambda x: -x[1])
        beams = candidates[:beam]
    return beams[0][0]
در محیطهای عملیاتی از جستجوی پرتو بر پایهی درخت پیشوندی همراه با تلفیق مدل زبانی (LM fusion) استفاده میشود؛ کد بالا ساختار مفهومی آن است.
گام 3: محاسبهی WER
def wer(ref, hyp):
    r, h = ref.split(), hyp.split()
    dp = [[0] * (len(h) + 1) for _ in range(len(r) + 1)]
    for i in range(len(r) + 1):
        dp[i][0] = i
    for j in range(len(h) + 1):
        dp[0][j] = j
    for i in range(1, len(r) + 1):
        for j in range(1, len(h) + 1):
            cost = 0 if r[i - 1] == h[j - 1] else 1
            dp[i][j] = min(
                dp[i - 1][j] + 1,
                dp[i][j - 1] + 1,
                dp[i - 1][j - 1] + cost,
            )
    return dp[len(r)][len(h)] / max(1, len(r))
گام 4: استنتاج با مدل Whisper
import whisper
model = whisper.load_model("large-v3-turbo")
result = model.transcribe("clip.wav")
print(result["text"])
یک خط کد برای استفاده از قویترین ASR همهمنظوره در سال 2026. این مدل روی یک پردازندهی گرافیکی 24 GB با سرعتی حدود 20 برابر زمان واقعی (realtime) اجرا میشود.
گام 5: استریمینگ با Parakeet یا wav2vec 2.0
from transformers import pipeline
asr = pipeline("automatic-speech-recognition", model="nvidia/parakeet-tdt-1.1b")
for chunk in streaming_audio():
print(asr(chunk, return_timestamps=True))سیستمهای ASR استریمینگ به اتنشن قطعهبندیشده در انکودر و انتقال وضعیت حافظه (carryover state) نیاز دارند؛ از کتابخانههایی استفاده کنید که از این قابلیت پشتیبانی میکنند (NeMo برای Parakeet و پایپلاین transformers با chunk_length_s).
کاربرد در عمل
ترکیب پیشنهادی در سال 2026:
| موقعیت | انتخاب مناسب |
|---|---|
| انگلیسی، آفلاین، بالاترین کیفیت | Whisper-large-v3-turbo |
| چندزبانه، مستحکم | SeamlessM4T v2 |
| استریمینگ، تاخیر کم | Parakeet-TDT-1.1B یا Riva |
| پردازش لبه، موبایل، تاخیر کمتر از 500 میلیثانیه | Whisper-Tiny کوانتایزشده یا Moonshine (2024) |
| فایل صوتی طولانی | Whisper به همراه قطعهبندی متن بر پایهی VAD (مثل WhisperX) |
| حوزههای تخصصی (پزشکی، حقوقی) | تنظیم دقیق (Fine-tune) مدل wav2vec 2.0 + تلفیق مدل زبانی تخصصی |
دامهایی که هنوز در سال 2026 به محیط پروداکشن راه مییابند
- استفاده نکردن از VAD: اجرای Whisper روی سکوت، توهم تولید میکند ("Thanks for watching!"). همیشه ورودی را با VAD پالایش کنید.
- تفاوت WER در سطح کاراکتر، کلمه و زیرکلمه: مقدار WER را در سطح کلمه و پس از نرمالسازی (کوچک کردن حروف انگلیسی، حذف نشانههای نگارشی) گزارش دهید.
- انحراف در شناسایی زبان (Language ID drift): سیستم تشخیص خودکار زبان Whisper در کلیپهای دارای نویز دچار خطا میشود و زبان را به اشتباه ژاپنی یا ولزی تشخیص میدهد؛ اگر زبان را میدانید، صراحتاً
language="en"را اجباری کنید. - کلیپهای طولانی بدون قطعهبندی متن: پنجرهی Whisper معادل 30 ثانیه است. برای هر صوت طولانیتر، از
chunk_length_s=30, stride=5استفاده کنید.
تحویل پروژه
خروجی را در فایل outputs/skill-asr-picker.md ذخیره کنید. بر اساس هدف استقرار، مدل، استراتژی رمزگشایی، قطعهبندی متن و شیوهی تلفیق مدل زبانی را انتخاب کنید.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. این کد یک خروجی دستساز CTC را به شکل حریصانه رمزگشایی کرده و WER آن را نسبت به متن مرجع محاسبه میکند. - متوسط. جستجوی پرتو با درخت پیشوندی را در گام 2 به شکل اصولی پیادهسازی کنید (قاعدهی merge برای توکن blank را به درستی لحاظ کنید). عملکرد آن را در مقایسه با روش حریصانه روی یک مجموعهدادهی ساختگی 10 نمونهای مقایسه کنید.
- سخت. مدل
whisper-large-v3-turboرا روی LibriSpeech test-clean به کار بگیرید. WER را برای 100 عبارت اول محاسبه کنید و آن را با ارقام منتشرشده بسنجید.
اصطلاحات کلیدی
| اصطلاح | در گفتار عامیانه | مفهوم دقیق فنی |
|---|---|---|
| CTC | تابع زیان توکن blank | توزیع حاشیهای روی تمام ترازهای فریم به توکن؛ غیرخودهمبسته. |
| RNN-T | تابع زیان مناسب استریمینگ | ساختار CTC به همراه پیشبین توکن بعدی؛ ترتیب کلمات را مدیریت میکند. |
| Attention enc-dec | سبک Whisper | انکودر به همراه دیکودر دارای اتنشن متقاطع؛ بالاترین کیفیت آفلاین. |
| WER | عددی که گزارش میکنید | نسبت (S+D+I)/N در سطح کلمه. |
| Blank | خلأ / پوچی | توکن ویژه در CTC که نشان میدهد «در این فریم توکنی تولید نمیشود». |
| LM fusion | مدل زبانی خارجی | افزودن لگاریتم احتمالات وزندارِ یک مدل زبانی در طول جستجوی پرتو. |
| VAD | دروازهی سکوت | آشکارساز فعالیت صوتی؛ بخشهای غیرگفتاری را حذف میکند. |
مطالعهی بیشتر
- Graves et al. (2006). Connectionist Temporal Classification — مقالهی CTC.
- Graves (2012). Sequence Transduction with RNNs — مقالهی RNN-T.
- Radford et al. / OpenAI (2022). Whisper: Robust Speech Recognition via Large-Scale Weak Supervision — مقالهی مرجع سال 2022؛ همراه با نسخهی توسعهیافتهی v3-turbo در سال 2024.
- NVIDIA NeMo — Parakeet-TDT card — صدرنشین Open ASR Leaderboard در سال 2026.
- Hugging Face — Open ASR Leaderboard — بنچمارک زنده بین بیش از 25 مدل.