
در ساخت دستیارهای صوتی بیدرنگ، چالش اصلی صرفاً تبدیل صدا به متن یا تولید پاسخ هوشمند نیست؛ بلکه زمانبندی دقیق مکالمه تعیینکننده است. اگر سیستم نتواند شروع و پایان صحبت را بهدرستی بفهمد، یا مداوم وسط حرف کاربر میپرد یا با تاخیرهای طولانی حس کندی و غیرطبیعی بودن را منتقل میکند. راهکارهای ساده مانند بررسی سطح انرژی صدا در محیطهای پرنویز شهری یا اداری بهسرعت با شکست مواجه میشوند.
در این درس معماری چندلایهی تشخیص فعالیت صوتی (VAD) را بررسی میکنیم. ابتدا نحوهی بهکارگیری مدلهای سبکی چون Silero VAD را یاد میگیرید که با حداقل سربار پردازشی روی یک هستهی CPU اجرا میشوند و نیازی به سرورها یا GPUهای گرانقیمت ندارند. سپس با مفهوم مهلت سکوت، بافر پیشرویداد و اندپوینتینگ معنایی آشنا میشوید تا مکثهای طبیعی حین فکر کردن کاربر با اتمام جمله اشتباه گرفته نشود.
در نهایت ترفند تخلیه (Flush trick) را برای بهینهسازی تاخیر خط لولهی صوتی پیادهسازی میکنید؛ روشی که تاخیر لایهی تبدیل گفتار به متن را تا حدود 125 میلیثانیه کاهش داده و تجربهای نزدیک به گفتوگوی زنده خلق میکند.
بقا یا نابودی هر ایجنت صوتی در گرو دو تصمیم حیاتی است: آیا کاربر در حال حاضر صحبت میکند، و آیا حرفش تمام شده است؟ تشخیص فعالیت صوتی (Voice Activity Detection یا VAD) به سوال اول پاسخ میدهد. تشخیص نوبت مکالمه (ترکیب VAD + مهلت سکوت + مدل معنایی اندپوینت) پاسخگوی سوال دوم است. اگر در هر کدام از این دو اشتباه کنید، دستیار صوتی شما یا وسط حرف کاربر میپرد، یا هیچوقت ساکت نمیشود.
صورت مسئله
یک ایجنت صوتی برای هر چانک 20 میلیثانیهای، سه تصمیم کاملاً مجزا میگیرد:
- آیا این فریم حاوی گفتار است؟ — وظیفهی VAD؛ تصمیمی دوگانه (باینری) به ازای هر فریم.
- آیا کاربر صحبت جدیدی را شروع کرده است؟ — تشخیص شروع گفتار (onset detection).
- آیا صحبت کاربر تمام شده است؟ — تعیین پایان گفتار یا اندپوینتینگ (end-pointing).
راهکار سادهانگارانه (آستانهی انرژی صدا) با کوچکترین نویزی، مثل صدای ترافیک، کیبورد یا همهمهی محیط، به هم میریزد. راهکار استاندارد سال 2026 این است: Silero VAD (متنباز و مبتنی بر یادگیری عمیق) + یک مدل تشخیص نوبت (اندپوینتینگ معنایی) + مهلت سکوت کالیبرهشده با VAD.
مفهوم
آبشار سهلایهی VAD
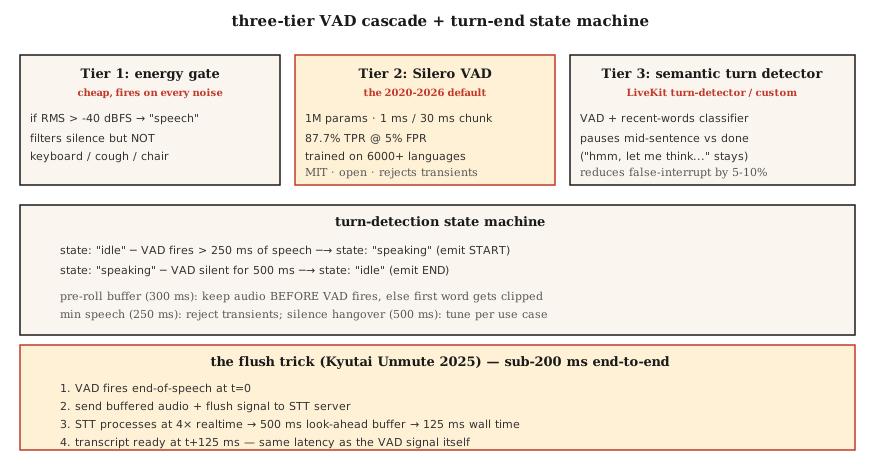
لایهی 1: گیت انرژی (energy gate). کمهزینهترین بخش. آستانهی مقدار جذر میانگین مربعات (RMS) را روی -40 dBFS فیکس میکند. سکوتهای واضح را فیلتر میکند، اما با هر نویزی بالاتر از این آستانه فعال میشود.
لایهی 2: مدل Silero VAD (سالهای 2020 تا 2026، با مجوز MIT). این مدل 1 میلیون پارامتری روی بیش از 6000 زبان آموزش دیده است. روی یک رشتهی پردازنده در حدود 1 میلیثانیه به ازای هر چانک 30 میلیثانیهای اجرا میشود. نرخ مثبت واقعی (TPR) آن در ازای 5 درصد نرخ مثبت کاذب (FPR)، برابر با 87.7% است؛ گزینهی پیشفرض و استاندارد دنیای متنباز.
لایهی 3: تشخیصدهندهی معنایی نوبت. مدل تشخیص نوبت LiveKit (سالهای 2024 تا 2026) یا یک دستهبند کوچک که خودتان آموزش دادهاید. این بخش «مکث در میانهی جمله» را از «پایان صحبت» تفکیک میکند و بهجای اتکا به سکوتِ صرف، از بافتار زبانی (لحن صدا + واژههای اخیر) بهره میگیرد.
پارامترهای کلیدی و مقادیر پیشفرض آنها
- آستانه (Threshold): مدل Silero یک خروجی احتمالاتی تولید میکند؛ مقادیر بالاتر از 0.5 (پیشفرض) یا بالاتر از 0.3 (حالت حساس) را به عنوان گفتار دستهبندی کنید. آستانهی پایینتر یعنی بریدهنشدن ابتدای کلمات اول، اما در عوض مثبتهای کاذب بیشتر میشوند.
- حداقل مدت گفتار (Minimum speech duration): صداهای کوتاهتر از 250 میلیثانیه را فیلتر کنید؛ این صداها معمولاً سرفه یا جابهجایی صندلی هستند.
- مهلت سکوت یا Silence hangover (اندپوینتینگ): پس از اینکه خروجی VAD به 0 برگشت، قبل از اعلام پایان نوبت، 500 تا 800 میلیثانیه منتظر بمانید. اگر این زمان خیلی کوتاه باشد، وسط حرف کاربر میپرید؛ اگر خیلی طولانی باشد، سیستم کند و سنگین به نظر میرسد.
- بافر پیشرویداد (Pre-roll buffer): مقدار 300 تا 500 میلیثانیه از صدا را پیش از فعالشدن VAD در حافظه نگه دارید. این کار جلوی بریدهشدن سلام یا هجاهای آغازین را میگیرد.
ترفند تخلیه یا Flush (از Kyutai در سال 2025)
مدلهای تبدیل گفتار به متن (STT) در حالت استریمینگ، یک تاخیر روبهجلو (look-ahead delay) دارند (500 میلیثانیه برای Kyutai STT-1B و 2.5 ثانیه برای STT-2.6B). در حالت عادی باید بعد از پایان گفتار دقیقاً همینقدر منتظر بمانید تا متن کامل شود. ترفند Flush به این صورت است: وقتی VAD پایان گفتار را تشخیص داد، یک سیگنال flush به STT بفرستید تا خروجی را بلافاصله تولید کند. از آنجا که STT با سرعتی حدود 4 برابر زمان واقعی (realtime) پردازش میکند، بافر 500 میلیثانیهای ظرف حدود 125 میلیثانیه خالی و متن آماده میشود.
نتیجهی سرتاسری: 125 میلیثانیه VAD + تبدیل گفتار به متن با ترفند flush = تاخیر در حد گفتوگوی طبیعی.
مقایسهی مدلهای VAD در سال 2026
| VAD | نرخ TPR در FPR معادل 5% | تاخیر | مجوز |
|---|---|---|---|
| WebRTC VAD (گوگل، 2013) | 50.0% | 30 میلیثانیه | BSD |
| Silero VAD (2020-2026) | 87.7% | ~1 میلیثانیه | MIT |
| Cobra VAD (از Picovoice) | 98.9% | ~1 میلیثانیه | تجاری |
| pyannote segmentation | 95% | ~10 میلیثانیه | شبهMIT |
مدل Silero انتخاب پیشفرض و معقولی است. Cobra گزینهی ارتقا برای دقت تجاری و انطباق قانونی به حساب میآید. VAD مبتنی بر انرژیِ صرف نیز در پروداکشن سال 2026 هیچ جایگاهی ندارد.
پیادهسازی
گام 1: گیت انرژی
def energy_vad(chunk, threshold_dbfs=-40.0):
    rms = (sum(x * x for x in chunk) / len(chunk)) ** 0.5
    dbfs = 20.0 * math.log10(max(rms, 1e-10))
    return dbfs > threshold_dbfs
گام 2: پیادهسازی Silero VAD در Python
from silero_vad import load_silero_vad, get_speech_timestamps

vad = load_silero_vad()
audio = torch.tensor(waveform_16k, dtype=torch.float32)
segments = get_speech_timestamps(
    audio, vad, sampling_rate=16000,
    threshold=0.5,
    min_speech_duration_ms=250,
    min_silence_duration_ms=500,
    speech_pad_ms=300,
)
for s in segments:
    print(f"{s['start']/16000:.2f}s - {s['end']/16000:.2f}s")
گام 3: ماشین وضعیت تشخیص پایان نوبت
class TurnDetector:
    def __init__(self, silence_hangover_ms=500, min_speech_ms=250):
        self.state = "idle"
        self.speech_ms = 0
        self.silence_ms = 0
        self.silence_hangover_ms = silence_hangover_ms
        self.min_speech_ms = min_speech_ms

    def update(self, is_speech, chunk_ms=20):
        if is_speech:
            self.speech_ms += chunk_ms
            self.silence_ms = 0
            if self.state == "idle" and self.speech_ms >= self.min_speech_ms:
                self.state = "speaking"
                return "START"
        else:
            self.silence_ms += chunk_ms
            if self.state == "speaking" and self.silence_ms >= self.silence_hangover_ms:
                self.state = "idle"
                self.speech_ms = 0
                return "END"
        return None
گام 4: اسکلت اصلی ترفند Flush
def flush_on_end(stt_client, audio_buffer):
    stt_client.send_audio(audio_buffer)
    stt_client.send_flush()
    return stt_client.recv_transcript(timeout_ms=150)
برای کارکرد این روش، سرویس STT (مانند Kyutai، Deepgram یا AssemblyAI) باید حتماً از flush پشتیبانی کند. مدل استریمینگ Whisper چنین قابلیتی ندارد؛ چون ساختار بلوکی دارد و همیشه منتظر رسیدن همهی چانکها میماند.
کاربرد در عمل
| موقعیت | انتخاب VAD |
|---|---|
| متنباز، سریع و همهمنظوره | Silero VAD |
| کالسنتر تجاری | Cobra VAD |
| روی دستگاه (گوشی موبایل) | Silero VAD با ONNX |
| پروژههای تحقیقاتی / تفکیک گوینده (Diarization) | pyannote segmentation |
| گزینهی بکآپ بدون وابستگی خارجی | WebRTC VAD (قدیمی) |
| نیاز به بالاترین کیفیت در پایان نوبت | لایهبندی Silero به همراه مدل تشخیص نوبت LiveKit |
یک قانون سرانگشتی: هرگز سراغ VAD انرژیمحور نروید، مگر اینکه واقعاً هیچ چارهی دیگری نداشته باشید.
دامها و خطاهای رایج
- آستانهی ثابت: در محیط آرام کار میکند، در محیط شلوغ از کار میافتد. یا آستانه را روی خود دستگاه کالیبره کنید، یا سراغ Silero بروید.
- مهلت سکوت بیشازحد کوتاه: ایجنت وسط جملهی کاربر صحبت او را قطع میکند. بازهی 500 تا 800 میلیثانیه بهترین حالت برای گفتوگوی طبیعی است.
- مهلت سکوت بیشازحد طولانی: پاسخدهی سیستم کند به نظر میرسد. این مقدار را با کاربران هدف از طریق آزمون A/B بسنجید.
- نداشتن بافر پیشرویداد: 200 تا 300 میلیثانیهی اول از حرفهای کاربر حذف میشود. همیشه یک بافر پیشرویداد چرخشی نگه دارید.
- نادیدهگرفتن اندپوینتینگ معنایی: جملاتی مثل «اممم... بذار ببینم...» مکثهای طولانی دارند. کاربران از اینکه موقع فکر کردن حرفشان بریده شود متنفرند. از ابزار تشخیص نوبت LiveKit یا مدلهای مشابه استفاده کنید.
تحویل به پروداکشن
تنظیمات نهایی را در فایل outputs/skill-vad-tuner.md ذخیره کنید. در این فایل مدل VAD، آستانه، مهلت سکوت، بافر پیشرویداد و استراتژی تشخیص نوبت را بر اساس نیاز سیستم انتخاب کنید.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. این برنامه توالی گفتار + سکوت + گفتار + سرفه را شبیهسازی کرده و سه لایهی VAD را میسنجد. - متوسط. کتابخانهی
silero-vadرا نصب کنید، یک فایل صوتی ضبطشدهی 5 دقیقهای را به آن بدهید و آستانه را طوری تنظیم کنید که هم حذف ابتدای کلمات اول و هم موارد مثبت کاذب به حداقل برسند. در نهایت دقت (Precision) و بازخوانی (Recall) را گزارش دهید. - سخت. یک سیستم تشخیص نوبت مینیاتوری بسازید: ترکیب Silero VAD با یک پرسپترون چندلایه (MLP) سهلایه روی امبدینگهای 10 کلمهی آخر (با استفاده از sentence-transformers). مدل را روی یک دیتاست برچسبخورده از پایان نوبتها آموزش دهید و امتیاز F1 را حداقل 10% نسبت به استفاده از Silero بهتنهایی بهبود دهید.
اصطلاحات کلیدی
| اصطلاح | در بیان عامیانه | معنای دقیق فنی |
|---|---|---|
| VAD | تشخیصدهندهی صدا | تصمیم باینری فریمبهفریم: آیا این فریم گفتار است؟ |
| Turn detection | اندپوینتینگ | ترکیب VAD + مهلت سکوت + مدل معنایی اندپوینت. |
| Silence hangover | انتظار پس از گفتار | زمانی که پیش از اعلام پایان نوبت مکالمه منتظر میمانیم؛ معمولاً 500 تا 800 میلیثانیه. |
| Pre-roll | بافر پیش از گفتار | نگهداشتن 300 تا 500 میلیثانیه صدا پیش از فعالشدن VAD. |
| Flush trick | ترفند Kyutai | ارسال سیگنال از VAD به STT برای تخلیهی سریع ← کاهش تاخیر از 500 به 125 میلیثانیه. |
| Semantic endpoint | «آیا واقعاً حرفش تمام شد؟» | دستهبند یادگیری ماشین که بهجای سکوتِ صرف، کلمات را هم بررسی میکند. |
| TPR @ FPR 5% | نقطهی نمودار ROC | بنچمارک استاندارد سنجش VAD؛ 87.7% برای Silero و 50% برای WebRTC. |
مطالعهی بیشتر
- Silero VAD — مرجع استاندارد VAD متنباز.
- Picovoice Cobra VAD — گزینهی تجاری پیشتاز در دقت.
- Kyutai — Unmute + ترفند flush — ترفند مهندسی برای تاخیر زیر 200 میلیثانیه.
- LiveKit — تشخیص نوبت — اندپوینتینگ معنایی در پروداکشن.
- WebRTC VAD — بنچمارک و ابزار پایهی قدیمی.
- pyannote segmentation — قطعهبندی صدا با دقت مناسب برای تفکیک گوینده.