
شکلموجهای صوتی خام (raw waveforms) دادههایی حجیم و بهظاهر نامنظم هستند؛ مثلاً در یک فایل صوتی ساده با نرخ نمونهبرداری 16 kHz، هر ثانیه شامل 16,000 نمونه اعشاری است که بدون تغییر، الگوهای آکوستیک را بهخوبی در اختیار مدلهای هوش مصنوعی نمیگذارد. مدلهای مدرن بازشناسی گفتار (ASR)، تبدیل متن به گفتار (TTS) و دستهبندی صوت، ساختار فرکانسی بازههای چند میلیثانیهای را پردازش میکنند، نه نمونههای خام زمانی را.
در این درس گامبهگام بررسی میکنیم که چگونه تبدیل فوریه زمانکوتاه (STFT)، اعمال پنجرههای همپوشان و نگاشت فرکانسها به مقیاس مل (Mel scale) شکلموج اولیه را به تصویری دوبعدی و معنادار به نام مِلاسپکتوگرام بدل میسازد؛ همان بازنمایی استانداردی که سنگبنای مدلهایی نظیر Whisper و سامانههای نوین گفتار است.
کدهای استخراج ویژگیهای صوتی در این بخش محاسبات سبک ریاضی و مبتنی بر کتابخانههای استاندارد پایتون نظیر PyTorch و Librosa هستند. این عملیات بهسادگی روی پردازندهی مرکزی (CPU) رایانهی شخصی اجرا میشوند و نیازی به کارتهای گرافیکی گرانقیمت یا سرویسهای ابری خارجی ندارید.
شبکههای عصبی شکلموجهای خام (raw waveforms) را چندان خوب پردازش نمیکنند؛ خوراک آنها طیفنگاشتها (spectrograms) هستند، و حتی بهتر از آن، مِلاسپکتوگرامها (mel spectrograms). در سال 2026، مرگ و زندگی هر مدل بازشناسی خودکار گفتار (ASR)، تبدیل متن به گفتار (TTS) و دستهبندی صوتی به همین یک انتخاب در پیشپردازش بند است.
صورت مسئله
یک قطعهصوت 10 ثانیهای با نرخ 16 kHz را در نظر بگیرید؛ یعنی 160,000 عدد اعشاری در بازهی [-1, 1] که عملاً هیچ همبستگی با برچسبهایی مثل «پارس سگ» یا «کلمهی گربه» ندارند. شکلموج خام حاوی اطلاعات هست، اما نه در قالبی که مدل بتواند راحت استخراجش کند. دو واج کاملاً یکسان که با فاصلهی 100 ms از هم ادا شوند، نمونههای خام کاملاً متفاوتی تولید میکنند.
طیفنگاشت این مشکل را حل میکند: جزئیات زمانی را در جایی که درک شنوایی انسان نادیدهاش میگیرد (لرزشهای زمانی در حد میکروثانیه یا microsecond jitter) فشرده میسازد و ساختاری را که سیستم شنوایی به آن توجه دارد، حفظ میکند (اینکه در پنجرههای زمانی حدود 10 تا 25 ms، کدام فرکانسها انرژی بیشتری دارند).
مِلاسپکتوگرامها پا را فراتر میگذارند. درک انسان از بسامد (pitch) بهصورت لگاریتمی است؛ فاصلهی فرکانسی بین 100 Hz و 200 Hz از نظر شنوایی «همانقدر» حس میشود که فاصلهی بین 1000 Hz و 2000 Hz. مقیاس مل (mel scale) محور فرکانس را میپیچاند (warp میکند) تا با این ویژگی شنوایی منطبق شود. مِلاسپکتوگرام مهمترین ویژگی منفرد در یادگیری ماشین گفتار از سال 2010 تا 2026 به شمار میرود.
مفاهیم پایه
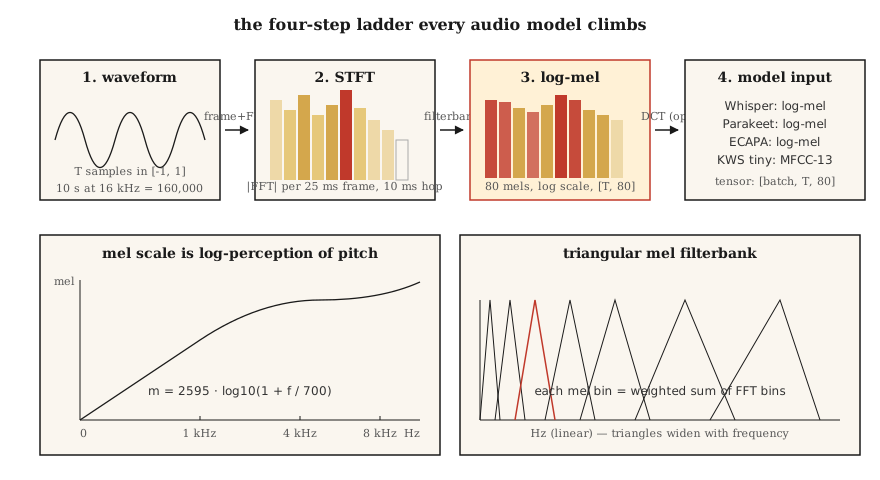
تبدیل فوریه زمانکوتاه یا STFT (کوتاهشدهی Short-Time Fourier Transform): شکلموج را به فریمهای همپوشان برش دهید (معمولاً پنجرهی 25 ms با گام لغزش یا hop معادل 10 ms که در نرخ 16 kHz برابر با 400 نمونه و 160 نمونه است). هر فریم را در یک تابع پنجره (Hann گزینهی پیشفرض است؛ Hamming توازن متفاوتی ارائه میدهد) ضرب کنید. روی هر فریم FFT بزنید. طیفهای بزرگی (magnitude spectra) را در ماتریسی با ابعاد (n_frames, n_freq_bins) روی هم بچینید؛ این همان طیفنگاشت شماست.
بزرگی لگاریتمی (Log-magnitude): مقادیر خام بزرگی در بازهای با دامنهی 5 تا 6 مرتبه بزرگی پخش شدهاند. برای فشردهسازی بازهی دینامیکی، از log(|X| + 1e-6) یا 20 * log10(|X|) استفاده کنید. در همهی پایپلاینهای پروداکشن، بزرگی لگاریتمی به کار میرود، نه مقدار خام آن.
مقیاس مل (Mel scale): فرکانس f بر حسب هرتز با رابطهی به مقدار مل m نگاشت میشود. این نگاشت برای فرکانسهای زیر 1 kHz تقریباً خطی و بالاتر از آن تقریباً لگاریتمی است. استاندارد ورودی ASR معمولاً 80 بین مل (mel bins) است که بازهی 0 تا 8 kHz را پوشش میدهد.
بانک فیلتر مل (Mel filterbank): مجموعهای از فیلترهای مثلثی که با فاصلههای مساوی روی مقیاس مل چیده شدهاند. هر فیلتر در واقع مجموع وزندار بینهای مجاور FFT است. با ضرب ماتریسی بزرگی STFT در ماتریس بانک فیلتر، مِلاسپکتوگرام تنها با یک عمل ضرب ماتریسی به دست میآید.
لاگ-ملاسپکتوگرام (Log-mel spectrogram): همان log(mel_spec + 1e-10). ورودی Whisper، ورودی Parakeet و ورودی SeamlessM4T؛ فرانتاند استاندارد و همهگیر پردازش صوت در سال 2026.
ضرایب کپسترال فرکانس مل (MFCCs): لاگ-ملاسپکتوگرام را بگیرید، تبدیل کسینوسی گسسته (DCT نوع 2) روی آن بزنید و 13 ضریب اول را نگه دارید. این کار همبستگی بین ویژگیها را از بین میبرد و ابعاد را فشردهتر میکند. MFCC تا حوالی سال 2015 ویژگی غالب بود؛ تا زمانی که شبکههای عصبی پیچشی (CNN) و ترنسفورمرها روی لاگ-مل خام به میدان آمدند و جای آن را گرفتند. با این حال، هنوز هم در بازشناسی گوینده (مثل x-vectors و ECAPA) کاربرد دارد.
موازنهی تفکیکپذیری (Resolution trade): ابعاد FFT بزرگتر یعنی تفکیکپذیری فرکانسی بهتر اما تفکیکپذیری زمانی ضعیفتر. ترکیب 25 ms پنجره و 10 ms گام، گزینهی پیشفرض در یادگیری ماشین صوت است؛ برای موسیقی 50 ms و 12.5 ms به کار میرود؛ برای تشخیص رخدادهای گذرا (transient) مانند ضربات درام یا صامتهای انفجاری، به سراغ 5 ms و 2 ms میروند.
پیادهسازی
مرحلهی 1: فریمبندی شکلموج
def frame(signal, frame_len, hop):
    n = 1 + (len(signal) - frame_len) // hop
    return [signal[i * hop : i * hop + frame_len] for i in range(n)]
یک قطعهی 10 ثانیهای با نرخ 16 kHz با پارامترهای frame_len=400, hop=160 تعداد 998 فریم تولید میکند.
مرحلهی 2: اعمال پنجرهی هان (Hann window)
import math

def hann(N):
    return [0.5 * (1 - math.cos(2 * math.pi * n / (N - 1))) for n in range(N)]
پیش از FFT، دادهها را نظیربهنظیر (element-wise) در تابع پنجره ضرب کنید. این کار نشتی طیفی (Spectral Leakage) ناشی از قطع ناگهانی سیگنال در نقاط انتهایی غیرصفر را از بین میبرد.
مرحلهی 3: محاسبهی بزرگی STFT
def stft_magnitude(signal, frame_len=400, hop=160):
    win = hann(frame_len)
    frames = frame(signal, frame_len, hop)
    return [magnitudes(dft([w * s for w, s in zip(win, f)])) for f in frames]
در محیط پروداکشن از torch.stft یا librosa.stft (مبتنی بر FFT و برداریشده) استفاده میشود. این حلقه در اینجا صرفاً جنبهی آموزشی دارد؛ این کد روی قطعات کوتاه در code/main.py اجرا میشود.
مرحلهی 4: ساخت بانک فیلتر مل
def hz_to_mel(f):
    return 2595.0 * math.log10(1.0 + f / 700.0)

def mel_to_hz(m):
    return 700.0 * (10 ** (m / 2595.0) - 1)

def mel_filterbank(n_mels, n_fft, sr, fmin=0, fmax=None):
    fmax = fmax or sr / 2
    mels = [hz_to_mel(fmin) + (hz_to_mel(fmax) - hz_to_mel(fmin)) * i / (n_mels + 1)
            for i in range(n_mels + 2)]
    hzs = [mel_to_hz(m) for m in mels]
    bins = [int(h * n_fft / sr) for h in hzs]
    fb = [[0.0] * (n_fft // 2 + 1) for _ in range(n_mels)]
    for m in range(n_mels):
        for k in range(bins[m], bins[m + 1]):
            fb[m][k] = (k - bins[m]) / max(1, bins[m + 1] - bins[m])
        for k in range(bins[m + 1], bins[m + 2]):
            fb[m][k] = (bins[m + 2] - k) / max(1, bins[m + 2] - bins[m + 1])
    return fb
تعداد 80 فیلتر مل روی بازهی 0 تا 8 kHz با n_fft=400 ماتریسی با ابعاد (80, 201) به شما میدهد. با ضرب ماتریس بزرگی STFT با ابعاد (n_frames, 201) در ترانهادهی (transpose) این ماتریس، مِلاسپکتوگرام (n_frames, 80) به دست میآید.
مرحلهی 5: محاسبهی لاگ-مل
def log_mel(mel_spec, eps=1e-10):
return [[math.log(max(v, eps)) for v in frame] for frame in mel_spec]جایگزینهای رایج: librosa.power_to_db (تبدیل به دسیبل با نرمالسازی بر اساس مرجع) یا 10 * log10(power + eps). مدل Whisper از روتین پیچیدهتری شامل برش دامنه (clip) و نرمالسازی بهره میبرد (کد log_mel_spectrogram در Whisper را ببینید).
مرحلهی 6: استخراج MFCCها
def dct_ii(x, n_coeffs):
    N = len(x)
    return [
        sum(x[n] * math.cos(math.pi * k * (2 * n + 1) / (2 * N)) for n in range(N))
        for k in range(n_coeffs)
    ]
روی هر فریم از لاگ-مل تبدیل DCT بزنید و 13 ضریب اول را نگه دارید؛ این همان ماتریس MFCC شماست. معمولاً اولین ضریب را کنار میگذارند (چون انرژی کلی سیگنال را کدگذاری میکند).
کاربرد در عمل
پشتهی فناوری در سال 2026:
| تسک | ویژگیها |
|---|---|
| ASR (مدلهای Whisper، Parakeet و SeamlessM4T) | 80 لاگ-مل، گام 10 ms، پنجرهی 25 ms |
| مدل آکوستیک TTS (مدلهای VITS، F5-TTS و Kokoro) | 80 مل، گام 5 تا 12 ms برای کنترل دقیقتر زمانی |
| دستهبندی صوتی (مدلهای AST، PANNs و BEATs) | 128 لاگ-مل، گام 10 ms |
| امبدینگ گوینده (مدلهای ECAPA-TDNN و WavLM) | 80 لاگ-مل یا یادگیری خودنظارتی (SSL) روی شکلموج خام |
| موسیقی (مدلهای MusicGen و Stable Audio 2) | توکنهای گسستهی EnCodec (نه مِلها) |
| تشخیص کلمهی کلیدی (Keyword spotting) | 40 ضریب MFCC برای دستگاههای بسیار کوچک |
یک قانون سرانگشتی: اگر روی موسیقی کار نمیکنید، کار را با 80 لاگ-مل شروع کنید. هرگونه انحراف از این قاعده نیاز به اثبات و توجیه دارد.
دامهایی که هنوز در سال 2026 به پروداکشن راه پیدا میکنند
- ناهمخوانی تعداد فیلترهای مل: آموزش با 80 مل و استنتاج با 128 مل؛ خطایی خاموش که همهچیز را به هم میریزد. ابعاد ویژگیها را در هر دو سمت لاگ بگیرید.
- ناهمخوانی نرخ نمونهبرداری در ورودی پایپلاین: مِلهای محاسبهشده در نرخ 22.05 kHz ساختار متفاوتی با 16 kHz دارند. نرخ نمونهبرداری را حتماً پیش از استخراج ویژگی (Feature Extraction) اصلاح کنید.
- تفاوت dB با log: مدل Whisper انتظار لاگ-مل دارد، نه dB-mel. برخی پایپلاینهای Hugging Face این موضوع را خودکار تشخیص میدهند؛ کد سفارشی شما این کار را نخواهد کرد.
- جابهجایی در نرمالسازی (Normalization drift): نرمالسازی به ازای هر پارهگفتار (utterance) هنگام آموزش، و نرمالسازی سراسری هنگام استنتاج؛ باگی در پروداکشن که نرخ خطای کلمات (WER) را دو برابر میکند.
- نشتی ناشی از حاشیهگذاری (Padding): پدینگ با صفر (Zero-padding) در انتهای صوت، یک طیف کاملاً تخت در فریمهای انتهایی ایجاد میکند. پدینگ را بهصورت متقارن یا با تکرار نمونهها (replicate) انجام دهید.
خروجی نهایی
خروجی را در مسیر outputs/skill-feature-extractor.md ذخیره کنید. این مهارت نوع ویژگی، تعداد فیلتر مل، اندازهی فریم/گام لغزش و روش نرمالسازی مناسب را متناسب با مدل هدف تعیین میکند.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. این کد یک سیگنال صوتی متغیر (chirp با فرکانس متغیر از 200 به 4000 Hz) تولید میکند و اندیس مل با بیشترین مقدار (argmax) را در هر فریم در خروجی مینویسد. در صورت تمایل نمودارش را رسم کنید و مطمئن شوید با تغییر فرکانس مطابقت دارد. - متوسط. اسکریپت را با مقادیر مختلف
n_melsدر بازهی{40, 80, 128}وframe_lenدر{200, 400, 800}دوباره اجرا کنید. پهنای باند قلههای تیز را در امتداد محور زمان اندازه بگیرید. کدام ترکیب این سیگنال چِرپ را بهتر تفکیک میکند؟ - سخت. تابع
power_to_dbرا پیادهسازی کنید و دقت بازشناسی یک دستهبند CNN کوچک را روی مجموعهدادهی AudioMNIST در سه حالت مقایسه کنید: (الف) لاگ-مل خام، (ب) dB-mel باref=max، و (ج) MFCC-13 همراه با مشتقات زمانی مرتبه اول و دوم (delta و delta-delta). دقت top-1 نهایی را گزارش دهید.
اصطلاحات کلیدی
| اصطلاح | در گفتار عامیانه | معنای دقیق فنی |
|---|---|---|
| فریم (Frame) | یک برش از صوت | قطعهای 25 ms از شکلموج که به عنوان ورودی به یک FFT داده میشود. |
| گام (Hop) | استراید (Stride) | تعداد نمونههای صوتی بین دو فریم متوالی؛ در ASR معمولاً 10 ms است. |
| پنجره (Window) | همان هان/همینگ | ضریبی نقطهبهنقطه که دامنهی لبههای فریم را به آرامی به صفر میل میدهد. |
| STFT | مولد طیفنگاشت | تبدیل فوریه روی فریمهای پنجرهگذاریشده؛ خروجی ماتریسی از جنس زمان × فرکانس است. |
| مل (Mel) | فرکانس دستکاریشده | مقیاس ادراک لگاریتمی فرکانس با رابطهی m = 2595·log10(1 + f/700). |
| بانک فیلتر (Filterbank) | ماتریس وزنها | مجموعهای از فیلترهای مثلثی که خروجی STFT را روی بینهای مل تصویر میکنند. |
| لاگ-مل (Log-mel) | ورودی Whisper | رابطهی log(mel_spec + eps)؛ ورودی استانداردشده تا سال 2026. |
| MFCC | ویژگیهای نسل قدیم | تبدیل DCT از لاگ-مل؛ شامل 13 ضریب نامرتبطشده (decorrelated). |
منابعی برای مطالعهی بیشتر
- Davis, Mermelstein (1980). Comparison of parametric representations for monosyllabic word recognition — مقالهی اصلی MFCC.
- Stevens, Volkmann, Newman (1937). A Scale for the Measurement of the Psychological Magnitude Pitch — مقالهی مرجع مقیاس مل.
- OpenAI — Whisper source, log_mel_spectrogram — پیادهسازی مرجع در کد منبع Whisper.
- مستندات استخراج ویژگی در librosa — مرجع توابع
mfcc،melspectrogramو تنظیمات پنجره/گام لغزش. - پیشپردازش صوت در NVIDIA NeMo — پایپلاین سطح پروداکشن برای مدلهای Parakeet و Canary.