
مدل Whisper در سالهای اخیر به استاندارد تبدیل گفتار به متن (ASR) تبدیل شده است، اما استفاده از آن در عمل با چالشهایی جدی مانند توهم روی سکوت، افت دقت روی واژگان تخصصی و مدیریت قطعات صوتی طولانی همراه است. شناخت سازوکار درونی مدل و روشهای سفارشیسازی آن، اولین قدم برای ساخت سیستمهای صوتی پایدار و بدون خطا است.
در این درس ساختار انکودر-دیکودر این مدل، فرمت پرامپتها و ساختار پنجرهی صوتی 30 ثانیهای را بررسی میکنیم. سپس روشهای حل این کاستیها را با ابزارهایی مثل WhisperX، faster-whisper و روش فاینتیونینگ کمهزینهی LoRA پیادهسازی خواهیم کرد تا بتوانید مدل را برای حوزههای واژگانی خاص و زبانهای دارای دادههای اندک بازآموزی کنید.
از آنجا که دانلود وزن مدلها از Hugging Face و نصب کتابخانههای صوتی از مخازن پایتون در ایران گاهی با کندی یا اختلال مواجه میشود، تنظیم آینههای معتبر دانلود و همچنین انتخاب مدلهای کمحجم مانند Turbo یا کوانتیزهسازی برای اجرای روان روی سیستمهای محلی بدون نیاز به منابع پردازشی گرانقیمت اهمیت بالایی دارد.
مدل Whisper یک انکودر-دیکودر ترنسفورمری (Transformer) با پنجرهی 30 ثانیهای است که روی 680 هزار ساعت جفت دادهی صوتی-متنی چندزبانه و با نظارت ضعیف (weakly-supervised) آموزش دیده است. یک معماری واحد، چندین وظیفه، و عملکردی پایدار در 99 زبان؛ مرجع تبدیل گفتار به متن (ASR) در سال 2026.
صورت مسئله
مدل Whisper که در سپتامبر 2022 توسط OpenAI منتشر شد، نخستین مدل ASR بود که در قالب یک ابزار مصرفی و دمدستی به بازار آمد: فایل صوتی را تحویل میدهید، متن میگیرید؛ پشتیبانی از 99 زبان، مقاومت عالی در برابر نویز و قابلیت اجرا روی لپتاپ. تا سال 2024، نسخههای Large-v3 و Turbo نیز عرضه شدند؛ و حالا در سال 2026، Whisper به بیسلاین پیشفرض همهی پروژهها تبدیل شده است؛ از تبدیل صوت پادکست به متن گرفته تا دستیارهای صوتی و زیرنویسهای یوتیوب.
اما نباید برای همیشه به Whisper مثل یک جعبهی سیاه نگاه کنید. تغییر دامنه یا شیفت دادهها (Domain shift) عملکرد آن را فلج میکند؛ اصطلاحات تخصصی، لهجههای مختلف، اسامی خاص، قطعات صوتی کوتاه و سکوتها همگی پاشنهی آشیل آن هستند. باید بدانید:
- ساختار داخلی آن واقعاً چگونه است.
- صوتهای قطعهبندیشده، استریمینگ یا طولانی را چطور باید بهدرستی به مدل داد.
- چه زمانی و چگونه مدل را فاینتیون کنید.
مفاهیم کلیدی
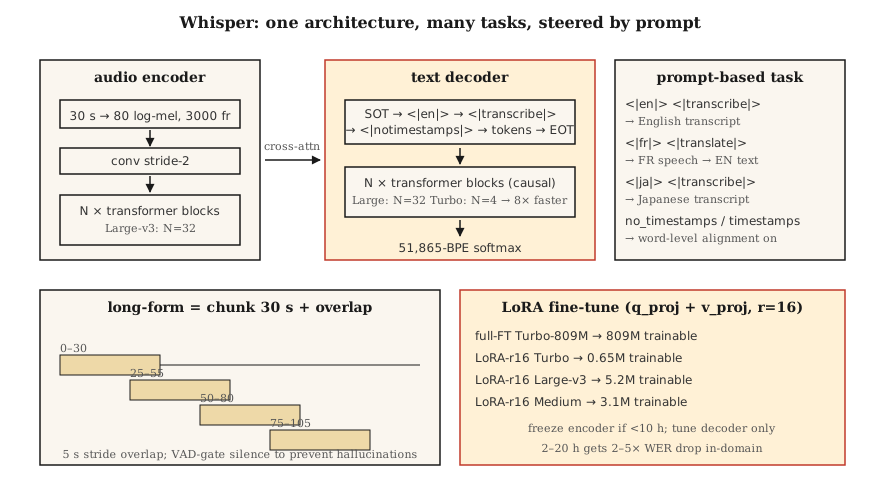
معماری. انکودر-دیکودر استاندارد ترنسفورمر.
- ورودی: اسپکتروگرام لگاریتمی مل (Log-mel spectrogram) به مدت 30 ثانیه، 80 فیلتر مل، با گام لغزش (Hop) 10 میلیثانیه $\leftarrow$ معادل 3000 فریم. قطعات کوتاهتر با صفر پدینگ (حاشیهگذاری) میشوند و قطعات طولانیتر، قطعهبندی (Chunking) میگردند.
- انکودر: کاهش ابعاد با کانولوشن (استراید 2) +
Nبلوک ترنسفورمر. در نسخهی Large-v3 شامل 32 لایه، بعد 1280 و 20 سرِ (Head) اتنشن است. - دیکودر:
Nبلوک ترنسفورمر با خوداتنشن علّی (Causal self-attention) + اتنشن متقاطع (Cross-attention) روی خروجی انکودر. ابعاد آن مشابه انکودر است. - خروجی: توکنهای BPE روی واژگانی با 51865 توکن.
مدل Large-v3 دارای 1.55 میلیارد پارامتر است. نسخهی Turbo با کاهش تعداد لایههای دیکودر از 32 به 4 لایه، تاخیر را تا 8 برابر کم میکند؛ در حالی که نرخ خطای کلمات (WER) آن کمتر از 1% بدتر میشود.
فرمت پرامپت. Whisper مدلی چندوظیفهای است که رفتار آن با توکنهای ویژه در پرامپت دیکودر کنترل میشود:
<|startoftranscript|><|en|><|transcribe|><|notimestamps|> Hello world.<|endoftext|><|en|>: برچسب زبان؛ زبانی که در فایل صوتی صحبت شده را مشخص میکند. اگر آن را حذف کنید، Whisper ابتدا خود زبان را تشخیص میدهد.<|transcribe|>یا<|translate|>: برچسب تسک؛ پیادهسازی متن گفتار به همان زبان مبدا، یا ترجمهی آن به متن انگلیسی.<|notimestamps|>: صرفنظر کردن از برچسبهای زمانی در سطح کلمه (اجرای سریعتر).
همین پرامپت است که به یک مدل امکان میدهد وظایف متعددی را انجام دهد. کافی است <|en|> را به <|fr|> تغییر دهید تا صوت را به فرانسوی پیاده کند.
پنجرهی 30 ثانیهای. همه چیز روی 30 ثانیه قفل شده است. فایلهای صوتی طولانیتر باید قطعهبندی شوند و قطعات کوتاهتر پدینگ میگیرند. پنجرهها ذاتاً از استریمینگ پشتیبانی نمیکنند؛ اصلاً به همین دلیل است که ابزارهایی مثل WhisperX، Whisper-Streaming و faster-whisper ساخته شدهاند.
نرمالسازی اسپکتروگرام لگاریتمی مل. با فرمول (log_mel - mean) / std انجام میشود که مقادیر آماری آن مستقیماً از دادههای آموزشی خود Whisper به دست آمده است. حتماً باید از پیشپردازش استاندارد Whisper یعنی whisper.audio.log_mel_spectrogram استفاده کنید، نه تابع librosa.feature.melspectrogram.
مدلهای مختلف در سال 2026
| نسخه | تعداد پارامترها | تاخیر (A100) | نرخ خطای کلمات WER (مجموعهی LibriSpeech-clean) |
|---|---|---|---|
| Tiny | 39M | 1× بلادرنگ | 5.4% |
| Base | 74M | 1× | 4.1% |
| Small | 244M | 1× | 3.0% |
| Medium | 769M | 1× | 2.7% |
| Large-v3 | 1.55B | 2× | 1.8% |
| Large-v3-turbo | 809M | 8× | 1.58% |
| Whisper-Streaming (2024) | 1.55B | استریمینگ | 2.0% |
فاینتیونینگ
پایپلاین استاندارد در سال 2026:
- جمعآوری 10 تا 100 ساعت صوت حوزهی هدف همراه با متنهای ترازشده (Aligned).
- اجرای
transformers.Seq2SeqTrainerبه همراه کالبکgenerate_with_loss. - فاینتیونینگ کارآمد پارامترها: اعمال LoRA روی لایههای اتنشنِ
q_proj،k_projوv_projحافظهی GPU را 4 برابر کاهش میدهد و هزینهی آن روی WER کمتر از 0.3 واحد است. - اگر کمتر از 10 ساعت داده دارید، انکودر را فریز کنید و فقط دیکودر را آموزش دهید.
- همیشه از توکنایزر و فرمت پرامپت اختصاصی خود Whisper استفاده کنید؛ هرگز توکنایزر را تغییر ندهید.
نتایج تجربی جامعهی کاربری: فاینتیونینگ مدل Medium روی 20 ساعت صوت در حوزهی پزشکی، WER اصطلاحات پزشکی را از 12% به 4.5% میرساند. فاینتیونینگ Turbo روی تنها 4 ساعت دادهی زبان ایسلندی، WER را از 18% به 6% کاهش میدهد.
پیادهسازی
گام 1: اجرای مستقیم مدل Whisper
import whisper
model = whisper.load_model("large-v3-turbo")
result = model.transcribe(
    "clip.wav",
    language="en",
    task="transcribe",
    temperature=0.0,
    condition_on_previous_text=False,  # prevents runaway repetition
)
print(result["text"])
for seg in result["segments"]:
    print(f"[{seg['start']:.2f}–{seg['end']:.2f}] {seg['text']}")
تنظیمات پیشفرضی که همیشه باید مقدار آنها را بازنویسی کنید: temperature=0.0 (نمونهبرداری پیشفرض زنجیرهای از مقادیر 0.0 $\leftarrow$ 0.2 $\leftarrow$ 0.4 و... برای خطاپوشی دارد)، condition_on_previous_text=False (برای جلوگیری از توهم آبشاری) و no_speech_threshold=0.6 (برای تشخیص سکوت).
گام 2: قطعهبندی فایلهای صوتی طولانی
# کتابخانه whisperx مرجع سال 2026 برای فایلهای طولانی همراه با برچسبهای زمانی در سطح کلمه است
import whisperx
model = whisperx.load_model("large-v3-turbo", device="cuda", compute_type="float16")
segments = model.transcribe("1hour.mp3", batch_size=16, chunk_size=30)کتابخانهی WhisperX سه قابلیت به آن اضافه میکند: (1) تشخیص فعالیت صوتی (VAD) با مدل Silero، (2) تراز زمانی کلمات بهکمک wav2vec 2.0، (3) تفکیک گویندگان (Diarization) با pyannote.audio. این ابزار، هستهی اصلی تبدیل گفتار به متن در محیطهای عملیاتی سال 2026 است.
گام 3: فاینتیونینگ با LoRA
from transformers import WhisperForConditionalGeneration, WhisperProcessor
from peft import LoraConfig, get_peft_model

model = WhisperForConditionalGeneration.from_pretrained("openai/whisper-large-v3-turbo")
lora = LoraConfig(
    r=16, lora_alpha=32, target_modules=["q_proj", "v_proj"],
    lora_dropout=0.1, bias="none", task_type="SEQ_2_SEQ_LM",
)
model = get_peft_model(model, lora)
# model.print_trainable_parameters()  -> ~3M trainable / 809M total
سپس حلقهی استاندارد Trainer اجرا میشود. هر 1000 گام یک چکپوینت ذخیره کنید و کیفیت را با معیار WER روی دادههای جداگانهی تست (Held-out) بسنجید.
گام 4: بررسی روند یادگیری لایهها
# وزنهای کراساتنشن را در طول دیکود استخراج کنید تا ببینید دیکودر به چه چیزی توجه میکند.
with torch.inference_mode():
out = model.generate(
input_features=features,
return_dict_in_generate=True,
output_attentions=True,
)
# out.cross_attentions: layer × head × step × src_lenماتریس را با نمودار حرارتی (Heatmap) نمایش دهید؛ یک همترازی قطری واضح میبینید که نشان میدهد گامهای دیکودر چگونه فریمهای انکودر را اسکن میکنند. همین قطر در واقع درک Whisper از برچسبهای زمانی کلمات است.
استفادهی کاربردی
استک پیشنهادی در سال 2026:
| سناریو | انتخاب مناسب |
|---|---|
| انگلیسی عمومی، آفلاین | مدل Large-v3-turbo از طریق whisperx |
| موبایل / پردازش لبه (Edge) | نسخهی کوانتیزهشدهی Whisper-Tiny (با فرمت int8) یا Moonshine |
| صوتهای طولانی چندزبانه | مدل Large-v3 از طریق whisperx + تفکیک گویندگان |
| زبانهای کممنبع (Low-resource) | فاینتیونینگ Medium یا Turbo با LoRA |
| استریمینگ (با تاخیر 2 ثانیه) | Whisper-Streaming یا Parakeet-TDT |
| برچسبهای زمانی در سطح کلمه | کتابخانهی WhisperX (تراز اجباری با wav2vec 2.0) |
کتابخانهی faster-whisper (مبتنی بر بکاند CTranslate2) سریعترین محیط اجرا برای استنتاج روی CPU و GPU در سال 2026 است؛ دقیقاً همان خروجی نسخهی اصلی را میدهد اما 4 برابر سریعتر.
چالشهایی که هنوز هم در سال 2026 وجود دارند
- تولید توهمآمیز متن روی سکوت. از آنجا که دادههای آموزشی Whisper شامل زیرنویسها بودهاند، مدل روی سکوت عباراتی مثل "!Thanks for watching"، "!Subscribe" یا متن آهنگ تولید میکند. همیشه قبل از فراخوانی مدل، صوت را از فیلتر VAD عبور دهید.
- توهم زنجیرهای با
condition_on_previous_text. بروز یک توهم، پنجرههای صوتی بعدی را هم آلوده میکند. این پارامتر راFalseبگذارید، مگر اینکه حفظ پیوستگی بین قطعات برایتان حیاتی باشد. - پدینگ فایلهای صوتی کوتاه. وقتی یک قطعهی 2 ثانیهای با پدینگ به 30 ثانیه میرسد، ممکن است در سکوت انتهای آن توهم رخ دهد. از
pad=Falseاستفاده کنید یا صوت را به VAD بسپارید. - استفاده از مقادیر آماری نادرست اسپکتروگرام مل. اگر بهجای مشخصههای استاندارد Whisper از کتابخانهی librosa استفاده کنید، خروجیهای مدل تقریباً تصادفی خواهند بود. همیشه از
whisper.audio.log_mel_spectrogramاستفاده کنید.
تحویل نهایی
خروجی کار را در فایل outputs/skill-whisper-tuner.md ذخیره کنید. یک پایپلاین فاینتیونینگ یا استنتاج برای Whisper در حوزهی تخصصی انتخابی خود بسازید.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. این کد یک پرامپت استاندارد Whisper را توکنایز میکند، ابعاد دیکودشده را محاسبه مینماید و جدول زمانبندی قطعهبندی یک صوت 10 دقیقهای را چاپ میکند. - متوسط. کتابخانهی
faster-whisperرا نصب کنید، یک پادکست 10 دقیقهای را پیاده نمایید و نرخ خطای کلمات (WER) آن را در مقایسه با متن پیادهشده توسط انسان بسنجید. تفاوت حالتlanguage="auto"را با حالت اجباریlanguage="en"مقایسه کنید. - سخت. با استفاده از کتابخانهی
datasetsدر Hugging Face، زبانی را انتخاب کنید که Whisper روی آن عملکرد ضعیفتری دارد (مانند اردو). سپس مدل Medium را با روش LoRA بهمدت 2 دوره (Epoch) روی 2 ساعت صوت فاینتیون کنید و تغییرات WER را گزارش دهید.
اصطلاحات کلیدی
| اصطلاح | اصطلاح رایج بین افراد | معنای دقیق فنی |
|---|---|---|
| پنجرهی 30 ثانیهای (30-sec window) | محدودیت Whisper | سقف ثابت ورودی مدل؛ صوتهای طولانیتر باید قطعهبندی شوند. |
| SOT | شروع پیادهسازی متن | توکن `< |
| توکن برچسب زمانی (Timestamps token) | تراز زمانی | هر بازهی 0.02 ثانیهای یک توکن ویژه در واژگان 51 هزارتایی مدل است. |
| Turbo | نسخهی سریع | دیکودر 4 لایهای، 8 برابر سریعتر، با افت کیفیتی کمتر از 1% در WER. |
| WhisperX | رپر پردازش صوت طولانی | ترکیب VAD + مدل Whisper + تراز زمانی wav2vec + تفکیک گویندگان. |
| فاینتیونینگ با LoRA (LoRA fine-tune) | آموزش بهینهی مدل | افزودن آداپتورهای کمرتبه به لایههای اتنشن؛ آموزش تنها حدود 0.3% از کل پارامترها. |
| توهم (Hallucination) | خطای بیصدای مدل | تولید متن انگلیسی روان توسط Whisper بر اساس نویز تصادفی یا سکوت محض. |
برای مطالعهی بیشتر
- Radford et al. (2022). Whisper paper — تشریح معماری اصلی و روش آموزش مدل.
- OpenAI (2024). Whisper Large-v3-turbo release — دیکودر 4 لایهای و افزایش 8 برابری سرعت.
- Bain et al. (2023). WhisperX — پردازش صوتهای طولانی، تراز زمانی کلمات و تفکیک گویندگان.
- Systran — faster-whisper repo — پیادهسازی مبتنی بر CTranslate2 با سرعت 4 برابری.
- HuggingFace — Whisper fine-tune tutorial — آموزش گامبهگام و استاندارد فاینتیونینگ کامل و روش LoRA.