
مدلی که نتوانید عملکردش را با متر و معیار دقیق بسنجید، آمادهی استقرار در محیط عملیاتی نیست. یکی از چالشهای رایج مهندسان هنگام پیادهسازی سیستمهای صوتی این است که مدلی در مرحلهی آزمایش بینقص به نظر میرسد، اما پس از استقرار به دلیل استفاده از معیارهای نادرست عملکردی ضعیف نشان میدهد.
در این درس معیارهای استاندارد ارزیابی مدلهای صوتی را برای تسکهای گوناگون یاد میگیرید؛ از نرخ خطای کلمه (WER) در بازشناسی گفتار و نمرهی میانگین نظرات (MOS و UTMOS) در تبدیل متن به گفتار گرفته تا سنجههای تخصصی شبیهسازی صدا، تفکیک گویندگان و تولید موسیقی.
برای اجرای تستها و دریافت مدلهای ارزیابی متنباز نیازی به زیرساختهای پرهزینه ندارید؛ این ارزیابیها روی سیستمهای شخصی نیز قابل اجرا هستند، هرچند هنگام دانلود وزنها یا مخازن از پلتفرمهایی مثل Hugging Face ممکن است با کندی یا اختلال دسترسی مواجه شوید که با تنظیم ابزارهای دانلود قابل مدیریت است.
چیزی را که نتوانید بسنجید، نمیتوانید منتشر کنید. در این درس معیارهای سال 2026 را برای تکتک تسکهای صوتی معرفی میکنیم: بازشناسی خودکار گفتار یا ASR (شامل WER، CER و RTFx)، تبدیل متن به گفتار یا TTS (شامل MOS، UTMOS، SECS و WER-on-ASR-round-trip)، مدلهای زبانی-صوتی (MMAU و LongAudioBench)، موسیقی (FAD و CLAP) و گوینده (EER)؛ بهعلاوهی لیدربوردهای مرجعی که مدلها را در آنها مقایسه میکنید.
صورت مسئله
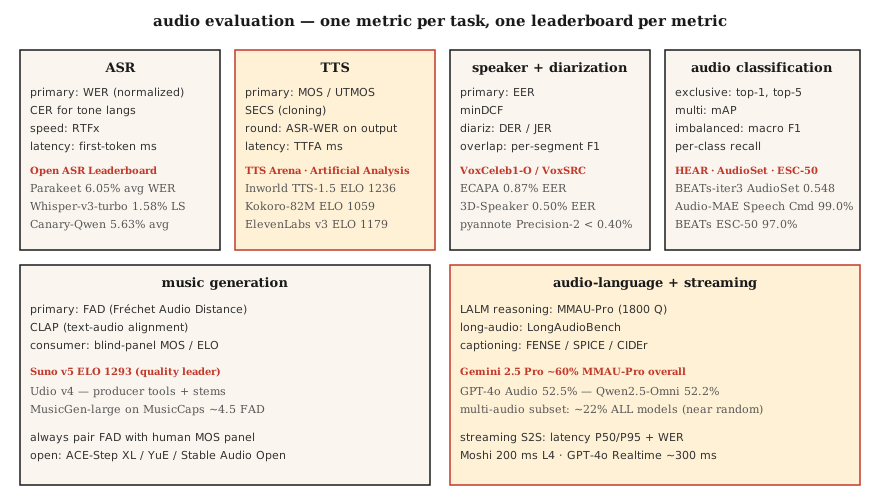
هر تسک صوتی چندین معیار ارزیابی دارد که هرکدام بُعد متفاوتی را میسنجند. استفاده از معیار اشتباه باعث میشود مدلی تحویل دهید که در داشبورد عالی به نظر میرسد، اما در محیط پروداکشن عملکردی فاجعهبار دارد. فهرست استاندارد معیارهای سال 2026:
| تسک | معیار اصلی | معیارهای ثانویه |
|---|---|---|
| ASR | WER | CER · RTFx · تاخیر اولین توکن |
| TTS | MOS / UTMOS | SECS · WER-on-ASR-round-trip · CER · TTFA |
| شبیهسازی صدا | SECS (شباهت کسینوسی ECAPA) | MOS · CER |
| تایید هویت گوینده | EER | minDCF · FAR / FRR در نقطهی کاری |
| تفکیک گویندگان (Diarization) | DER | JER · خلط گوینده (Speaker confusion) |
| دستهبندی صوتی | top-1 · mAP | F1 ماکرو · بازخوانی به ازای هر کلاس |
| تولید موسیقی | FAD | CLAP · پنل شنوندگان MOS |
| مدل زبانی-صوتی | MMAU-Pro | LongAudioBench · AudioCaps FENSE |
| گفتاربهگفتار استریمینگ | تاخیر P50/P95 | WER · MOS |
مفاهیم پایه
معیارهای ASR
معیار WER (نرخ خطای کلمه یا Word Error Rate). فرمول: (S + D + I) / N. قبل از امتیازدهی، متن را به حروف کوچک تبدیل کنید، نشانهگذاریها را بردارید و اعداد را به حروف بنویسید (نرمالسازی). برای این کار از jiwer یا whisper_normalizer محصول OpenAI استفاده کنید. خطای کمتر از 5% معادل دقت خواندنِ انسان (Human-parity) در نظر گرفته میشود.
معیار CER (نرخ خطای نویسه یا Character Error Rate). همان فرمول بالا اما در سطح کاراکتر. برای زبانهای نواختبر (ماندارین و کانتونی) که بخشبندی کلمات در آنها مبهم است، استفاده میشود.
معیار RTFx (ضریب معکوس زمان واقعی یا Inverse Real-Time Factor). ثانیههای پردازششده از فایل صوتی به ازای هر ثانیهی زمان واقعی (Wall-clock). هرچه بالاتر باشد بهتر است. Parakeet-TDT به نرخ 3380× میرسد، در حالی که Whisper-large-v3 حدود 30× است.
تاخیر اولین توکن (First-token latency). زمان سپریشده از ورودی صدا تا تولید اولین توکن متن خروجی. این معیار برای استریمینگ حیاتی است. این تاخیر در Deepgram Nova-3 حدود 150 میلیثانیه است.
معیارهای TTS
معیار MOS (میانگین نمرات نظرخواهی یا Mean Opinion Score). امتیازدهی انسانی بین 1 تا 5. استاندارد طلایی است اما ارزیابی آن زمان زیادی میبرد. برای هر نمونه حداقل به 20 شنونده و برای هر مدل به بیش از 100 نمونه نیاز دارید.
معیار UTMOS (سالهای 2022 تا 2026). پیشبینیکنندهی آموزشدیدهی MOS. همبستگی این سنجه با MOS انسانی روی بنچمارکهای استاندارد حدود 0.9 است. مدل F5-TTS امتیاز UTMOS معادل 3.95 میگیرد؛ در حالی که دادهی واقعی (Ground truth) امتیاز 4.08 دارد.
معیار SECS (شباهت کسینوسی اینکودر گوینده یا Speaker Encoder Cosine Similarity). برای شبیهسازی صدا. شباهت کسینوسی امبدینگ ECAPA بین صوت مرجع و خروجی کلونشده. مقدار بالاتر از 0.75 یعنی صدای کلونشده قابل تشخیص است.
معیار WER-on-ASR-round-trip. خروجی TTS را به Whisper میدهید و مقدار WER آن را نسبت به متن ورودی اولیه میسنجید. این روش افت وضوح گفتار را سریع آشکار میکند. مدلهای پیشرو (SOTA) سال 2026 خطای WER کمتر از 2% روی دیتاستهای تست انگلیسی ثبت میکنند (برای زبان ماندارین به جای آن CER گزارش میشود).
معیار TTFA (زمان تا اولین صوت یا Time-To-First-Audio). تاخیر زمانی تا رسیدن اولین قطعه صوت. این زمان برای Kokoro-82M حدود 100 میلیثانیه و برای F5-TTS حدود 1 ثانیه است.
معیارهای اختصاصی شبیهسازی صدا
سهگانهی SECS + MOS + CER. اگر شبیهسازی صدایی امتیاز SECS بالا ولی MOS پایینی داشته باشد، یعنی طنین صدا درست شبیهسازی شده ولی لحن آن غیرطبیعی است؛ برعکس آن یعنی صدایی کاملاً طبیعی دارید که متعلق به گویندهی مدنظر نیست.
تایید هویت گوینده
معیار EER (نرخ خطای برابر یا Equal Error Rate). آستانهای که در آن نرخ پذیرش نادرست (False Accept Rate) با نرخ رد نادرست (False Reject Rate) برابر میشود. مدل ECAPA روی بنچمارک VoxCeleb1-O به خطای 0.87% میرسد.
معیار minDCF (حداقل هزینهی تشخیص یا min Detection Cost). هزینهی وزندار در یک نقطهی کاری مشخص (معمولاً FAR=0.01). این معیار نسبت به EER تطابق بیشتری با نیازهای عملیاتی پروداکشن دارد.
تفکیک گویندگان (Diarization)
معیار DER (نرخ خطای تفکیک گویندگان یا Diarization Error Rate). فرمول: (FA + Miss + Confusion) / total_speaker_time. گفتار تشخیصدادهنشده (Missed) + تشخیص اشتباه گفتار (False-alarm) + خلط گوینده (Speaker confusion)، که هرکدام به صورت کسری محاسبه میشوند. در جلسات دیتاست AMI، خطای DER حدود 10 تا 20 درصد واقعبینانه است. ترکیب pyannote 3.1 تجاری با Precision-2 روی فایلهای باکیفیت به خطای DER کمتر از 10% میرسد.
معیار JER (نرخ خطای ژاکارد یا Jaccard Error Rate). جایگزینی برای DER که در برابر خطای ناشی از قطعههای کوتاه مقاومت بیشتری دارد.
دستهبندی صوتی
چندبرچسبی (Multi-label): معیار mAP (میانگین دقت میانگین) روی تمام کلاسها. AudioSet: مقدار 0.548 برای BEATs-iter3.
چندکلاسهی ناسازگار (Multi-class exclusive): دقتهای top-1 و top-5. در Speech Commands v2 مدل Audio-MAE به دقت 99.0% در top-1 میرسد.
نامتوازن: F1 ماکرو + بازخوانی به ازای هر کلاس. همیشه نتایج را به تفکیک کلاس گزارش کنید؛ میانگین دقت کل، کلاسهایی را که مدل در آنها ناموفق بوده پنهان میکند.
تولید موسیقی
معیار FAD (فاصلهی صوتی فرشه یا Fréchet Audio Distance). فاصلهی بین توزیع امبدینگهای VGGish دیتای صوتی واقعی و تولیدشده. نمرهی MusicGen-small روی MusicCaps برابر با 4.5 و MusicLM برابر با 4.0 است. هرچه این عدد کمتر باشد بهتر است.
امتیاز CLAP (یا CLAP Score). امتیاز همترازی متن و صوت با استفاده از امبدینگهای CLAP. مقدار بالاتر از 0.3 نشاندهندهی همترازی قابل قبول است.
پنل شنوندگان MOS. برای موسیقی کاربردی و نهایی، همچنان حرف اول و آخر را میزند. مدل Suno v5 در بنچمارک مقایسهی زوجی خودِ شرکت Suno امتیاز ELO معادل 1293 را گرفت. البته این عدد رسمی شرکت سازنده است؛ توجه داشته باشید که TTS Arena گفتار را رتبه میدهد، نه موسیقی.
بنچمارکهای مدل زبانی-صوتی
معیار MMAU (درک کلان چندصوتی یا Massive Multi-Audio Understanding). شامل 10 هزار جفت پرسش و پاسخ صوتی.
معیار MMAU-Pro. شامل 1800 آیتم دشوار در چهار دستهبندی: گفتار، صدا، موسیقی و صوت چندگانه. شانس تصادفی در سوالات چهارگزینهای آن 25% است. Gemini 2.5 Pro به امتیاز کلی حدود 60% میرسد، در حالی که در بخش صوت چندگانه عملکرد تمام مدلها حدود 22% است.
معیار LongAudioBench. کلیپهای چنددقیقهای با پرسشهای معنایی. مدل Audio Flamingo Next در این بنچمارک Gemini 2.5 Pro را شکست میدهد.
دیتاستهای AudioCaps و Clotho. بنچمارکهای توصیفنویسی برای صوت با معیارهای SPICE، CIDEr و FENSE.
گفتاربهگفتار استریمینگ
تاخیر P50 / P95 / P99. زمان سپریشده از لحظهی پایان صحبت کاربر تا رسیدن اولین صدای خروجی. در Moshi این زمان 200 میلیثانیه و در GPT-4o Realtime حدود 300 میلیثانیه است.
معیارهای WER و MOS روی خروجی مدل.
پاسخدهی به قطع صحبت (Barge-in responsiveness). فاصلهی زمانی بین قطع صحبت توسط کاربر تا بیصدا شدن دستیار. مقدار هدف کمتر از 150 میلیثانیه است.
لیدربوردهای سال 2026
| لیدربورد | شاخهها | آدرس وبسایت |
|---|---|---|
| Open ASR Leaderboard (HF) | انگلیسی + چندزبانه + صوتهای طولانی | huggingface.co/spaces/hf-audio/open_asr_leaderboard |
| TTS Arena (HF) | تبدیل متن به گفتار انگلیسی | huggingface.co/spaces/TTS-AGI/TTS-Arena |
| Artificial Analysis Speech | تبدیل گفتار به متن و بالعکس، ELO از روی آرای زوجی | artificialanalysis.ai/speech |
| MMAU-Pro | استدلال LALM | sonalkum.github.io/mmau-pro |
| SpeakerBench / VoxSRC | بازشناسی گوینده | voxsrc.github.io |
| زیرمجموعه موسیقی MMAU | مدلهای LALM در حوزهی موسیقی | (داخل بنچمارک MMAU) |
| بنچمارک HEAR | یادگیری خودنظارتی صوت | hearbenchmark.com |
پیادهسازی گامبهگام
مرحلهی 1: محاسبهی WER بههمراه نرمالسازی
from jiwer import wer, Compose, ToLowerCase, RemovePunctuation, Strip

transform = Compose([ToLowerCase(), RemovePunctuation(), Strip()])
score = wer(
    truth="Please turn on the lights.",
    hypothesis="please turn on the light",
    truth_transform=transform,
    hypothesis_transform=transform,
)
# ~0.17مرحلهی 2: سنجش رفتوبرگشت WER در مدل TTS
def ttr_wer(tts_model, asr_model, texts):
    errors = []
    for txt in texts:
        audio = tts_model.synthesize(txt)
        recog = asr_model.transcribe(audio)
        errors.append(wer(truth=txt, hypothesis=recog))
return sum(errors) / len(errors)مرحلهی 3: محاسبهی SECS برای شبیهسازی صدا
from speechbrain.inference.speaker import EncoderClassifier
sv = EncoderClassifier.from_hparams("speechbrain/spkrec-ecapa-voxceleb")

emb_ref = sv.encode_batch(load_wav("reference.wav"))
emb_clone = sv.encode_batch(load_wav("cloned.wav"))
secs = torch.nn.functional.cosine_similarity(emb_ref, emb_clone, dim=-1).item()مرحلهی 4: محاسبهی FAD برای مدلهای تولید موسیقی
from frechet_audio_distance import FrechetAudioDistance
fad = FrechetAudioDistance()
score = fad.get_fad_score("generated_folder/", "reference_folder/")مرحلهی 5: محاسبهی EER برای تایید هویت گوینده (کد مشابه درس 6)
def eer(same_scores, diff_scores):
    thresholds = sorted(set(same_scores + diff_scores))
    best = (1.0, 0.0)
    for t in thresholds:
        far = sum(1 for s in diff_scores if s >= t) / len(diff_scores)
        frr = sum(1 for s in same_scores if s < t) / len(same_scores)
        if abs(far - frr) < best[0]:
            best = (abs(far - frr), (far + frr) / 2)
return best[1]نحوهی استفاده در عمل
در کنار هر استقرار مدل، یک بستر ارزیابی ثابت قرار دهید که با هر بار بهروزرسانی مدل اجرا شود. این سه قاعدهی طلایی را همیشه رعایت کنید:
- قبل از امتیازدهی نرمالسازی کنید. متن را به حروف کوچک تبدیل کنید، نشانهگذاریها را بردارید و اعداد را به حروف باز کنید. همیشه قاعدهی نرمالسازی خود را در گزارش بنویسید.
- توزیع آماری را گزارش کنید، نه صرفاً میانگین را. برای تاخیر، صدکهای P50/P95/P99 را گزارش دهید. در دستهبندی از بازخوانی تفکیکشده به ازای هر کلاس و در MMAU از نمرات هر دستهبندی استفاده کنید.
- یک بنچمارک عمومی و معتبر اجرا کنید. حتی اگر دادههای پروداکشن شما متفاوت است، ارائهی نتایج روی بنچمارکهایی مانند Open ASR، TTS Arena یا MMAU به دیگران اجازه میدهد مقایسهای همسنگ و عادلانه انجام دهند.
خطاهای رایج
- تعمیم نامعتبر UTMOS. این معیار روی گفتار شفاف و بدون نویزِ دیتاستهایی مثل VCTK آموزش دیده است؛ بنابراین به صداهای نویزدار، شبیهسازیشده یا احساسی نمرات غیردقیقی میدهد.
- سوگیری پنل ارزیابی MOS. نظر 20 کاربر در Mechanical Turk آمازون معادل 20 کاربر نهایی شما نیست. اگر پروژه حساس است، هزینهی تشکیل یک پنل ارزیابی تخصصی را پرداخت کنید.
- وابستگی FAD به مجموعهی مرجع. هنگام مقایسهی مدلهای مختلف، آنها را حتماً با یک توزیع مرجع یکسان بسنجید.
- تکیه به WER تجمیعی. خطای کل 5% ممکن است خطای فاحش 30% را روی گویندگان با لهجههای خاص پنهان کند. دادهها را بر اساس گروههای جمعیتی مختلف تفکیک و ارزیابی کنید.
- اشباع بنچمارکهای عمومی. بیشتر مدلهای پیشرو به سقف امتیازی بنچمارکهای استاندارد رسیدهاند. همیشه یک مجموعهی آزمون داخلی و اختصاصی نگهدارید که بار ترافیک واقعی شما را منعکس کند.
خروجی نهایی
این مستندات را در مسیر outputs/skill-audio-evaluator.md ذخیره کنید. معیارها، بنچمارکها و قالب گزارشدهی را متناسب با مدل صوتی مدنظر خود انتخاب نمایید.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. معیارهای WER، CER، EER، SECS و نسخههای سادهسازیشدهی FAD و MMAU را روی ورودیهای نمونه به دست آورید. - متوسط. یک بستر سنجش رفتوبرگشت WER برای TTS بسازید. خروجی Kokoro یا F5-TTS را وارد Whisper کنید. میزان WER را روی 50 پرامپت بسنجید و پرامپتهایی را که WER بالای 10% دارند مشخص کنید.
- سخت. مدل LALM انتخابی خود در درس 10 را روی زیرمجموعههای گفتار و صوت چندگانهی بنچمارک MMAU-Pro (هرکدام 50 آیتم) ارزیابی کنید. دقت مدل را به تفکیک هر دسته گزارش دهید و با آمار منتشرشده مقایسه نمایید.
اصطلاحات کلیدی
| اصطلاح | اصطلاح رایج | معنای دقیق فنی |
|---|---|---|
| WER | امتیاز ASR | فرمول (S+D+I)/N در سطح کلمه پس از نرمالسازی متن. |
| CER | خطای کلمه در سطح کاراکتر | برای زبانهای نواختبر یا سیستمهای کاراکترمحور. |
| MOS | نظر انسانی | امتیاز 1 تا 5؛ ارزیابی بیش از 20 شنونده روی 100 نمونه صوت. |
| UTMOS | پیشبینیکنندهی ماشینی MOS | مدل یادگیریماشینی؛ همبستگی حدود 0.9 با MOS انسانی. |
| SECS | شباهت صدای شبیهسازیشده | شباهت کسینوسی امبدینگهای ECAPA بین صدای مرجع و کلون. |
| EER | امتیاز تایید هویت گوینده | نقطهی آستانهای که در آن FAR با FRR برابر است. |
| DER | امتیاز تفکیک گویندگان | حاصل تقسیم (FA + Miss + Confusion) بر زمان کل گفتار. |
| FAD | کیفیت تولید موسیقی | فاصلهی فرشه بر پایهی امبدینگهای مدل VGGish. |
| RTFx | نرخ پردازش | ثانیههای صوت پردازششده به ازای هر ثانیهی زمان واقعی. |
برای مطالعهی بیشتر
- کتابخانهی jiwer — ابزاری برای محاسبهی WER/CER بههمراه توابع نرمالسازی متن.
- مقالهی UTMOS (سائکی و همکاران، 2022) — مدل یادگیریماشینی پیشبینیکنندهی MOS.
- مقالهی Fréchet Audio Distance (کیلگور و همکاران، 2019) — استاندارد ارزیابی مدلهای تولید موسیقی.
- لیدربورد Open ASR — رتبهبندیهای زنده و بهروز در سال 2026.
- پلتفرم TTS Arena — لیدربورد ارزیابی مدلهای TTS بر پایهی آرای انسانی.
- بنچمارک MMAU-Pro — لیدربورد ارزیابی توان استدلال مدلهای صوتی-زبانی بزرگ.
- بنچمارک HEAR — مرجع ارزیابی مدلهای یادگیری خودنظارتی روی صوت.