
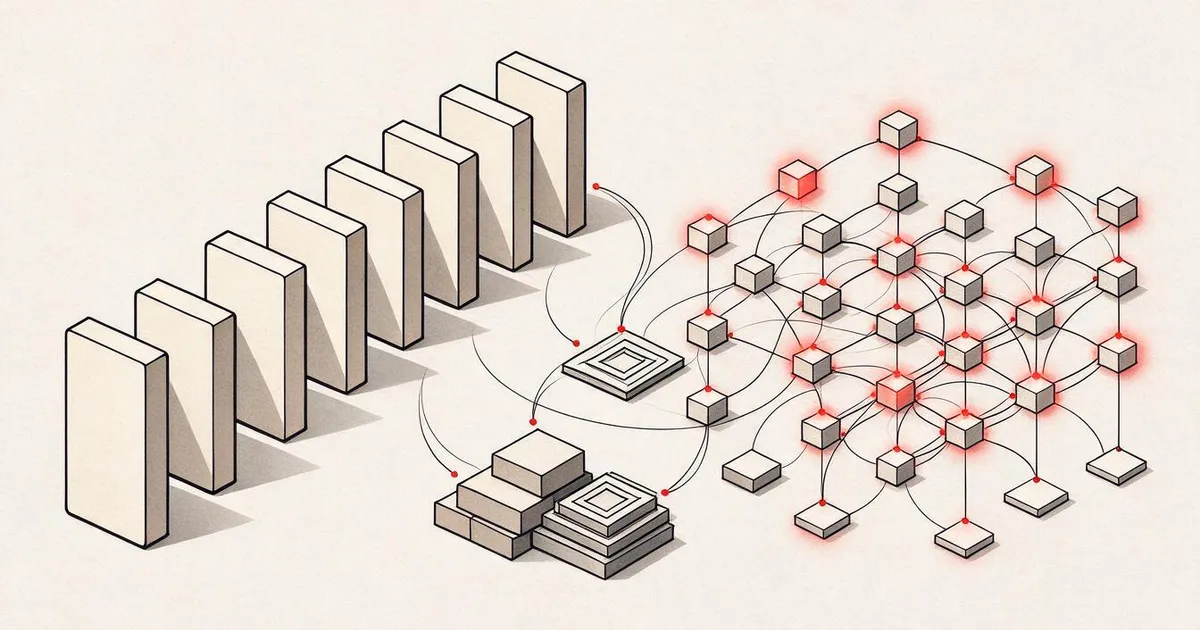
اگر کار با مدلهای زبانی بزرگ یا یادگیری عمیق را آغاز کرده باشید، احتمالاً بارها شنیدهاید که ترنسفورمرها دنیای هوش مصنوعی را بازتعریف کردهاند. اما درک فنی اینکه چرا شبکههای عصبی بازگشتی (RNN) با وجود سالها برتری مطلق کنار رفتند، پایهی فهم معماری مدلهای امروزی است. مسئلهی اصلی تنها دقت خروجی نبود، بلکه معماری ترتیبی این شبکهها با سختافزارهای مدرن ناسازگار بود.
در شبکههای بازگشتی، پردازش هر توکن به توکن قبلی وابسته است؛ وضعیتی که مانع از موازیسازی محاسبات روی پردازندههای گرافیکی میشود. در مقابل، مکانیزم خوداتنشن (Self-Attention) امکان پردازش همزمان تمامی توکنها را فراهم میکند و زمان آموزش مدل را از یک زنجیرهی طولانی متوالی به ضربهای ماتریسی بزرگ و بهینه تبدیل میسازد.
کدها و پیادهسازیهای این درس ماهیت شبیهسازی عددی دارند و روی پردازندهی استاندارد (CPU) هر سیستمی بهسادگی اجرا میشوند؛ بنابراین برای درک تفاوت عمق محاسباتی و مقیاسپذیری الگوریتمها نیازی به زیرساختهای ابری یا کارتهای گرافیکی سنگین نخواهید داشت.
مدلهای RNN توکنها را یکییکی پردازش میکنند. ترنسفورمرها همهی توکنها را یکجا پردازش میکنند. همین یک انتخاب در طراحی معماری، تمام منحنیهای مقیاسپذیری یادگیری عمیق (deep learning) را پس از سال 2017 دگرگون کرد.
صورت مسئله
پیش از سال 2017، تمام مدلهای پیشرفتهی توالی در دنیا — چه در پردازش زبان و ترجمه و چه در صوت — شبکههای عصبی بازگشتی (RNN) بودند. مدلهای LSTM و GRU به مدت نیمدهه صدرنشین بنچمارکهای ترجمه بودند؛ بنچمارکهایی که همتراز ImageNet به شمار میرفتند. آنها تنها ابزاری بودند که پژوهشگران در اختیار داشتند.
اما این مدلها سه نقطهضعف مرگبار داشتند:
محاسبات ترتیبی به این معنا بود که نمیشد کار را روی محور زمان موازی کرد؛ توکن t+1 به وضعیت پنهان (hidden state) توکن t نیاز دارد. یک توالی 1024 توکنی یعنی 1024 گام پشت سر هم روی GPU؛ پردازندهای که میتواند در هر چرخه 1000000 عملیات ممیز شناور انجام دهد. در نتیجه روی سختافزاری که اساساً برای موازیسازی ساخته شده بود، زمان واقعی آموزش (wall-clock time) بهشکل خطی با طول توالی بالا میرفت.
محو شدگی گرادیان (vanishing gradient) یعنی اطلاعات 50 توکن عقبتر، عملاً از دل 50 تابع غیرخطی فشرده و محو میشد. واحدهای بازگشتی گیتدار (مثل LSTM و GRU) این خرد شدن اطلاعات را ملایمتر کردند، اما هرگز از بین نبردند. در نتیجه، مدلها در درک وابستگیهای دوربرد — مثلاً در جملهی «کتابی که تابستان پارسال در هواپیما در مسیر کیوتو خواندم، ... بود» — مدام به بنبست میخوردند.
وضعیت پنهان با طول ثابت یعنی انکودر مجبور بود کل توالی مبدأ را، پیش از آنکه دیکودر چیزی ببیند، در یک بردار منفرد بچپاند. فرقی نداشت ورودی 5 توکن باشد یا 500 توکن؛ گلوگاه در هر حال اندازهی ثابتی داشت.
مقالهی سال 2017 با عنوان «Attention Is All You Need» دست به اقدامی رادیکال زد: بازگشت را بهکل کنار بگذارید. بگذارید هر جایگاه همزمان به تمام جایگاههای دیگر اتنشن (attention) داشته باشد؛ بهجای 1024 ضرب ماتریسی متوالی، آموزش را در قالب یک ضرب ماتریسی بزرگ انجام دهید.
نتیجه تا سال 2026 بر تمام حوزهها سایه انداخته است: زبان (GPT-5، Claude 4، Llama 4)، بینایی (ViT، DINOv2، SAM 3)، صوت (Whisper)، زیستشناسی (AlphaFold 3) و رباتیک (RT-2). همان یک بلوک ساختاری، با ورودیهای متفاوت.
مفهوم
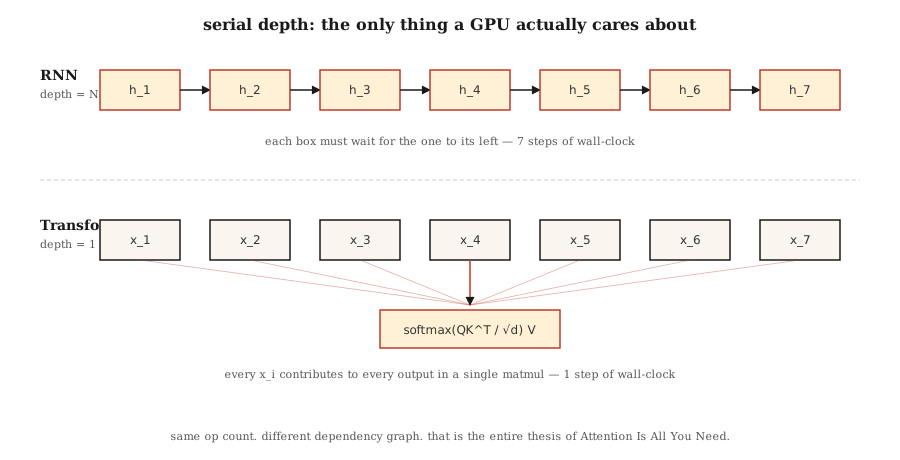
بازگشت بهعنوان گلوگاه. یک RNN مقدار را محاسبه میکند. هر گام وابسته به گام قبلی است. نمیتوانید را پیش از حساب کنید. روی GPUهای امروزی با بیش از 10000 هستهی موازی، این رفتار در توالیهای طولانی 99٪ از پتانسیل سختافزار را هدر میدهد.
اتنشن بهمثابهی برودکست. خوداتنشن (Self-attention) مقدار output_i = sum_j(a_ij * v_j) را برای تکتک جفتهای همزمان محاسبه میکند. کل ماتریس اتنشن N×N با یک ضرب ماتریسی دستهای (batched matmul) پر میشود. هیچ گامی معطل گام دیگری نمیماند؛ دقیقاً همان چیزی که GPUها عاشقش هستند.
شتابِ بهدستآمده یک ضریب ثابت نیست. صحبت از تفاوت بین عمق ترتیبی و است. در عمل، ترنسفورمرها در طول N=512 روی سختافزار مشابه 5 تا 10 برابر در هر دور آموزش (epoch) سریعترند. این شکاف با بلندتر شدن توالی عمیقتر هم میشود؛ تا جایی که به دیوار حافظهی اتنشن برخورد کنید (مسئلهای که Flash Attention بعدها حلش کرد — درس 12 را ببینید).
هزینهی ترنسفورمرها. مصرف حافظهی اتنشن با نسبت بالا میرود. این موضوع برای بافت (context) به اندازهی 2K مشکلی ندارد، اما برای 128K، چارهای جز استفاده از پنجرهی لغزان (sliding window)، برونیابی RoPE، قطعهبندی (tiling) در Flash Attention یا نسخههای اتنشن خطی ندارید. مدلهای بازگشتی چه از نظر زمان و چه حافظه بودند؛ ترنسفورمرها زمان را فدای حافظه میکنند و بعد همان زمان را با موازیسازی پس میگیرند.
تغییر سوگیری استقرایی. شبکههای RNN فرض را بر موضعی بودن و جدیدتر بودن دادهها میگذارند. ترنسفورمرها هیچ فرضی ندارند — هر جفت توکن میتواند کاندیدای اتنشن باشد. به همین دلیل ترنسفورمرها برای یادگیری مناسب به دادهی بیشتری نیاز دارند، اما بهمحض تأمین داده، مقیاسپذیری خیرهکنندهای از خود نشان میدهند. مقالهی چینچیلا (Chinchilla در سال 2022) این اصل را فرمولبندی کرد: اگر توکنهای کافی در اختیار داشته باشید، ترنسفورمر همیشه یک RNN با تعداد پارامتر برابر را شکست میدهد.
پیادهسازی
اینجا سراغ شبکه عصبی نمیرویم؛ گلوگاه اصلی را بهصورت عددی شبیهسازی میکنیم تا شکاف عملکردی را مستقیماً روی سیستم خود لمس کنید.
گام 1: سنجش عمق ترتیبی
فایل code/main.py را ببینید. دو تابع پیاده میکنیم: یکی توالی را بهشکل زنجیرهای از جمعها کُد میکند (ترتیبی، مثل RNN)؛ دیگری آن را بهشکل تقلیل موازی (parallel reduction) کد میکند (برودکست، مثل اتنشن). ریاضیات پشت هر دو یکی است، ولی گراف وابستگی فرق دارد.
def rnn_style(xs):
    h = 0.0
    for x in xs:
        h = 0.9 * h + x   # can't parallelize: h depends on previous h
    return h

def attention_style(xs):
    return sum(xs) / len(xs)  # every x is independent
هر دو تابع را روی توالیهایی با حداکثر 100000 عنصر زمانسنجی میکنیم. نسخهی RNN با مرتبهی زمانی روی یک پایپلاین (pipeline) تکهستهای CPU اجرا میشود. حتی در پایتون خالص، تقلیل به سبک اتنشن در طولهای بالای 1000 جلو میافتد؛ زیرا تابع sum() پایتون در C نوشته شده و به ازای هر گام گرفتار سربار مفسر پایتون نمیشود.
گام 2: محاسبهی تئوری تعداد عملیات
هر دو الگوریتم N عمل جمع انجام میدهند. تفاوت اصلی در عمق وابستگی (dependency depth) است: اینکه پیش از آغاز مرحلهی بعد، چند عمل باید حتماً پشت سر هم انجام شوند. عمق RNN برابر با N است؛ در حالی که عمق اتنشن با تقلیل درختی برابر با log(N) و با اسکن موازی برابر با 1 خواهد بود. آنچه زمان پردازش روی GPU را تعیین میکند همین عمق است، نه صرفاً تعداد عملیات.
گام 3: مقایسهی تجربی مقیاسپذیری در توالیهای طولانی
جدول زمانی بهدستآمده، شکاف را کاملاً روشن میکند. روی یک لپتاپ مک سال 2026، اجرای توالیهای زیر 1000 عنصر سریعتر از آن است که قابل ثبت باشد. اما در توالیهای 100000 عنصری، اسکن خطی کاملاً خود را نشان میدهد. اگر این رفتار را برای یک ترنسفورمر 16384 توکنی در برابر یک مدل 12 لایهی LSTM تعمیم دهید، میبینید چرا در سال 2016 زمان آموزش عملاً مانعی بر سر راه پیشرفت بود.
کاربرد عملی
چه زمانی در سال 2026 هنوز باید به سراغ RNN برویم؟
| موقعیت | انتخاب مناسب |
|---|---|
| استنتاج به شیوهی استریمینگ (streaming)، توکن به توکن و با حافظهی ثابت | شبکهی RNN یا مدلهای فضای حالت (Mamba، RWKV) |
| توالیهای بسیار طولانی (بیش از 1M توکن) که حافظهی اتنشن پر میشود | اتنشن خطی، Mamba 2، Hyena |
| دستگاههای لبه (Edge) بدون شتابدهندهی ضرب ماتریسی | مدلهای Depthwise-separable RNN از نظر بازدهی توان (FLOPs/watt) همچنان پیشتازند |
| هر سناریوی دیگری (آموزش، استنتاج دستهای، بافت تا 128K) | ترنسفورمر |
مدلهای فضای حالت (SSM) مانند Mamba در عمل همان RNNهایی هستند که با پارامترسازی ساختاریافته بهینه شدهاند تا مزایای هر دو دنیا را داشته باشند: مصرف حافظهی در اسکن و آموزش موازی از طریق اسکن انتخابی (selective scan). این مدلها 90٪ کیفیت ترنسفورمرها را تأمین میکنند و در بافتهای بسیار طولانی مقیاسپذیری بهمراتب بهتری دارند. در سال 2026، بیشتر آزمایشگاههای پیشرو مدلهای ترکیبی SSM+ترنسفورمر (مثل Jamba و Samba) را آموزش میدهند؛ سازوکار بازگشتی نمرده، بلکه به جزئی از یک کل تبدیل شده است.
ارائهی نهایی
فایل outputs/skill-architecture-picker.md را بررسی کنید. این مهارت با در نظر گرفتن محدودیتهای طول توالی، نرخ پردازش (throughput) و بودجهی آموزش، معماری مناسب را برای مسائل مبتنی بر توالی پیشنهاد میدهد. این ابزار برای فرآیندهای آموزشی بالای 1 میلیارد توکن هرگز نباید یک RNN خالص را بدون گوشزد کردن بدهبستانها توصیه کند.
تمرینها
- ساده. تابع
rnn_styleدر فایلcode/main.pyرا باز کنید و وضعیت پنهان اسکالر را با یک بردار 64 تایی از وضعیتهای پنهان جایگزین کنید. زمان اجرا را دوباره اندازه بگیرید. با افزایش بعد وضعیت پنهان، سربار اجرای ترتیبی چقدر رشد میکند؟ - متوسط. یک الگوریتم جمع پیشوندی موازی (اسکن Hillis-Steele) را با پایتون خالص پیادهسازی کنید. بررسی کنید که خروجی عددی آن با اسکن ترتیبی روی توالی با طول 1024 دقیقاً یکسان باشد. عمق گراف محاسباتی آن را حساب کنید.
- سخت. کاهش به سبک اتنشن را در PyTorch پیاده کرده و روی GPU ببرید. هر دو حالت را با تغییر طول توالی از 64 تا 65536 زمانسنجی کنید. نمودار آن را رسم کرده و علت فرم منحنی را تحلیل کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتگوها | معنای دقیق فنی |
|---|---|---|
| بازگشت (Recurrence) | «مدلهای RNN ترتیبی هستند» | نوعی محاسبه که در آن گام t به گام t-1 وابسته است و اجرای ترتیبی را روی محور زمان تحمیل میکند. |
| عمق ترتیبی (Serial depth) | «گراف چقدر عمیق است» | طولانیترین زنجیره از عملیات وابسته (dependent)؛ حتی با داشتن سختافزار بینهایت، حداقل زمان اجرای واقعی را محدود میکند. |
| اتنشن (Attention) | «اجازه دهیم توکنها به هم نگاه کنند» | مجموع وزندار که در آن از امتیاز شباهت بین جایگاههای و به دست میآید. |
| پنجرهی بافت (Context window) | «مدل چقدر میبیند» | تعداد جایگاههایی که یک لایهی اتنشن میتواند در ورودی بپذیرد؛ رشد درجهدوم مصرف حافظه از همینجا ناشی میشود. |
| سوگیری استقرایی (Inductive bias) | «فرضیاتی که در دل معماری قرار گرفته» | پیشین (prior) دربارهی ساختار دادهها؛ شبکههای CNN فرض را بر ناورایی انتقالی و شبکههای RNN بر جدیدتر بودن اطلاعات میگذارند. |
| مدل فضای حالت (State-space model) | «شبکهی RNN با پشتوانهی جبری» | مدلی بازگشتی با ماتریسهای ساختاریافته در فضای حالت، بهگونهای فرمولبندی شده که امکان آموزش موازی را فراهم کند. |
| گلوگاه درجهدو (Quadratic bottleneck) | «چرا بافت طولانی اینقدر هزینه دارد» | مصرف حافظه در اتنشن نسبت به طول توالی بهصورت مقیاس میگیرد؛ Flash Attention ضرایب ثابت را کاهش میدهد، نه خود رابطهی مقیاسپذیری را. |
منابع برای مطالعهی بیشتر
- Vaswani et al. (2017). Attention Is All You Need — مقالهای که بازگشت را در پردازش زبان طبیعی جریان اصلی کنار زد.
- Bahdanau, Cho, Bengio (2014). Neural MT by Jointly Learning to Align and Translate — نقطهی تولد اتنشن، که در ابتدا به یک RNN متصل شده بود.
- Hochreiter, Schmidhuber (1997). Long Short-Term Memory — مقالهی اصلی LSTM، برای ثبت در تاریخچه.
- Gu, Dao (2023). Mamba: Linear-Time Sequence Modeling with Selective State Spaces — پاسخ بازگشتی مدرن به ترنسفورمرها.