
یادگیری تکتک اجزای ترنسفورمرها از مکانیزم توجه گرفته تا لایههای پیشخور و امبدینگهای مکانی بسیار ارزشمند است، اما چالش اصلی مهندسان زمانی آغاز میشود که بخواهند تمام این قطعات را در یک معماری منسجم کنار هم قرار دهند و مدلی واقعی را آموزش دهند. در این پروژهی نهایی، تمام آموختههای پیشین را در قالب یک مدل زبانی فقط-دیکودر (Decoder-only) سرتاسری پیادهسازی میکنید.
مزیت بزرگ این پیادهسازی در سبک بودن آن است؛ شما برای تست این معماری نیازی به سرورهای ابری گرانقیمت یا پردازندههای گرافیکی پیچیده نخواهید داشت. مدل با حدود 800 هزار پارامتر طراحی شده و روی پردازندهی معمولی لپتاپ (حتی با نسخه CPU پایتورچ) در کمتر از 10 دقیقه آموزش میبیند. بنابراین بدون نگرانی از دسترسی به منابع ابری خارجی، میتوانید چرخه کامل یادگیری را روی سیستم محلی تجربه کنید.
اگر در مراحل راهاندازی و نصب کتابخانهی PyTorch با کندی یا اختلال مواجه شدید، میتوانید از میرورهای داخلی مخزن PyPI برای نصب سریعتر پکیجها استفاده کنید. ساختار کدی که در این درس پیاده میکنید، نسخهای بازطراحیشده از nanoGPT است که به شما امکان میدهد بعدها با جایگزینی توکنایزر و افزایش دادهها، پایهای استاندارد برای پروژههای بزرگتر در اختیار داشته باشید.
سیزده درس. یک مدل. بدون میانبُر.
صورت مسئله
همهی مقالهها را خواندهاید. اتنشن (Attention)، تفکیک چندسر (Multi-Head Splits)، کدگذاریهای مکانی (Positional Encodings)، بلوکهای انکودر و دیکودر، توابع زیان BERT و GPT، معماری MoE و کش KV را پیادهسازی کردهاید. حالا وقت آن است که همهی اینها را کنار هم بگذارید تا روی یک تسک واقعی کار کنند.
پروژهی پایانی: آموزش کامل و سرتاسریِ (End-to-End) یک ترنسفورمر کوچک فقط-دیکودر (Decoder-Only) برای مدلسازی زبان در سطح کاراکتر. این مدل متنهای شکسپیر را میخواند و متنهایی به سبک او تولید میکند؛ آنقدر کوچک است که روی لپتاپ در کمتر از 10 دقیقه آموزش میبیند، و ساختار آنقدر درستی دارد که اگر دیتاست بزرگتر و زمان آموزش بیشتری به آن بدهید، یک مدل زبانی (LM) واقعی تحویلتان خواهد داد.
این در واقع همان «nanoGPT» این دوره است؛ ایدهی کاملاً دستاولی نیست — آموزش nanoGPT کارپاتی در سال 2023 پیادهسازی مرجعی است که هر دانشجویی حداقل یک بار مینویسد. ما همان ساختار را برداشتهایم و بر اساس مباحثی که پوشش دادیم، بازطراحیاش کردهایم.
مفاهیم پایه
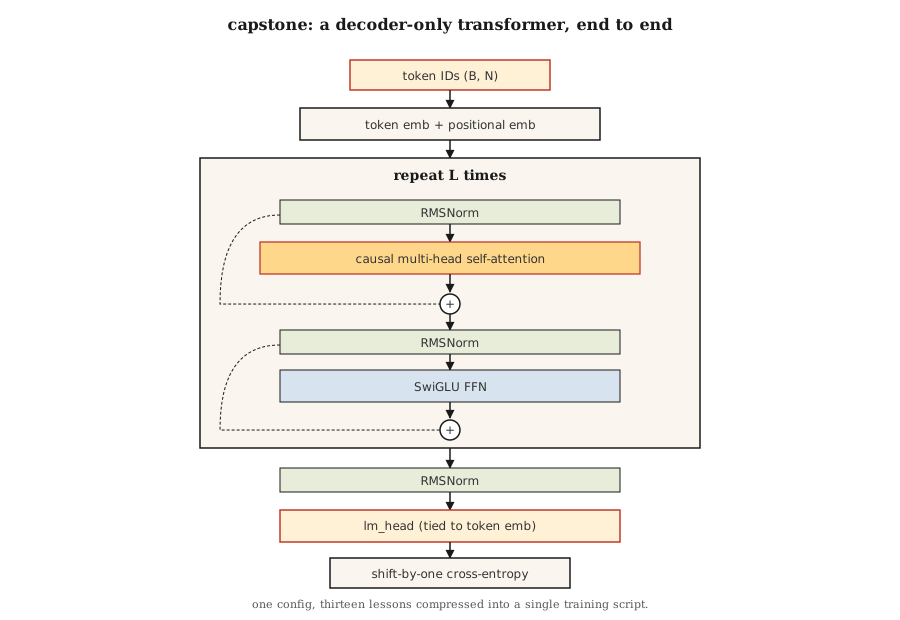
معماری مدل به همراه توضیحات:
input tokens (B, N)
   │
   ▼
token embedding + positional embedding  ◀── Lesson 04 (RoPE option)
   │
   ▼
┌──── block × L ────────────────────┐
│  RMSNorm                          │  ◀── Lesson 05
│  MultiHeadAttention (causal)      │  ◀── Lesson 03 + 07 (causal mask)
│  residual                         │
│  RMSNorm                          │
│  SwiGLU FFN                       │  ◀── Lesson 05
│  residual                         │
└────────────────────────────────── ┘
   │
   ▼
final RMSNorm
   │
   ▼
lm_head (tied to token embedding)
   │
   ▼
logits (B, N, V)
   │
   ▼
shift-by-one cross-entropy ◀── Lesson 07بخشهایی که پیادهسازی میکنیم
GPTConfig— کلاسی متمرکز برای پیکربندی تمام ابرپارامترها.MultiHeadAttention— علّی (Causal)، دستهای (Batched) و با مسیر اختیاری شبیه Flash Attention (تابعscaled_dot_product_attentionدر PyTorch).SwiGLUFFN— لایهی پیشخور (FFN) مدرن.Block— لایهبندی Pre-Norm با اتصالات باقیمانده (Residual) دور اتنشن و FFN.GPT— امبدینگها، بلوکهای چیدهشده رویهم، سرِ مدل زبانی (LM Head) و متد ()generate.- حلقهی آموزش با بهینهساز AdamW، زمانبندی کسینوسی نرخ یادگیری و برش گرادیان (Gradient clipping).
- توکنایزر در سطح کاراکتر روی متنهای شکسپیر.
بخشهایی که پیادهسازی نمیکنیم
- RoPE — مفهوم آن در درس 04 پیاده شد. در اینجا برای سادگی از امبدینگهای مکانیِ یادگرفتنی استفاده میکنیم. در تمرینها از شما خواسته شده RoPE را جایگزین کنید.
- کش KV حین تولید متن — در هر گام تولید، اتنشن روی کل پیشوند دوباره محاسبه میشود؛ کندتر است، ولی پیادهسازی سادهتری دارد. در تمرینها اضافه کردن کش KV را تمرین خواهید کرد.
- Flash Attention — اگر ابعاد و مشخصات ورودیها همخوانی داشته باشد، PyTorch نسخه 2.0 به بالا بهطور خودکار این بهینهسازی را اعمال میکند؛ ما از
F.scaled_dot_product_attentionاستفاده میکنیم. - MoE — در هر بلوک فقط یک FFN استاندارد قرار دارد. با ساختار MoE در درس 11 آشنا شدید.
معیارهای هدف
روی یک لپتاپ مک M2، یک مدل GPT با 4 لایه، 4 سر، و 128=d_model که برای 2,000 گام روی tinyshakespeare.txt آموزش ببیند:
- تابع زیان آموزش (Training loss) در حدود 6 دقیقه، از حدود 4.2 (حالت تصادفی) به حدود 1.5 همگرا میشود.
- خروجی نمونهگیریشده شبیه متنهای شکسپیر است: کلمات کهن، شکستن سطرها و نامهایی مثل «:ROMEO» ظاهر میشوند.
- تابع زیان اعتبارسنجی (روی 10٪ پایانی متن که کنار گذاشته شده بود) پابهپای زیان آموزش حرکت میکند؛ در این مقیاس و بودجهی آموزشی، خبری از بیشبرازش (Overfitting) نیست.
ساخت مدل
این درس با PyTorch کار میکند. کتابخانهی torch را نصب کنید (نسخهی مخصوص CPU کاملاً کافی است). فایل code/main.py را ببینید. این اسکریپت بخشهای زیر را مدیریت میکند:
- دانلود فایل
tinyshakespeare.txtدر صورت موجود نبودن (یا خواندن فایل محلی). - توکنایزر کاراکتری در سطح بایت.
- تقسیم دادهها به بخش آموزش و اعتبارسنجی با نسبت 90 به 10.
- حلقهی آموزش با bf16 autocast روی سختافزارهایی که از آن پشتیبانی میکنند.
- نمونهگیری و تولید متن پس از پایان آموزش.
گام 1: دادهها
text = open("tinyshakespeare.txt").read()
chars = sorted(set(text))
stoi = {c: i for i, c in enumerate(chars)}
itos = {i: c for c, i in stoi.items()}
encode = lambda s: [stoi[c] for c in s]
decode = lambda xs: "".join(itos[x] for x in xs)
65 کاراکتر منحصربهفرد. واژگانی بسیار کوچک که در یک vocab_size چهار بایتی جا میگیرد. نه خبری از BPE است و نه دردسرهای توکنایزر.
گام 2: مدل
فایل code/main.py را ببینید. بلوک مدل دقیقاً طبق روش استاندارد درس 05 پیاده شده است: ساختار Pre-norm، لایهی RMSNorm، تابع فعالسازی SwiGLU و MHA علّی. تعداد پارامترها برای پیکربندی 4/4/128 حدود 800 هزار است.
گام 3: حلقهی آموزش
یک دستهی تصادفی از پنجرههای توکنی به طول 256 بگیرید. عبور رو به جلو (Forward). محاسبهی آنتروپی متقاطع (Cross-Entropy) با یک توکن جابهجایی. پسانتشار (Backward). یک گام با AdamW. ثبت لاگ. تکرار.
for step in range(max_steps):
    x, y = get_batch("train")
    logits = model(x)
    loss = F.cross_entropy(logits.view(-1, vocab_size), y.view(-1))
    loss.backward()
    torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
    opt.step()
    opt.zero_grad()
گام 4: نمونهگیری
با دریافت یک پرامپت، مکرراً عبور رو به جلو را انجام دهید، از بین لاجیتها با روش top-p نمونهگیری کنید، توکن جدید را بچسبانید و ادامه دهید. بعد از 500 توکن کار را متوقف کنید.
گام 5: بررسی خروجی
پس از 2,000 گام:
ROMEO:
Away and mild will not thy friend, that thou shalt wit:
The chief that well shame and hath been his friends,
...
خود شکسپیر نیست، اما ساختار متنهای او را دارد؛ موفقیتی چشمگیر برای مدلی با حدود 800 هزار پارامتر و 6 دقیقه آموزش روی لپتاپ.
توسعه و کاربرد عملی
این پروژهی پایانی یک معماری مرجع است. برای اینکه آن را به سیستمی واقعی و عملیاتی تبدیل کنید، سه مسیر پیش رو دارید:
- تعویض توکنایزر. از BPE استفاده کنید (مثلاً
tiktoken.get_encoding("cl100k_base")). در این حالت اندازهی واژگان از 65 به حدود 50,000 میرسد. ظرفیت مدل هم باید افزایش یابد تا این افزایش ابعاد جبران شود. - آموزش روی مجموعهدادهی بزرگتر. از
OpenWebTextیاfineweb-edu(در HuggingFace) استفاده کنید. آموزش روی 10 میلیارد توکن با یک پردازندهی A100 برای یک مدل GPT با 125 میلیون پارامتر حدود 24 ساعت زمان میبرد. - افزودن RoPE، کش KV و Flash Attention. تمرینهای زیر تکتک این موارد را قدمبهقدم پوشش میدهند.
در نهایت به یک مدل GPT با 125 میلیون پارامتر میرسید که انگلیسی روان تولید میکند؛ این یک مدل مرز دانش (Frontier model) نیست، اما از همان مسیر کدی بهره میبرد — فقط در ابعادی بزرگتر — که Karpathy، EleutherAI و Allen Institute در سال 2026 برای آموزش چکپوینتهای تحقیقاتیشان به کار میبرند.
انتشار و بازبینی
فایل outputs/skill-transformer-review.md را ببینید. این اسکیل صحت پیادهسازی ترنسفورمر از صفر را بر اساس مفاهیم تمام 13 درس قبلی بررسی و بازبینی میکند.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. مطمئن شوید تابع زیان اعتبارسنجی مدل در گام نهایی زیر 2.0 باشد. متغیرmax_stepsرا از 2,000 به 5,000 تغییر دهید؛ آیا زیان اعتبارسنجی باز هم بهبود مییابد؟ - متوسط. امبدینگهای مکانی یادگرفتنی را با RoPE جایگزین کنید. تبدیل چرخشی را روی ماتریسهای Q و K درون
MultiHeadAttentionاعمال کنید. مدل را آموزش دهید و مطمئن شوید زیان اعتبارسنجی حداقل به همان اندازه پایین میآید. - متوسط. یک کش KV در حلقهی نمونهگیری پیاده کنید. 500 توکن را یک بار با کش و یک بار بدون آن تولید کنید. زمان اجرای واقعی (Wall-clock) روی لپتاپ باید بین 5 تا 20 برابر بهتر شود.
- سخت. یک سرِ دوم به مدل اضافه کنید تا توکنِ بعد از بعدی را هم پیشبینی کند (تکنیک MTP یا Multi-Token Prediction از مدل DeepSeek-V3). مدل را بهصورت مشترک آموزش دهید. آیا به بهبود کیفیت کمکی میکند؟
- سخت. تکلایهی FFN در هر بلوک را با یک MoE متشکل از 4 متخصص (Expert) جایگزین کنید: روتِر بههمراه مسیریابیِ top-2. بررسی کنید که در شرایط برابر از نظر تعداد پارامترهای فعال، زیان اعتبارسنجی چه تغییری میکند.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوهای روزمره | معنای دقیق فنی |
|---|---|---|
| nanoGPT | «مخزن آموزشی کارپاتی» | کُد مینیمال برای آموزش یک ترنسفورمر فقط-دیکودر در حدود 300 خط؛ مرجع استاندارد این حوزه. |
| tinyshakespeare | «دیتاست اسباببازی استاندارد» | حدود 1.1 مگابایت متن؛ از سال 2015 تقریباً همهی آموزشهای مدلسازی زبان کاراکتری از آن استفاده میکنند. |
| Tied embeddings | «اشتراک ماتریس ورودی و خروجی» | وزنهای سرِ مدل زبانی دقیقاً ترانهادهی (Transpose) ماتریس امبدینگ توکنهاست؛ پارامترها را کاهش میدهد و کیفیت را بالا میبرد. |
| bf16 autocast | «ترفند دقت آموزش» | اجرای رفتوبرگشت در دقت bf16 و نگهداشتن وضعیت بهینهساز در fp32؛ روشی استاندارد از سال 2021. |
| Gradient clipping | «جلوگیری از جهشهای ناگهانی» | محدود کردن نُرم کلی گرادیان روی 1.0؛ مانع از انفجار آموزش میشود. |
| Cosine LR schedule | «پیشفرض مدلها از 2020 به بعد» | نرخ یادگیری ابتدا بهصورت خطی بالا میرود (وارمآپ (پیشگرمایش)) و سپس با منحنی کسینوسی تا 10٪ مقدار اوج کاهش مییابد. |
| MFU | «نرخ بهرهوری از فلاپس مدل» | فلاپس واقعیِ بهدستآمده تقسیم بر حداکثر توان تئوری سختافزار؛ در سال 2026 دستیابی به 40٪ برای مدلهای متراکم (Dense) و 30٪ برای MoE عملکردی عالی به حساب میآید. |
| Val loss | «تابع زیان دادههای تست» | مقدار آنتروپی متقاطع روی دادههایی که مدل هرگز ندیده است؛ معیاری برای تشخیص بیشبرازش. |
برای مطالعهی بیشتر
- The Annotated Transformer (Harvard NLP) — پیادهسازی کلاسیک ترنسفورمر همراه با یادداشتهای تحلیلی.