
در سالهای اخیر مدلهای زبانی صرفاً دیکودر تمام توجه جامعه هوش مصنوعی را به خود جلب کردهاند، اما برای بسیاری از تسکها مثل ترجمه ماشینی، تبدیل گفتار به متن و خلاصهسازی، ساختار ورودی-خروجی بهینه در انکودر-دیکودر خلاصه میشود. مدلهایی مانند T5 و BART ستونهای اصلی این نگرش هستند که وظایف پردازش متن را بدون نیاز به بازسازی کل رشته، در قالب تبدیل ساختارمند یک توالی به توالی دیگر پردازش میکنند.
درک سازوکار کراساتنشن و الگوهای پیشآموزش این مدلها (مانند span corruption در T5 یا نویززدایی در BART) به شما دیدی شفاف میدهد تا بدانید چه زمانی باید به سراغ یک معماری دوطرفه بروید و چه زمانی مدلهای صرفاً دیکودر پاسخگوی نیاز شما خواهند بود. این درس نه تنها زیربنای مدلهای مدرنی مثل Whisper را روشن میکند، بلکه نحوه پیادهسازی و ارزیابی فنی این خانواده از شبکهها را از صفر تا اجرا آموزش میدهد.
انکودرها درک میکنند، دیکودرها تولید میکنند. این دو را کنار هم بگذارید تا مدلی ساخته شود که دقیقاً برای تسکهای ورودی ← خروجی طراحی شده است: ترجمه، خلاصهسازی، بازنویسی و پیادهسازی متن گفتار.
صورت مسئله
مدلهای صرفاً دیکودر (decoder-only) مثل GPT و صرفاً انکودر (encoder-only) مثل BERT، هر دو معماری سال 2017 ترنسفورمر (Transformer) را برای هدفی متفاوت سادهتر کردند. با این حال، ساختار بسیاری از تسکها ذاتاً ورودی-خروجی است:
- ترجمه: انگلیسی ← فرانسوی.
- خلاصهسازی: مقالهی 5000 توکنی ← خلاصهی 200 توکنی.
- تشخیص گفتار: توکنهای صوتی ← توکنهای متنی.
- استخراج ساختاریافته: متن ساده ← JSON.
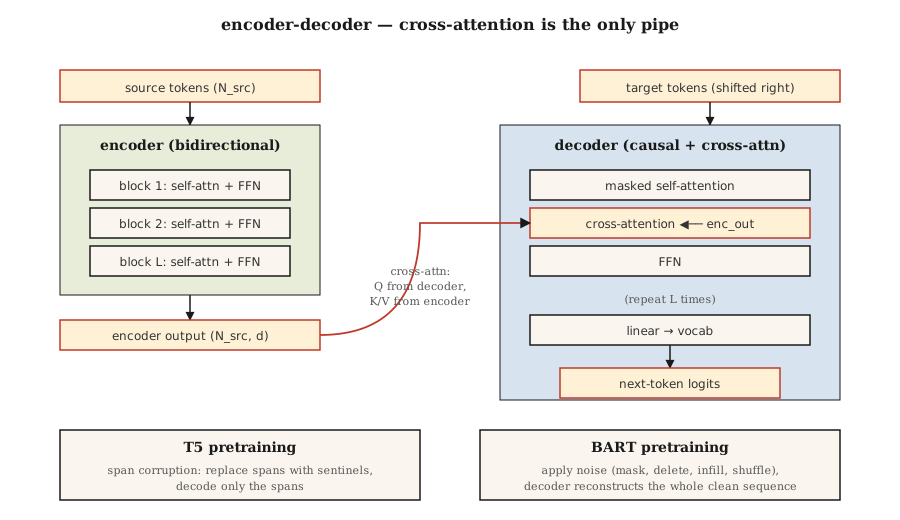
برای این تسکها، معماری انکودر-دیکودر شستهرفتهترین گزینه است. انکودر یک نمایش فشرده و غنی از ورودی میسازد؛ دیکودر هم خروجی را تولید میکند و در هر گام، از طریق کراساتنشن (Cross-Attention) روی آن نمایش متمرکز میشود. آموزش در سمت خروجی با شیفت یکواحدی به جلو انجام میگیرد؛ یعنی همان تابع زیان (loss) مدل GPT، ولی مشروط به خروجی انکودر.
دو مقالهی بنیادین مسیر مدرن این حوزه را مشخص کردند:
- T5 (رافل و همکاران، 2019). «ترنسفورمر یادگیری انتقالی متنبهمتن» (Text-to-Text Transfer Transformer). در این مقاله، تمام تسکهای پردازش زبان طبیعی در قالب «متن ورودی، متن خروجی» بازتعریف شدند؛ با یک معماری واحد، واژگان یکتا و تابع زیان یکسان. پیشآموزش آن بر پایهی پیشبینی بخشهای پوشاندهشده (masked span prediction) انجام میشد (تخریب بخشهایی از ورودی و بازسازی آنها در خروجیِ دیکودر).
- BART (لوئیس و همکاران، 2019). «ترنسفورمر دوطرفه و خودبازگشتی» (Bidirectional and Auto-Regressive Transformer). یک خودرمزگذار نویززدا (denoising autoencoder): ورودی را با چند روش مختلف تخریب میکند (جابهجایی، ماسکگذاری، حذف و چرخش) و از دیکودر میخواهد متن اصلی را بازسازی کند.
در سال 2026، ساختار انکودر-دیکودر هنوز در حوزههایی که ساختار ورودی اهمیت دارد کاملاً زنده است:
- مدل Whisper (تبدیل گفتار ← متن).
- سامانههای ترجمهی ماشینی گوگل.
- برخی مدلهای تکمیل و اصلاح کد که بافت مسئله و بخش ویرایشی در آنها ساختار متمایزی دارند.
- مدل Flan-T5 و نسخههای مشتق از آن برای تسکهای استدلال ساختاریافته.
مدلهای صرفاً دیکودر توجه همه را به خود جلب کردند، اما انکودر-دیکودر هیچوقت کنار نرفت.
مفاهیم اصلی
حلقهی گذر رو به جلو
source tokens ─▶ encoder ─▶ (N_src, d_model)  ──┐
                                                 │
target tokens ─▶ decoder block                   │
                 ├─▶ masked self-attention       │
                 ├─▶ cross-attention ◀───────────┘
                 └─▶ FFN
                ↓
next-token logitsنکتهی کلیدی این است: انکودر برای هر ورودی فقط یک بار اجرا میشود. دیکودر بهصورت خودبازگشتی پیش میرود، اما در هر گام روی همان خروجی انکودر کراساتنشن میزند. کَش کردن خروجی انکودر، سرعت پردازش ورودیهای طولانی را بدون هیچ هزینهای بالا میبرد.
پیشآموزش T5 — تخریب بخشهای متن (span corruption)
بخشهایی تصادفی از ورودی انتخاب میشوند (بهطور میانگین به طول 3 توکن و در مجموع 15% از کل متن). هر بخش با یک نشانهی نگهدارندهی یکتا جایگزین میشود: <extra_id_0>، <extra_id_1> و به همین ترتیب. دیکودر فقط همان بخشهای تخریبشده را همراه با پیشوند نگهدارندهشان در خروجی تولید میکند:
source: The quick <extra_id_0> fox jumps <extra_id_1> dog
target: <extra_id_0> brown <extra_id_1> over the lazy
این کار سیگنال یادگیری کمهزینهتری نسبت به پیشبینی کل توالی فراهم میکند. در آزمایشهای حذف مؤلفه (ablation) در مقالهی T5، این روش کارایی برابری با مدلسازی زبان با پوشش (MLM در BERT) و مدلسازی زبان با پیشوند (prefix-LM در UniLM) نشان داد.
پیشآموزش BART — نویززدایی با چندین روش نویز
مدل BART پنج تابع مختلف برای اعمال نویز دارد:
- ماسکگذاری توکن.
- حذف توکن.
- پر کردن متن (ماسکگذاری یک بخش تا دیکودر طول و متن مناسب را درج کند).
- جابهجایی جملات.
- چرخش سند.
ترکیبِ پر کردن متن و جابهجایی جملات، بهترین نتایج را در تسکهای نهایی رقم زد. دیکودر همیشه متن اصلی را بهطور کامل بازسازی میکند. برعکس T5 که فقط بخشهای تخریبشده را میساخت، خروجی BART کل توالی است؛ بنابراین محاسبات پیشآموزش سنگینتری نسبت به T5 دارد.
استنتاج
تولید متن درست مانند GPT بهصورت خودبازگشتی است. روشهای نمونهبرداری حریصانه (greedy)، پرتو (beam) و top-p همگی در اینجا هم کاربرد دارند. جستجوی پرتو (با عرض 4 تا 5) گزینهی استاندارد برای ترجمه و خلاصهسازی است؛ چون در این تسکها توزیع خروجی نسبت به چت محدودتر است.
انتخاب مدل مناسب در سال 2026
| تسک | انکودر-دیکودر؟ | دلیل |
|---|---|---|
| ترجمه | بله، معمولاً | توالی مبدا کاملاً مشخص است؛ توزیع خروجی معین است؛ جستجوی پرتو عالی جواب میدهد |
| گفتار به متن | بله (Whisper) | مُدالیتهی ورودی با خروجی تفاوت دارد؛ انکودر ویژگیهای صوتی را استخراج میکند |
| چت / استدلال | خیر، صرفاً دیکودر | «ورودی» ثابتی وجود ندارد — کل گفتگو همان توالی است |
| تکمیل کد | معمولاً خیر | مدلهای صرفاً دیکودر با طول بافت بالا برتری دارند؛ مدلهای کد مثل Qwen 2.5 Coder صرفاً دیکودر هستند |
| خلاصهسازی | هر دو جواب میدهند | مدلهای BART و PEGASUS از مدلهای اولیهی صرفاً دیکودر بهتر عمل کردند؛ LLMهای مدرن فعلی به همان سطح رسیدهاند |
| استخراج ساختاریافته | هر دو | چارچوب T5 شستهرفته است، چون منطق «متن ← متن» با هر فرمت خروجی سازگار میشود |
روند حاکم از حدود سال 2022 به این سو: مدلهای صرفاً دیکودر تسکهایی را تصاحب کردهاند که پیشتر در انحصار انکودر-دیکودر بود. دلایل آن مشخص است: الف) مدلهای زبانی بزرگِ تنظیمشده با دستورالعمل (instruction-tuned) با پرامپت (Prompt) بهخوبی روی هر کاری تعمیم مییابند، ب) مقیاسپذیری یک معماری سادهتر از دو معماری مجزاست، ج) روشهای RLHF بر پایهی دیکودر طراحی شدهاند. با این حال، انکودر-دیکودر در تسکهایی که مُدالیتهی ورودی تفاوت دارد (صوت، تصویر) یا کیفیت جستجوی پرتو حیاتی است، جایگاه خود را حفظ کرده است.
پیادهسازی از صفر
کد را در code/main.py ببینید. ما تخریب بخشهای متن را به سبک T5 برای یک پیکرهی نمونه پیادهسازی میکنیم؛ این تکنیک کاربردیترین بخش این درس است، چرا که در تمام روشهای پیشآموزش انکودر-دیکودر از آن زمان به بعد حضور دارد.
گام 1: تخریب بخشهای متن
def corrupt_spans(tokens, mask_rate=0.15, mean_span=3.0, rng=None):
    """Pick spans summing to ~mask_rate of tokens. Return (corrupted_input, target)."""
    n = len(tokens)
    n_mask = max(1, int(n * mask_rate))
    n_spans = max(1, int(round(n_mask / mean_span)))
    ...
فرمت هدف بر اساس استاندارد T5 است: <sent0> span0 <sent1> span1 .... ورودی تخریبشده، توکنهای دستنخورده را با توکنهای نگهدارنده در محل بخشهای حذفشده ترکیب میکند.
گام 2: اعتبارسنجی رفت و برگشتی
با استفاده از ورودی تخریبشده و هدف، متن اصلی را بازسازی کنید. اگر فرایند تخریب بازگشتپذیر باشد، گذر رو به جلو (forward pass) مدل دقیق و خوشتعریف خواهد بود. این کار یک سنجش سلامت عملکرد (sanity check) است؛ در آموزش واقعی هرگز چنین کاری انجام نمیشود، اما این تست کمهزینه است و باگهای ناشی از خطای یکواحدی (off-by-one) را در مدیریت بخشها بلافاصله شناسایی میکند.
گام 3: اعمال نویز به سبک BART
پنج تابع داریم: token_mask، token_delete، text_infill، sentence_permute و document_rotate. دو مورد از آنها را ترکیب کنید و نتیجه را ببینید.
استفاده از ابزارهای واقعی
پیادهسازی نمونه با HuggingFace:
from transformers import T5ForConditionalGeneration, T5Tokenizer
tok = T5Tokenizer.from_pretrained("google/flan-t5-base")
model = T5ForConditionalGeneration.from_pretrained("google/flan-t5-base")

inputs = tok("translate English to French: Attention is all you need.", return_tensors="pt")
out = model.generate(**inputs, max_new_tokens=32)
print(tok.decode(out[0], skip_special_tokens=True))
ترفند T5 این است: نام تسک مستقیماً داخل متن ورودی قرار میگیرد. به همین دلیل یک مدل واحد از پس دهها تسک مختلف برمیآید؛ چون هر تسک بهصورت «متن ورودی، متن خروجی» تعریف شده است. در سال 2026 این الگو توسط مدلهای صرفاً دیکودرِ دستورالعملدیده تعمیم یافته، اما مبدع اولیهی آن T5 بود.
کاربرد عملی
فایل outputs/skill-seq2seq-picker.md را ببینید. این اسکیل برای تسکهای جدید، بر اساس ساختار ورودی-خروجی، تاخیر (Latency) مجاز و اهداف کیفی، مدل مناسب را از بین معماری انکودر-دیکودر یا صرفاً دیکودر انتخاب میکند.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید، تخریب بخشهای متن را روی یک جملهی 30 توکنی اعمال کنید و مطمئن شوید که اتصال توکنهای غیرنگهدارندهی ورودی به بخشهای دیکودشدهی هدف، جملهی اولیه را بازسازی میکند. - متوسط. نویز
text_infillمدل BART را پیادهسازی کنید: بخشهای تصادفی را با یک توکن<mask>جایگزین کنید؛ دیکودر باید طول مناسب بخش و محتوای آن را پیشبینی کند. یک مثال خروجی نشان دهید. - سخت. مدل
flan-t5-smallرا روی یک مجموعهدادهی کوچک ترجمه از انگلیسی به زبان مخفی (Pig Latin) شامل 200 جفتمتن فاینتیونینگ (Fine-tuning) کنید. معیار BLEU را روی یک مجموعهی آزمون 50تایی اندازه بگیرید. عملکرد آن را با فاینتیونینگLlama-3.2-1Bروی همین دادهها و با توان محاسباتی یکسان مقایسه کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای واقعی و فنی |
|---|---|---|
| انکودر-دیکودر | «ترنسفورمر Seq2seq» | دو بخش مجزا: انکودر دوطرفه برای ورودی و دیکودر علّی (causal) با مکانیزم کراساتنشن برای خروجی. |
| کراساتنشن | «جایی که مبدا با مقصد حرف میزند» | ضرب Q دیکودر در K/V انکودر. تنها نقطهای است که اطلاعات انکودر وارد دیکودر میشود. |
| تخریب بخشهای متن (Span corruption) | «ترفند پیشآموزش T5» | جایگزینی بخشهای تصادفی متن با توکنهای نگهدارنده؛ دیکودر فقط آن بخشها را در خروجی تولید میکند. |
| تابع هدف نویززدایی (Denoising objective) | «روش کار BART» | اعمال یک تابع نویز روی ورودی و آموزش دیکودر برای بازسازی توالی اولیه و دستنخورده. |
| توکن نگهدارنده (Sentinel token) | «همان جایگزینهای <extra_id_N>» |
توکنهای ویژهای که بخشهای تخریبشده را در متن مبدا علامتگذاری میکنند و دوباره در متن مقصد تکرار میشوند. |
| Flan | «نسخهی دستورالعملدیدهی T5» | مدل T5 که روی بیش از 1800 تسک فاینتیون شده و معماری انکودر-دیکودر را در تبعیت از دستورات به سطحی رقابتی رسانده است. |
| جستجوی پرتو (Beam search) | «استراتژی دیکود کردن متن» | حفظ k توالی برتر در هر گام تولید؛ استاندارد تسکهای ترجمه و خلاصهسازی. |
| وادارسازی معلم (Teacher forcing) | «ورودی در زمان آموزش» | دادن توکن واقعی مرحلهی قبل به دیکودر در حین آموزش، بهجای استفاده از توکن نمونهبرداریشدهی خود مدل. |
برای مطالعهی بیشتر
- رافل و همکاران (2019). کاوش در مرزهای یادگیری انتقالی با ترنسفورمر یکپارچهی متنبهمتن — مقالهی T5.
- لوئیس و همکاران (2019). مقالهی BART: پیشآموزش دنبالهبهدنبالهی نویززدا برای تولید، ترجمه و کامپریهنشن (comprehension) زبان طبیعی — مقالهی BART.
- چونگ و همکاران (2022). مقیاسبندی مدلهای زبانی تنظیمشده با دستورالعمل — مقالهی Flan-T5.
- رادفورد و همکاران (2022). تشخیص گفتار مقاوم از طریق نظارت ضعیف در مقیاس بزرگ — مقالهی Whisper، نمونهی بارز معماری انکودر-دیکودر در سال 2026.
- فایل
modeling_t5.pyدر HuggingFace — پیادهسازی مرجع مدل.