
مکانیزم خوداتنشن تکسر (Self-Attention) تنها قادر است یک نوع رابطه میان کلمات را در هر لایه استخراج کند. وقتی در متن الگوهای گوناگونی نظیر تطابق فاعل و فعل، وابستگیهای معنایی دوربرد و ارجاعات ضمیرها همزمان وجود داشته باشند، یک سر تنها آنها را با هم درمیآمیزد و بخش بزرگی از ساختار متن گم میشود. اتنشن چندسر (Multi-Head Attention) این چالش را با تفکیک فضا به چند زیرفضای موازی حل میکند.
درک سازوکار MHA و مشتقات جدیدتر آن مانند GQA و MLA نهتنها به شفافشدن معماریهای بزرگی چون Llama 3 و DeepSeek کمک میکند، بلکه راهنمای حیاتی برای بهینهسازی مصرف حافظهی KV-cache هنگام استنتاج مدلها به شمار میرود. پیادهسازی گامبهگام این مکانیزم به شما نشان میدهد که اضافه کردن این سرها با تبدیلهای ماتریسی برداری و بدون نیاز به محاسبات افزون بر سختافزار پیاده میشود.
کدهای این بخش بهسادگی با محاسبات تانسوری استاندارد در پایتون و PyTorch روی سیستم شخصی یا پردازندههای سبک قابل اجرا هستند و پیادهسازی مدلهای پایهای آن نیازی به سختافزارهای پردازش گرافیکی پیچیده و پرهزینهی خارجی ندارد.
یک سر اتنشن در هر لحظه یک رابطه را یاد میگیرد. هشت سر، هشت رابطه را یاد میگیرند. سرها هزینهی محاسباتی اضافه ندارند؛ پس از تعداد بیشتری از آنها استفاده کنید.
صورت مسئله
یک سر سلفاتنشن (self-attention) منفرد، فقط یک ماتریس اتنشن محاسبه میکند. آن ماتریس هم تنها یک نوع رابطه را ثبت میکند؛ معمولاً همان رابطهای که تابع زیان (loss) را روی سیگنال آموزش به حداقل میرساند. اگر دادههای شما پر از تطابقهای فاعل و فعل، ارجاع متقابل (co-reference)، پیوندهای متنی دوربرد و قطعهبندی متن (syntactic chunking) بههمپیچیده باشد، یک سرِ تنها همهی آنها را در یک توزیع سافتمکس (soft-max) پخش و تار میکند و نیمی از سیگنال از دست میرود.
راهکار مقالهی واسوانی (Vaswani) در سال 2017: اجرای موازی چند تابع اتنشن که هرکدام تصویر کردن (projection) اختصاصی خود را برای Q و K و V دارند، و در نهایت الحاق (concatenate) خروجیها به یکدیگر. هر سر درون زیرفضای کوچکتری با بُعد عمل میکند. تعداد کل پارامترها ثابت میماند، اما قدرت بیانگری مدل بیشتر میشود.
اتنشن چندسر (Multi-Head Attention یا MHA) ساختار پیشفرضی است که در سال 2026 همهی ترنسفورمرها با آن عرضه میشوند. تنها بحث موجود بر سر تعداد سرها است و اینکه آیا کلیدها و مقادیر، تصویرهای مشترکی دارند یا خیر (مانند Grouped-Query Attention ،Multi-Query Attention و Multi-head Latent Attention).
مفهوم
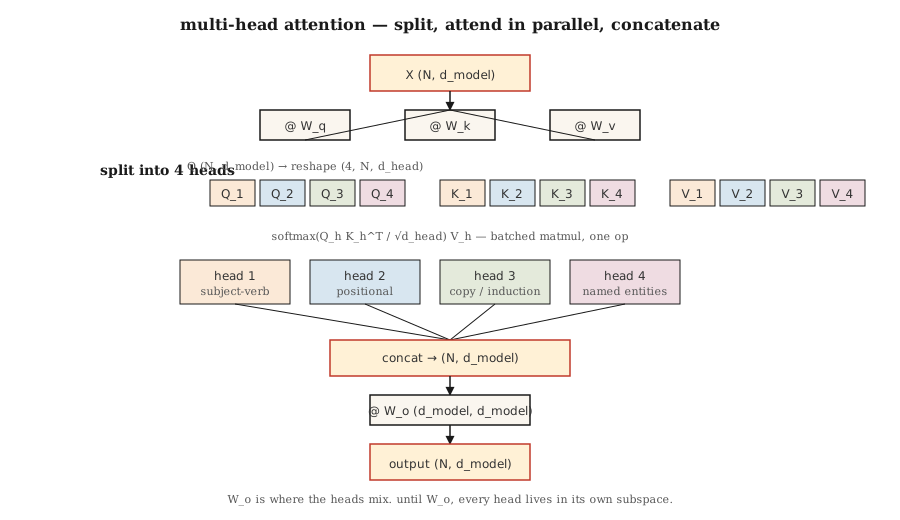
تقسیم (Split). ماتریس X با ابعاد (N, d_model) را در نظر بگیرید. آن را روی Q، K و V تصویر کنید تا هرکدام به ابعاد (N, d_model) برسند. ابعاد را به (N, n_heads, d_head) بازآرایی (reshape) کنید؛ جایی که . سپس آن را به شکل (n_heads, N, d_head) ترانهاده (transpose) کنید.
اجرای موازی اتنشن (Attend in parallel). اتنشن ضربداخلی مقیاسشده (scaled dot-product attention) را درون هر سر اجرا کنید. هر سر خروجی با ابعاد (N, d_head) تولید میکند. این سرها روی زیرفضاهای متفاوتی از امبدینگ کار میکنند و در طول محاسبهی خود اتنشن، هیچ تبادل دادهای با یکدیگر ندارند.
الحاق و تصویر کردن (Concatenate and project). سرها را دوباره کنار هم بگذارید تا به ابعاد (N, d_model) برسید و آن را در ماتریس خروجی آموزشپذیر W_o با ابعاد (d_model, d_model) ضرب کنید. W_o دقیقاً همان جایی است که خروجی سرها با هم ترکیب میشوند.
چرا کار میکند؟ هر سر میتواند بدون رقابت با بقیهی سرها بر سر ظرفیت بازنمایی، روی یک الگوی خاص متمرکز و تخصصی شود. پژوهشهای کاوشگرانه (probing) در فاصلهی سالهای 2019 تا 2024 نقشهای مشخصی را برای سرها نشان دادهاند: سرهای مکانی، سری که به توکن قبلی نگاه میکند، سرهای کپی، سرهای موجودیت نامدار و سرهای القا یا اینداکشن (که زیربنای یادگیری درونمتنی یا in-context learning هستند).
تغییرات ساختاری در سال 2026:
| گونه | سرهای Q | سرهای K/V | موارد استفاده |
|---|---|---|---|
| چندسر (MHA) | N | N | مدلهای GPT-2 ،BERT ،T5 |
| چندپرسوجو (MQA) | N | 1 | مدلهای PaLM ،Falcon |
| پرسوجوی گروهبندیشده (GQA) | N | G (مثلاً N/8) | مدلهای Llama 2 70B ،Llama 3+ ،Qwen 2+ ،Mistral |
| چندسر نهفته (MLA) | N | فشردهشده به رتبهی پایین | مدلهای DeepSeek-V2 ،V3 |
رویکرد GQA امروزه ساختار پیشفرض است؛ چون مصرف حافظهی کشِ کلید-مقدار (KV-cache) را با ضریب کاهش میدهد و در عین حال کیفیت مدل را تقریباً کامل حفظ میکند. معماری MLA پا را فراتر میگذارد: K و V را در یک فضای نهفته (latent space) فشرده میکند و هنگام محاسبه، دوباره آنها را تصویر میکند؛ کاری که FLOPs بیشتری مصرف میکند، اما حافظهی به مراتب کمتری میگیرد.
پیادهسازی
گام 1: تفکیک سرها از اتنشن تکسری که قبلاً ساخته بودیم
کلاس SelfAttention درس 02 را بردارید و یک جفت عملیات split/concat دور آن قرار دهید. پیادهسازی با numpy را در فایل code/main.py ببینید؛ منطق کار به این ترتیب است:
def split_heads(X, n_heads):
    n, d = X.shape
    d_head = d // n_heads
    return X.reshape(n, n_heads, d_head).transpose(1, 0, 2)  # (heads, n, d_head)

def combine_heads(H):
    h, n, d_head = H.shape
    return H.transpose(1, 0, 2).reshape(n, h * d_head)
فقط یک reshape و یک transpose. هیچ حلقهای در کار نیست. این دقیقاً همان کاری است که PyTorch درون nn.MultiheadAttention انجام میدهد.
گام 2: اجرای اتنشن ضربداخلی مقیاسشده به ازای هر سر
هر سر برش اختصاصی خود را از Q و K و V دریافت میکند. عملیات اتنشن به یک ضرب ماتریسی دستهای (batched matmul) تبدیل میشود:
def mha_forward(X, W_q, W_k, W_v, W_o, n_heads):
    Q = X @ W_q
    K = X @ W_k
    V = X @ W_v
    Qh = split_heads(Q, n_heads)         # (heads, n, d_head)
    Kh = split_heads(K, n_heads)
    Vh = split_heads(V, n_heads)
    scores = Qh @ Kh.transpose(0, 2, 1) / np.sqrt(Qh.shape[-1])
    weights = softmax(scores, axis=-1)
    out = weights @ Vh                    # (heads, n, d_head)
    concat = combine_heads(out)
    return concat @ W_o, weights
روی سختافزار واقعی، عبارت Qh @ Kh.transpose(...) یک عملیات bmm است. پردازندهی گرافیکی یک ضرب ماتریسی دستهای را با ابعاد (heads, N, d_head) × (heads, d_head, N) -> (heads, N, N) اجرا میکند. بنابراین اضافه کردن سرها هیچ هزینهی اضافی ندارد.
گام 3: ساختار پرسوجوی گروهبندیشده (GQA)
تنها تصویر کردن کلیدها و مقادیر تغییر میکند. ماتریس Q به n_heads گروه تقسیم میشود؛ اما K و V به n_kv_heads < n_heads گروه تقسیم میشوند و برای هماهنگی با ابعاد Q، تکرار میشوند:
def gqa_project(X, W, n_kv_heads, n_heads):
    kv = split_heads(X @ W, n_kv_heads)       # (kv_heads, n, d_head)
    repeat = n_heads // n_kv_heads
    return np.repeat(kv, repeat, axis=0)      # (n_heads, n, d_head)
این کار در زمان استنتاج (inference) باعث صرفهجویی چشمگیر در حافظه میشود؛ چون فقط n_kv_heads نسخه در KV-cache نگهداری میشوند، نه n_heads نسخه. به عنوان مثال، مدل Llama 3 70B از 64 سر پرسوجو به همراه 8 سر KV استفاده میکند؛ یعنی کش 8 برابر کوچکتر میشود.
گام 4: کاوش آنچه هر سر یاد گرفته است
اتنشن چندسر را با 4 سر روی یک جملهی کوتاه اجرا کنید. برای هر سر، ماتریس اتنشن با ابعاد (N, N) را چاپ کنید. حتی با وزنهای اولیهی تصادفی هم خواهید دید که سرهای مختلف ساختارهای متفاوتی را استخراج میکنند؛ این رفتار بخشی به خاطر خود سیگنال است و بخشی هم به خاطر تقارن چرخشی در زیرفضاها.
استفادهی عملی
پیادهسازی یکخطی در PyTorch:
import torch.nn as nn

mha = nn.MultiheadAttention(embed_dim=512, num_heads=8, batch_first=True)
استفاده از GQA در نسخههای PyTorch 2.5 به بعد:
from torch.nn.functional import scaled_dot_product_attention
# تابع scaled_dot_product_attention به طور خودکار Flash Attention را روی CUDA فراخوانی میکند.
# برای GQA، مقدار Q را با ابعاد (B, n_heads, N, d_head) و K,V را با ابعاد
# (B, n_kv_heads, N, d_head) ارسال کنید. PyTorch تکرار را مدیریت میکند.
out = scaled_dot_product_attention(q, k, v, is_causal=True, enable_gqa=True)چند سر اتنشن لازم است؟ قواعد تجربی مدلهای عملیاتی در سال 2026:
| اندازهی مدل | d_model | n_heads | d_head |
|---|---|---|---|
| کوچک (~125M) | 768 | 12 | 64 |
| پایه (~350M) | 1024 | 16 | 64 |
| بزرگ (~1B) | 2048 | 16 | 128 |
| مرزی (~70B) | 8192 | 64 | 128 |
مقدار d_head تقریباً همیشه روی 64 یا 128 قرار میگیرد. این مقدار واحدی است که نشان میدهد هر سر چقدر میتواند «ببیند». اگر آن را به کمتر از 32 برسانید، سرها با فاکتور مقیاسبندی دچار تداخل میشوند؛ و اگر بالاتر از 256 ببرید، مزیت «متخصصهای کوچک متعدد» را از دست میدهید.
تحویل به محیط عملیاتی
فایل outputs/skill-mha-configurator.md را ببینید. این ابزار بر اساس بودجهی پارامتر، طول توالی و مقصد استقرار، تعداد سرها، تعداد سرهای kv و استراتژی تصویر کردن مناسب را برای یک ترنسفورمر جدید پیشنهاد میدهد.
تمرینها
- ساده. پیادهسازی MHA را از فایل
code/main.pyبردارید و با ثابت نگهداشتنd_model=64، مقدارn_headsرا از 1 تا 16 تغییر دهید. نمودار تابع زیان یک مدل کوچک تکلایه را روی یک تسک شبیهسازیشدهی کپی رسم کنید. آیا افزایش تعداد سرها کمکی میکند، عملکرد را ثابت نگه میدارد، یا به آن آسیب میزند؟ - متوسط. ساختار MQA را پیادهسازی کنید (یک سر KV مشترک بین همهی سرهای پرسوجو). کاهش تعداد پارامترها را در مقایسه با MHA کامل اندازه بگیرید. محاسبه کنید که به ازای N=2048، حجم KV-cache در زمان استنتاج چقدر کوچکتر میشود.
- سخت. نسخهی کوچکی از اتنشن چندسر نهفته (MLA) را پیادهسازی کنید: K و V را به یک متغیر نهفته با رتبه (rank) برابر با
rفشرده کنید، آن متغیر نهفته را در KV-cache ذخیره نمایید و در لحظهی اجرای اتنشن از حالت فشرده خارج کنید. در چه مقداری ازrحجم حافظهی کش به کمتر از 1/8 اتنشن کامل (MHA) میرسد، در حالی که کیفیت خروجی در محدودهی 1 بیت از پرپلکسیتی (perplexity) اعتبارسنجی باقی بماند؟
اصطلاحات کلیدی
| اصطلاح | در گفتار عمومی | مفهوم دقیق فنی |
|---|---|---|
| سر (Head) | «یک مدار اتنشن منفرد» | یک تصویر کردن Q/K/V با بُعد به همراه ماتریس اتنشن اختصاصی خودش. |
| d_head | «بُعد سر» | پهنای لایهی پنهان به ازای هر سر؛ در محیط عملیاتی تقریباً همیشه 64 یا 128 است. |
| تفکیک / ترکیب (Split / combine) | «ترفندهای تغییر ابعاد» | تبدیل ابعاد و ترانهادهی (N, d_model) ↔ (n_heads, N, d_head) در اطراف محاسبهی اتنشن. |
| W_o | «تصویر خروجی» | ماتریس (d_model, d_model) که پس از الحاق سرها اعمال میشود؛ جایی که سرها با هم ترکیب میشوند. |
| MQA | «تکسر KV» | اتنشن چندپرسوجو (Multi-Query Attention): یک تصویر K/V مشترک. کمترین حجم KV-cache، همراه با مقداری افت کیفیت. |
| GQA | «پیشفرض از زمان Llama 2» | اتنشن پرسوجوی گروهبندیشده (Grouped-Query Attention) با n_kv_heads < n_heads؛ با تکرار به ابعاد Q میرسد. |
| MLA | «ترفند DeepSeek» | اتنشن چندسر نهفته (Multi-head Latent Attention): فشردهسازی K و V به یک متغیر نهفته با رتبهی پایین و بازیابی در زمان اجرای اتنشن. |
| سر القا یا اینداکشن (Induction head) | «مدار پشت یادگیری درونمتنی» | جفتسری که رخدادهای قبلی را تشخیص میدهد و مواردی را که پس از آنها آمده کپی میکند. |
برای مطالعهی بیشتر
- Vaswani et al. (2017). Attention Is All You Need §3.2.2 — مشخصات اصلی اتنشن چندسر.
- Shazeer (2019). Fast Transformer Decoding: One Write-Head is All You Need — مقالهی معرفی MQA.
- Ainslie et al. (2023). GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints — نحوهی تبدیل MHA به GQA پس از آموزش از روی چکپوینت (checkpoint).
- DeepSeek-AI (2024). DeepSeek-V2 Technical Report — ساختار MLA و دلایل برتری آن بر MHA/GQA در مصرف حافظهی کش.
- Olsson et al. (2022). In-context Learning and Induction Heads — نگاهی مکانیکی به کاری که سرها دقیقاً انجام میدهند.