
اگر تا به حال برایتان سوال بوده که چطور یک مدل هوش مصنوعی میتواند متنی منسجم و کلمهبهکلمه تولید کند، پاسخ در سازوکاری به نام مدلسازی علّی زبان (Causal Language Modeling) نهفته است. در حالی که مدلهایی مانند BERT با دیدن همزمان گذشته و آینده فقط برای تحلیل متن مناسبند، خانوادهی مدلهای GPT با تکیه بر ایدهی پیشبینی توکن بعدی و یک ماسک ماتریسی ساده توانستهاند پایهی تمام ابزارهای تولید متن مدرن را شکل دهند.
درک معماری دیکودرمحور (decoder-only) و شیوهی کارکرد ماسک مثلثی به شما دیدی شفاف از پشتصحنهی پردازش در LLMها میدهد. این مفاهیم نهتنها تفاوت میان آموزش کاملاً موازی و استنتاج ترتیبی توکنبهتوکن را روشن میکنند، بلکه استراتژیهای کلیدی دیکودینگ مانند Temperature، Top-p و Min-p را معرفی میکنند؛ پارامترهایی که مستقیماً بر کیفیت و خلاقیت خروجی مدلها در سناریوهای واقعی اثر دارند.
مدل BERT هر دو طرف را میبیند؛ GPT فقط گذشته را میبیند. این ماسک مثلثی، سرنوشتسازترین تکخط کد در هوش مصنوعی مدرن است.
صورت مسئله
یک مدل زبانی فقط به یک پرسش پاسخ میدهد: با داشتن t-1 توکن اول، توزیع احتمال روی توکن t چیست؟ مدل را روی همین سیگنال آموزش دهید — یعنی پیشبینی توکن بعدی (next-token prediction) — تا مدلی به دست آورید که میتواند متنی دلخواه را توکنبهتوکن تولید کند.
برای اینکه بتوانید مدل را بهصورت سرتاسری (end-to-end) و موازی روی کل یک دنباله آموزش دهید، پیشبینی هر موقعیت باید فقط به موقعیتهای قبلی وابسته باشد؛ وگرنه مدل با نگاهکردن به جواب، خیلی ساده تقلب میکند.
ماسک علّی (causal mask) همین کار را انجام میدهد: یک ماتریس بالامثلثی از مقادیر inf- که قبل از سافتمکس (softmax) به امتیازهای اتنشن (attention) اضافه میشود. بعد از سافتمکس، وزن آن موقعیتها صفر میشود. در نتیجه هر موقعیت فقط میتواند به خودش و موقعیتهای پیش از خودش اتنشن داشته باشد. از آنجا که این ماسک را یکبار روی کل دنباله اعمال میکنید، در یک گذر رو به جلو (forward pass) به N پیشبینی موازی برای توکنهای بعدی میرسید.
مدلهای GPT-1 (2018)، GPT-2 (2019)، GPT-3 (2020)، GPT-4 (2023)، GPT-5 (2025)، Claude، Llama، Qwen، Mistral، DeepSeek و Kimi همگی ترنسفورمرهای (transformer) علّیِ فقط دیکودر (decoder-only) با یک حلقهی اصلیِ یکسان هستند. چیزی که آنها را از هم متمایز میکند کیفیت دادهها، مقیاس و بهبودهای جزئی معماری، و پسآموزش (شامل SFT، RLHF، DPO و ادامهدهندگان آنها) است.
مفاهیم کلیدی
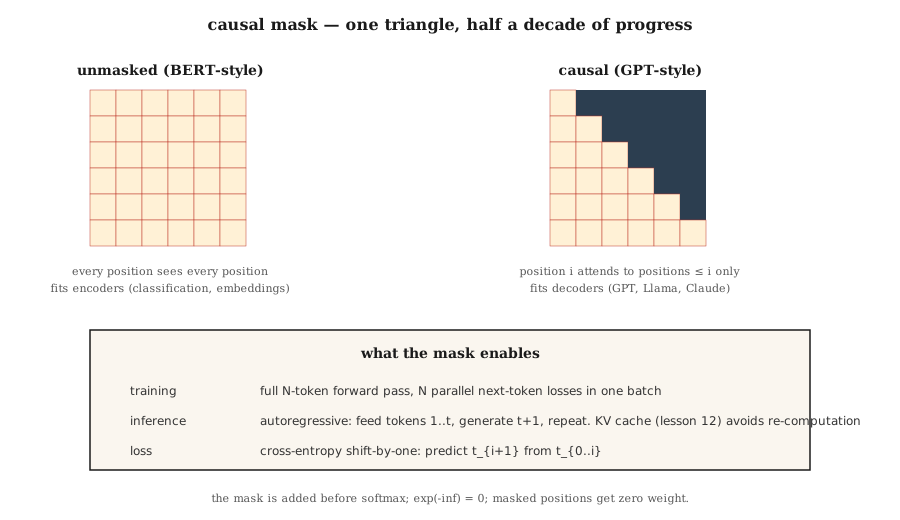
ماسک علّی
برای دنبالهای با طول ، یک ماتریس بسازید:
ماتریس M را قبل از سافتمکس به امتیازهای خام اتنشن اضافه کنید. چون ، موقعیتهای ماسکشده وزنی معادل صفر میگیرند. حالا هر سطر از ماتریس اتنشن، یک توزیع احتمال فقط روی موقعیتهای پیشین است.
هزینهی پیادهسازی: فقط یک فراخوانی torch.tril(). زمان محاسبه: در حد نانوثانیه. تأثیرش روی این حوزه: دگرگونی همهچیز.
این مثلث از کجا میآید؟
معمولاً ماسک را طوری نشان میدهند که انگار وصلهای پیوندخورده به اتنشن است. اگر روند استخراج فرمول را برعکس طی کنید، دیگر رازآلود به نظر نمیرسد: اتنشن در واقع سومین مرحلهی پالایشِ یک «میانگین پیشوندی» (prefix average) است و این مثلث، همان حدود حلقهی آن میانگینگیری است که در قالب یک ماتریس نوشته شده است.
مرحلهی 1 — میانگین پیشوندی. سادهترین خلاصهی علّی از یک دنباله: موقعیت میانگین موقعیتهای میشود. در قالب حلقه، میشود: out[i] = X[:i+1].mean(0). همین محاسبه را میتوان با یک ضرب ماتریسی انجام داد. یک ماتریس پایینمثلثی از عدد یک بردارید، هر سطر را بر تعداد عناصرش تقسیم کنید و ضرب را انجام دهید:
import numpy as np

A = np.tril(np.ones((n, n)))
A = A / A.sum(axis=1, keepdims=True)
out = A @ X
سطر از برابر با است. صفرهای بالای قطر اصلی، همان علّیت هستند. قرار نبود چیزی از آینده ماسک شود؛ آینده اصلاً در این جمع حضور نداشت.
مرحلهی 2 — وزنهای یادگرفتنی. یک میانگین ساده و یکنواخت با همهی توکنهای گذشته طوری رفتار میکند که انگار اهمیت یکسانی دارند. اعداد یک را با یک ماتریس امتیاز یادگرفتنی به نام S جایگزین کنید. حالا دیگر مجموع سطرها بر حسب ساختار برابر با یک نمیشود؛ پس بهجای تقسیم بر تعداد، هر سطر را با سافتمکس نرمال کنید. خروجی سافتمکس هیچوقت دقیقاً صفر نمیشود و این رابطهی علّی را نقض میکند — مگر اینکه امتیازهای آینده با inf- وارد شوند، چون exp(-inf) = 0:
def softmax(x, axis):
    e = np.exp(x - np.max(x, axis=axis, keepdims=True))
    return e / e.sum(axis=axis, keepdims=True)

S = S + np.triu(np.full((n, n), -np.inf), k=1)
A = softmax(S, axis=1)
out = A @ X
همان مثلث، همان ماتریس تصادفی سطری (row-stochastic)، و همان یک ضرب ماتریسی. ماسک inf- سازوکار تازهای نیست؛ همان درایههای صفر مرحلهی 1 است که به دامنهی ورودی سافتمکس منتقل شده است.
مرحلهی 3 — وزنهای وابسته به محتوا. در مرحلهی 2، ماتریس S بعد از آموزش ثابت میماند: موقعیت 7 همیشه به موقعیت 3 وزن یکسانی میدهد، صرفنظر از اینکه توکنها چه باشند. حالا بگذارید امتیازها به خود توکنها وابسته باشند: S = Q @ K.T / sqrt(d_k). هیچچیز دیگری تغییر نمیکند: ماسک، سافتمکس و ضرب ماتریسی دقیقاً همانند.
سه مرحله، با یک ویژگیِ پایدار: ضرب یک ماتریس پایینمثلثی تصادفی سطری در دنباله. میانگین یکنواخت، وزنهای ایستای یادگرفتنی، و وزنهای وابسته به محتوا. این ماسک هرگز به اتنشن افزوده نشد؛ بلکه از همان میانگینگیری اولیه به یادگار ماند.
آموزش موازی، استنتاج ترتیبی
آموزش: کل دنبالهی (N, d_model) را یکبار از گذر رو به جلو عبور دهید، N تابع زیان (loss) آنتروپی متقاطع (یکی برای هر موقعیت) حساب کنید، آنها را جمع بزنید و پسانتشار (backprop) را انجام دهید. این کار در راستای دنباله کاملاً موازی انجام میشود. علت مقیاسپذیری آموزش GPT همین است: 1M توکن را در قالب یک بچ و در یک گذر از GPU پردازش میکنید.
استنتاج: تولید متن، توکنبهتوکن انجام میشود. [t1, t2, t3] را بدهید، t4 را بگیرید. [t1, t2, t3, t4] را بدهید، t5 را بگیرید. [t1, t2, t3, t4, t5] را بدهید، t6 را بگیرید. کش KV (درس 12) وضعیتهای پنهان (hidden states) توکنهای t1…tn را ذخیره میکند تا مجبور نباشید آنها را در هر گام دوباره حساب کنید. با این حال، عمق پردازش ترتیبی در زمان استنتاج دقیقاً برابر با طول خروجی است. این همان مالیات خودبازگشتی (autoregressive tax) است؛ به همین دلیل مرحلهی دیکود کردن، گلوگاه تاخیر (latency) در تمام LLMها محسوب میشود.
تابع زیان — جابهجایی با یک گام
با داشتن توکنهای [t1, t2, t3, t4]:
- ورودی:
[t1, t2, t3] - هدفها (Targets):
[t2, t3, t4]
برای هر موقعیت i، مقدار ([log P(target_i | inputs[:i+1- را حساب کنید. مجموع آنها آنتروپی متقاطع کل دنباله است.
تمام مدلهای زبانی ترنسفورمری که نامشان را شنیدهاید با همین تابع زیان آموزش میبینند. پیشآموزش، فاینتیونینگ و SFT همگی از همین زیان استفاده میکنند و فقط دادههایشان فرق دارد.
استراتژیهای دیکود کردن
بعد از اتمام آموزش، شیوهی نمونهبرداری (sampling) بسیار مهمتر از آن چیزی است که به نظر میرسد.
| روش | عملکرد | زمان استفاده |
|---|---|---|
| حریصانه (Greedy) | انتخاب Argmax در هر گام | کارهای قطعی، تکمیل کد |
| دما (Temperature) | تقسیم لاجیتها بر T و سپس نمونهبرداری | کارهای خلاقانه؛ T بالاتر یعنی تنوع بیشتر |
| Top-k | نمونهبرداری فقط از بین k توکن برتر | حذف دنبالههای کماحتمال |
| Top-p (هستهای) | نمونهبرداری از کوچکترین مجموعهای با احتمال تجمعی p ≤ | حالت پیشفرض از سال 2020 به بعد؛ سازگار با شکل توزیع |
| Min-p | نگهداشتن توکنهایی با شرط p > min_p * max_p |
از سال 2024 به بعد؛ عملکرد بهتر از top-p در رد کردن دنبالههای انتهایی |
| دیکودینگ حدسی (Speculative decoding) | مدل پیشنویس N توکن پیشنهاد میدهد و مدل بزرگ آنها را تایید میکند | کاهش 2 تا 3 برابری تاخیر با حفظ همان کیفیت |
در سال 2026، ترکیب min-p با دمای 0.7 یک گزینهی پیشفرض و منطقی برای مدلهای با وزن باز (open-weights) است. استفاده از دیکودینگ حدسی هم پیشنیاز بدیهی هر زیرساخت استنتاج در محیط پروداکشن به شمار میرود.
رمز موفقیت فرمول GPT چه بود؟
- فقط دیکودر (Decoder-only): بدون سربار انکودر. فقط یک گذر اتنشن به اضافهی FFN در هر لایه.
- مقیاسپذیری: از 124M به 1.5B، سپس 175B و بعد به چند تریلیون پارامتر رسید. قوانین مقیاسپذیری چینچیلا (Chinchilla، درس 13) تعیین میکنند توان محاسباتی را چطور خرج کنید.
- یادگیری در پرامپت (In-context learning): این توانایی حوالی مقیاس 6B تا 13B پدیدار شد؛ مدل بدون نیاز به فاینتیونینگ میتواند از چند مثال درون پرامپت یاد بگیرد.
- روش RLHF: پسآموزش روی ترجیحات انسانی، متنهای خام و آموزشدیده را به دستیارهای گفتگو تبدیل کرد.
- بهکارگیری Pre-norm ،RoPE و SwiGLU: آموزش پایدار در مقیاسهای بزرگ.
معماری اصلی از زمان GPT-2 تغییر چندانی نکرده است. تمام اتفاقات جذاب در حوزهی داده، مقیاس و پسآموزش رخ دادهاند.
پیادهسازی از صفر
گام 1: ماسک علّی
فایل code/main.py را ببینید. کل ماجرا در یک خط خلاصه میشود:
def causal_mask(n):
    return [[0.0 if j <= i else float("-inf") for j in range(n)] for i in range(n)]
کافی است قبل از سافتمکس، آن را به امتیازهای اتنشن اضافه کنید. کل سازوکار همین است.
گام 2: یک مدل شبیه به GPT با 2 لایه
دو بلوک دیکودر (اتنشن خودکار ماسکشده به اضافهی FFN، بدون کراساتنشن) را روی هم قرار دهید. یک امبدینگ (embedding) توکن، یک کدگذاری مکانی (positional encoding)، و یک لایهی unembedding اضافه کنید (که با ماتریس امبدینگ توکن گره خورده است — ترفندی استاندارد از زمان GPT-2).
گام 3: پیشبینی سرتاسری توکن بعدی
روی یک مجموعهواژگان آزمایشی با 20 توکن، لاجیتها (logits) را در تمام موقعیتها تولید کنید. تابع زیان آنتروپی متقاطع را در برابر هدفی که یک گام جابهجا شده حساب کنید. نیازی به محاسبهی گرادیان نیست؛ این صرفاً یک بررسی اولیهی گذر رو به جلو است.
گام 4: نمونهبرداری
روشهای حریصانه، دما، top-k ،top-p و min-p را پیادهسازی کنید. هر کدام را روی یک پرامپت ثابت اجرا کرده و خروجیها را با هم مقایسه کنید. یک تابع نمونهبرداری بیشتر از 10 خط نیست.
استفاده از ابزارهای واقعی
سبک رایج PyTorch در سال 2026:
from transformers import AutoModelForCausalLM, AutoTokenizer
model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-3.2-3B-Instruct")
tok = AutoTokenizer.from_pretrained("meta-llama/Llama-3.2-3B-Instruct")

prompt = "Attention is all you need because"
inputs = tok(prompt, return_tensors="pt")
out = model.generate(
    **inputs,
    max_new_tokens=64,
    temperature=0.7,
    top_p=0.9,
    do_sample=True,
)
print(tok.decode(out[0]))
در لایههای زیرین، متد generate() گذر رو به جلو را اجرا میکند، لاجیتهای موقعیت آخر را برمیدارد، توکن بعدی را نمونهبرداری میکند، آن را به دنباله میافزاید و این فرایند را تکرار میکند. تمام پشتههای استنتاج عملیاتی LLM (مثل vLLM، TensorRT-LLM، llama.cpp، Ollama و MLX) همین حلقه را با بهینهسازیهای سنگین پیاده میکنند — از جمله پیشپر کردن دستهای (batched prefill)، دستهبندی پیوسته (continuous batching)، صفحهبندی کش KV و دیکودینگ حدسی.
تفاوت GPT و BERT در یک خط: GPT مقدار را پیشبینی میکند؛ BERT مقدار را پیشبینی میکند. همین تابع زیان تعیین میکند که مدل توانایی تولید متن را دارد یا خیر.
خروجی این درس
فایل outputs/skill-sampling-tuner.md را بررسی کنید. این مهارت پارامترهای مناسب نمونهبرداری را برای کارهای جدید تولید متن انتخاب میکند و زمانهایی را که نیاز به دیکود کردن قطعی است پرچمگذاری میکند.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید و مطمئن شوید ماتریس اتنشن علّی بعد از سافتمکس حتماً پایینمثلثی است. برای نمونه بررسی کنید: سطر 3 باید فقط در ستونهای 0 تا 3 وزن داشته باشد. - متوسط. جستجوی پرتو (beam search) را با عرض 4 پیادهسازی کنید. پرپلکسیتی (perplexity) جستجوی پرتو با عرض 4 را با روش حریصانه روی 10 پرامپت کوتاه مقایسه کنید. آیا جستجوی پرتو همیشه برنده است؟ (راهنمایی: معمولاً در ترجمه برنده است، اما در چتهای آزاد اینطور نیست.)
- سخت. دیکودینگ حدسی را پیادهسازی کنید: از یک مدل کوچک 2 لایه به عنوان مدل پیشنویس و از مدلی 6 لایه به عنوان مدل تاییدکننده استفاده کنید. میزان شتاب زمانی واقعی (wall-clock speedup) را روی 100 خروجی با طول 64 اندازه بگیرید. تایید کنید که خروجیها دقیقاً با روش حریصانهی مدل تاییدکننده یکسان هستند.
اصطلاحات کلیدی
| اصطلاح | آنچه گفته میشود | معنای واقعی آن |
|---|---|---|
| ماسک علّی (Causal mask) | «همان مثلث» | ماتریس بالامثلثی از inf- که به امتیازهای اتنشن اضافه میشود تا موقعیت i فقط موقعیتهای i ≥ را ببیند. |
| پیشبینی توکن بعدی (Next-token prediction) | «تابع زیان» | آنتروپی متقاطع میان توزیع مدل و توکن واقعیِ بعدی در تکتک موقعیتها. |
| خودبازگشتی (Autoregressive) | «تولید یکییکی» | فرستادن دوبارهی خروجی به عنوان ورودی؛ پردازش موازی فقط در آموزش وجود دارد، نه هنگام تولید متن. |
| لاجیتها (Logits) | «امتیازهای قبل از سافتمکس» | خروجی خام سر (head) مدل زبانی قبل از سافتمکس؛ نمونهبرداری روی همین مقادیر انجام میشود. |
| دما (Temperature) | «پیچ تنظیم خلاقیت» | تقسیم لاجیتها بر ؛ مقدار حالت حریصانه است و توزیع یکنواخت میسازد. |
| Top-p | «نمونهبرداری هستهای» | محدود کردن توزیع به کوچکترین مجموعهای که جمع آن به برسد؛ سپس نمونهبرداری از میان باقیماندهها. |
| Min-p | «بهتر از top-p» | نگهداشتن توکنهایی با شرط p ≥ min_p × max_p؛ آستانهی برش را با میزان تیزی توزیع تطبیق میدهد. |
| دیکودینگ حدسی (Speculative decoding) | «پیشنویس + تایید» | مدل سبک چند توکن پیشنهاد میدهد؛ مدل بزرگ آنها را بهطور موازی ارزیابی و تایید میکند. |
| وادارسازی معلم (Teacher forcing) | «ترفند آموزشی» | در زمان آموزش، توکن واقعی قبلی به عنوان ورودی داده میشود، نه پیشبینیِ خود مدل؛ استانداردی ثابت در تمام مدلهای seq2seq. |
برای مطالعهی بیشتر
- Radford et al. (2018). Improving Language Understanding by Generative Pre-Training — مقالهی GPT-1.
- Radford et al. (2019). Language Models are Unsupervised Multitask Learners — مقالهی GPT-2.
- Brown et al. (2020). Language Models are Few-Shot Learners — مقالهی GPT-3 و یادگیری در پرامپت.
- Leviathan, Kalman, Matias (2023). Fast Inference from Transformers via Speculative Decoding — مقالهی دیکودینگ حدسی.
- HuggingFace
modeling_llama.py— کد مرجع و استاندارد مدلهای علّی.