
برای سالها شبکههای عصبی کانولوشنی (CNN) انتخاب بیچونوچرای تمام مسائل بینایی ماشین بودند، در حالی که ترنسفورمرها بر پردازش زبان طبیعی حکمرانی میکردند. معرفی مدل ترنسفورمر بینایی (Vision Transformer یا ViT) این مرزبندی را شکست و نشان داد که با تبدیل تصویر به تکههای مسطح (Patches) و تلقی آنها بهعنوان توکن، میتوان تصاویر را به همان انکودر استاندارد ترنسفورمر سپرد.
درک معماری ViT و سیر تکامل آن تا مدلهای قدرتمندی مثل DINOv2 و Swin، برای هر متخصص یادگیری ماشین ضروری است؛ زیرا امروزه خط لولههای پیشرفته بینایی و چندوجهی (Multimodal) بر پایهی همین ساختار شکل گرفتهاند. با این حال، آموزش مدلهای ViT از صفر به داده و توان پردازشی بسیار سنگینی نیاز دارد که تهیه و اجاره GPU برای آن دشوار و پرهزینه است.
به همین دلیل، در این درس به جای وابستگی به پردازشهای سنگین، ساختار درونی ViT و فرآیند تکهتکه کردن تصویر را از پایه با پایتون خالص پیادهسازی میکنیم. سپس راهکارهای عملی دنیای واقعی مانند استفاده از مدلهای ازپیشآموزشدیده (Pretrained) برای استخراج ویژگی روی سیستم شخصی را بررسی خواهیم کرد.
تصویر شبکهای از تکههاست. جمله شبکهای از توکنهاست. همان ترنسفورمر هر دو را پردازش میکند.
صورت مسئله
پیش از سال 2020، بینایی ماشین یعنی کانولوشن. تمام مدلهای پیشرو (SOTA) روی ImageNet، COCO و بنچمارکهای تشخیص شیء از بکبونِ CNN استفاده میکردند. ترنسفورمرها فقط مخصوص زبان بودند.
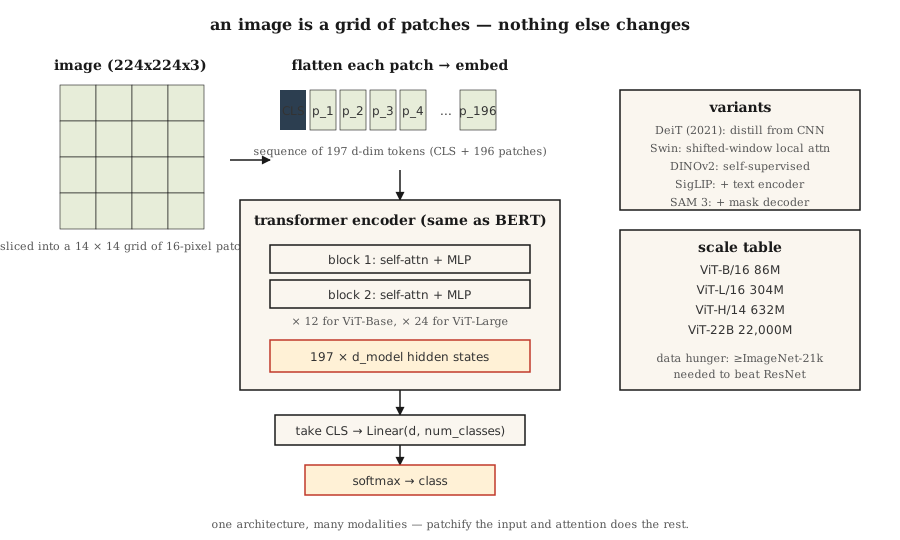
دوسوویتسکی و همکاران (2020) در مقالهی «ارزش یک تصویر برابر 16×16 کلمه است» نشان دادند که میتوانید کانولوشنها را کاملاً کنار بگذارید: تصویر را به تکههایی (patches) با اندازهی ثابت برش بزنید، هر تکه را با یک نگاشت خطی به امبدینگ تبدیل کنید و این توالی را به یک انکودر ترنسفورمر استاندارد بدهید. با مقیاس دادهی کافی در پیشآموزش (روی ImageNet-21k یا بزرگتر)، ViT به مدلهای مبتنی بر ResNet میرسد یا از آنها جلو میزند.
مدل ViT سرآغاز یک الگوی فراگیرتر در سال 2026 بود: یک معماری واحد، چندین مدالیتهی مختلف. مدل Whisper صدا را توکنایز میکند، ViT تصویر را توکنایز میکند، توکنهای کنش برای رباتیک استفاده میشوند و توکنهای پیکسلی برای ویدیو. برای ترنسفورمر فرقی نمیکند؛ یک توالی به آن بدهید تا یاد بگیرد.
تا سال 2026، مدل ViT و نسل بعدی آن (DeiT، Swin، DINOv2، ViT-22B و SAM 3) بخش عمدهی بینایی ماشین را تصاحب کردهاند. CNNها هنوز روی دستگاههای لبه (edge) و کارهای حساس به تاخیر برتری دارند؛ اما در بقیهی حوزهها، حتماً پای یک ViT در میان است.
مفهوم
گام 1 — تکهتکه کردن (patchify)
یک تصویر H × W × C را به توالی مسطحی از تکهها با ابعاد N × (P·P·C) تبدیل کنید. ساختار متداول: تصویر 224 × 224 با تکههای 16 × 16؛ یعنی 196 تکه که هر کدام 768 مقدار دارند.
image (224, 224, 3) → 14 × 14 grid of 16x16x3 patches → 196 vectors of length 768اندازهی تکه اهرم اصلی تنظیم است. تکههای کوچکتر یعنی توکنهای بیشتر، رزولوشن بهتر و هزینهی اتنشن درجه دو. تکههای بزرگتر یعنی تصویری درشتتر و پردازشی سبکتر و ارزانتر.
گام 2 — امبدینگ خطی
یک ماتریس یادگیریپذیر واحد، هر تکهی مسطح را به d_model نگاشت میکند. این کار دقیقاً معادل یک کانولوشن با اندازهی کرنل P و استراید P است. در PyTorch این تبدیل عملاً با nn.Conv2d(C, d_model, kernel_size=P, stride=P) پیاده میشود؛ کلاً در دو خط کد.
گام 3 — افزودن توکن [CLS] و امبدینگهای مکانی
- یک توکن یادگیریپذیر
[CLS]به ابتدای توالی اضافه کنید. وضعیت پنهان نهایی این توکن، همان نمایش کلی تصویر است که برای کلاسیفیکیشن استفاده میشود. - امبدینگهای مکانی یادگیریپذیر (نسخهی اصلی ViT) یا سینوسی دوبعدی (نسخههای بعدی) را اضافه کنید.
- از سال 2024 به بعد، RoPE برای موقعیتهای دوبعدی تعمیم یافت و گاهی بدون نیاز به امبدینگ مکانیِ صریح به کار میرود.
گام 4 — انکودر استاندارد ترنسفورمر
چیدن L بلوک از LayerNorm → Self-Attention → + → LayerNorm → MLP → + روی یکدیگر. این ساختار دقیقاً مانند BERT است؛ بدون هیچ لایهی اختصاصی برای تصویر. نکتۀ طلایی و نبوغآمیز مقاله دقیقاً همینجاست.
گام 5 — سر (head)
برای کلاسیفیکیشن: وضعیت پنهان [CLS] را بردارید ← لایهی خطی ← سافتمکس. در DINOv2 یا SAM، توکن [CLS] را کنار بگذارید و مستقیماً از امبدینگ تکهها استفاده کنید.
نسخههای مهم
| مدل | سال | تغییرات |
|---|---|---|
| ViT | 2020 | نسخهی اصلی؛ اندازهی تکهی ثابت، اتنشن سراسری کامل. |
| DeiT | 2021 | تقطیر دانش؛ قابل آموزش فقط روی ImageNet-1k. |
| Swin | 2021 | سلسلهمراتبی با پنجرههای جابهجاشونده؛ حل مشکل هزینهی درجه دو. |
| DINOv2 | 2023 | خودنظارتی (بدون برچسب)؛ ارائهی بهترین ویژگیهای عمومی تصویر. |
| ViT-22B | 2023 | با 22 میلیارد پارامتر؛ نشان داد قوانین مقیاسپذیری برقرارند. |
| SigLIP | 2023 | زوج تصویر-متن با ViT و تابع زیان کنتراستیو سیگموئیدی. |
| SAM 3 | 2025 | بخشبندی همهچیز؛ ترکیب ViT-Large با دیکودر ماسک پرامپتپذیر. |
چرا پذیرش آن کمی طول کشید؟
مدل ViT برای رسیدن به عملکرد CNNها به دادهی بسیار زیادی نیاز دارد، چون هیچکدام از سوگیریهای استقرایی CNN (مانند ناورایی انتقال و موضعیبودن) را ندارد. بدون داشتن بیش از 100 میلیون تصویر برچسبدار یا پیشآموزش خودنظارتی قوی، با منابع محاسباتی برابر، هنوز CNNها برندهاند. DeiT در سال 2021 با ترفندهای تقطیر دانش این چالش را حل کرد و DINOv2 در سال 2023 با یادگیری خودنظارتی پروندهاش را برای همیشه بست.
پیادهسازی از صفر
کد code/main.py را ببینید. تکهتکه کردن، امبدینگ خطی و تستهای اعتبارسنجی را فقط با کتابخانهی استاندارد پایتون پیاده کردهایم. خبری از آموزش مدل نیست؛ آموزش ViT در هر مقیاس کاربردی نیاز به PyTorch و ساعتها پردازش GPU دارد.
گام 1: تصویر فرضی
یک تصویر رنگی (RGB) با ابعاد 24 × 24 به صورت فهرستی از سطرها شامل تاپلهای (R, G, B). از تکههای 6×6 استفاده میکنیم که حاصل آن 16 تکه است و هر تکه برداری 108 بعدی میسازد.
گام 2: تکهتکه کردن (patchify)
def patchify(image, P):
    H = len(image)
    W = len(image[0])
    patches = []
    for i in range(0, H, P):
        for j in range(0, W, P):
            patch = []
            for di in range(P):
                for dj in range(P):
                    patch.extend(image[i + di][j + dj])
            patches.append(patch)
    return patches
ترتیب پیمایش سطری (Raster order): سطربهسطر در سراسر شبکه. تمام نسخههای ViT از همین ترتیب استفاده میکنند.
گام 3: امبدینگ خطی
هر تکهی مسطح را در یک ماتریس تصادفی با ابعاد (patch_flat_size, d_model) ضرب کنید. مطمئن شوید بعد از اضافه کردن توکن [CLS] به ابتدا، ابعاد خروجی برابر (N_patches + 1, d_model) باشد.
گام 4: شمارش پارامترها برای یک ViT واقعی
تعداد پارامترهای ViT-Base را چاپ کنید: 12 لایه، 12 سر، d=768، ابعاد تکه 16. آن را با ResNet-50 (حدود 25 میلیون) مقایسه کنید. ViT-Base حدود 86 میلیون، ViT-Large حدود 307 میلیون و ViT-Huge حدود 632 میلیون پارامتر دارد.
استفاده از ابزارهای واقعی
from transformers import ViTImageProcessor, ViTModel
import torch
from PIL import Image

processor = ViTImageProcessor.from_pretrained("google/vit-base-patch16-224-in21k")
model = ViTModel.from_pretrained("google/vit-base-patch16-224-in21k")

img = Image.open("cat.jpg")
inputs = processor(img, return_tensors="pt")
out = model(**inputs).last_hidden_state   # (1, 197, 768): [CLS] + 196 patches
cls_emb = out[:, 0] # image representationامبدینگهای DINOv2 انتخاب پیشفرض سال 2026 برای استخراج ویژگیهای تصویرند. بکبون را ثابت (freeze) نگه دارید و یک سرِ کوچک آموزش دهید. برای کلاسیفیکیشن، بازیابی تصویر (retrieval)، تشخیص شیء و کپشننویسی عالی جواب میدهد. چکپوینتهای DINOv2 شرکت Meta در تمام تسکهای بینایی غیرمتنی از CLIP بهتر عمل میکنند.
انتخاب اندازهی تکه. مدلهای کوچک از 16×16 استفاده میکنند (ViT-B/16). برای پیشبینی متراکم (بخشبندی تصویر) از 8×8 یا 14×14 استفاده میشود (SAM، DINOv2). مدلهای بسیار بزرگ هم از 14×14 بهره میبرند.
خروجی این درس
فایل outputs/skill-vit-configurator.md را بررسی کنید. این ابزار بر اساس حجم دیتاست، رزولوشن و بودجهی محاسباتی، نسخهی مناسب ViT و اندازهی تکهی ایدهآل را برای تسک بینایی جدید شما تعیین میکند.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. مطمئن شوید تعداد تکهها با(H/P) * (W/P)و بعدِ هر تکهی مسطح باP*P*Cبرابر است. - متوسط. امبدینگهای مکانی سینوسی دوبعدی را بسازید؛ دو کدگذاری سینوسی مستقل برای
rowوcolهر تکه که به هم متصل (concatenate) شدهاند. آنها را به یک ViT کوچک در PyTorch بدهید و دقت آن را با امبدینگ مکانی یادگیریپذیر روی دیتاست CIFAR-10 مقایسه کنید. - سخت. یک ViT سهلایهای در PyTorch بسازید و با 1000 تصویر از MNIST با تکههای 4×4 آموزش دهید. دقت روی دادههای تست را اندازه بگیرید. حالا پیشآموزش DINOv2 را روی همان 1000 تصویر پیاده کنید (نسخهی سادهشده: فقط انکودر را طوری آموزش دهید که امبدینگ تکهها را از روی تکههای ماسکشده پیشبینی کند). آیا دقت نهایی بهتر میشود؟
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای دقیق فنی |
|---|---|---|
| Patch (تکه) | «توکن در ترنسفورمر بینایی» | بردار مسطحی از مقادیر پیکسل برای ناحیهای با ابعاد P × P × C از تصویر. |
| Patchify (تکهتکه کردن) | «برش زدن و تخت کردن» | تقسیم تصویر به تکههای غیرهمپوشان و مسطحسازی هر تکه به یک بردار. |
[CLS] token (توکن کلس) |
«خلاصهی تصویر» | توکن یادگیریپذیر در ابتدای توالی؛ وضعیت پنهان نهایی آن نمایش کل تصویر است. |
| Inductive bias (سوگیری استقرایی) | «فرضیات اولیهی مدل» | مدل ViT پیشینهای کمتری نسبت به CNN دارد؛ برای جبران این فاصله به دادهی بیشتری نیاز دارد. |
| DINOv2 | «ViT خودنظارتی» | مدلی آموزشدیده بدون برچسب با افزایش داده و مدل معلم با تکانه (momentum teacher)؛ بهترین ویژگیهای عمومی تصویر در سال 2026. |
| SigLIP | «جانشین CLIP» | ترکیب ViT و انکودر متن که با تابع زیان کنتراستیو سیگموئیدی آموزش دیده؛ در توان پردازشی یکسان از CLIP بهتر عمل میکند. |
| Swin | «ViT پنجرهای» | نوعی ViT سلسلهمراتبی با اتنشن محلی و پنجرههای جابهجاشونده؛ هزینهی محاسباتی آن کمتر از درجهدو است. |
| Register tokens (توکنهای رجیستر) | «ترفند سال 2023» | چند توکن یادگیریپذیر اضافه که چاههای اتنشن (attention sinks) را جذب میکنند؛ باعث بهبود ویژگیهای DINOv2 میشود. |
برای مطالعهی بیشتر
- Dosovitskiy et al. (2020). An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale — مقالهی اصلی معرفی ViT.
- Touvron et al. (2021). Training data-efficient image transformers & distillation through attention — مقالهی DeiT.
- Liu et al. (2021). Swin Transformer: Hierarchical Vision Transformer using Shifted Windows — مقالهی معماری Swin.
- Oquab et al. (2023). DINOv2: Learning Robust Visual Features without Supervision — مقالهی DINOv2.
- Darcet et al. (2023). Vision Transformers Need Registers — ترفند توکنهای رجیستر برای رفع نقص DINOv2.