
در مدلهای متراکم (dense)، با افزایش تعداد پارامترها، محاسبات لازم برای پردازش هر توکن به شکل سرسامآوری بالا میرود و توسعهدهنده برای داشتن مدلی باهوشتر، ناچار به پرداخت هزینههای پردازشی گزاف در هر مرحله از استنتاج است. معماری آمیختهای از متخصصان (Mixture of Experts یا MoE) این پیوند مستقیم میان اندازه و محاسبات فعال را میشکند؛ به طوری که مدلی چندصد میلیارد پارامتری میتواند با فعالسازی بخش کوچکی از وزنها، عملکردی فراتر از مدلهای متراکم همرده ارائه کند.
درک سازوکار مسیریاب (router)، تکنیک توازن بار و ساختار متخصصان ریزدانه به شما کمک میکند متوجه شوید مدلهای پیشرو مانند DeepSeek-V3 و Mixtral چگونه طراحی شدهاند و چرا برای استقرار و ارائهی آنها در پروداکشن به راهکارهای متفاوتی در مدیریت حافظه نیاز است.
اجاره یا تهیهی پردازندههای گرافیکی قدرتمند برای کاربران در ایران هزینهی بسیار بالایی دارد و مدلهای عظیم MoE نیازمند حافظهی ویدیویی (VRAM) بالایی هستند. با این حال، یادگیری پیادهسازی منطق لایههای MoE، نحوهی تعادل بار و ترفندهای تفکیک بایاس مسیریابی را میتوانید بدون نیاز به کلاسترهای ابری و صرفاً با پردازندهی معمولی سیستم خود بررسی و تمرین کنید.
یک ترنسفورمر متراکم (dense) با 70B پارامتر، برای تکتک توکنها تمام پارامترهایش را فعال میکند. در مقابل، یک مدل MoE با 671B پارامتر به ازای هر توکن تنها 37B پارامتر را به کار میگیرد و در تمام بنچمارکها از آن جلو میزند. تنکسازی (sparsity) مهمترین ایدهی مقیاسپذیری در دههی اخیر است.
صورت مسئله
میزان فلاپس (FLOPs) یک ترنسفورمر متراکم هنگام استنتاج (inference)، دقیقاً برابر با تعداد پارامترهای آن است (که برای گذر رو به جلو ضرب در 2 میشود). اگر یک مدل متراکم را بزرگتر کنید، هزینهی پردازش تمام پارامترها به پای تکتک توکنها نوشته میشود. تا سال 2024، مرزهای پیشرفت مدلها به دیواری از جنس محدودیت پردازشی خورد: برای دستیابی به خروجیهایی بهمراتب هوشمندانهتر، به فلاپس بسیار بالاتری به ازای هر توکن نیاز بود.
معماری آمیختهای از متخصصان (Mixture of Experts یا MoE) این پیوند را قطع میکند. کافی است هر شبکهی پیشخور (FFN) را با متخصص مستقل بهعلاوهی یک مسیریاب (router) جایگزین کنید که برای هر توکن متخصص را برمیگزیند. تعداد کل پارامترها = . پارامترهای فعال به ازای هر توکن = . پیکربندی معمول در سال 2026: ، . میزان حافظهی ذخیرهسازی با مقیاس میگیرد، در حالی که بار محاسباتی با پیش میرود.
مدلهای پیشروی سال 2026 تقریباً همگی MoE هستند: DeepSeek-V3 (با 671B کل / 37B فعال)، Mixtral 8×22B، Qwen2.5-MoE، Llama 4، Kimi K2 و gpt-oss. در جدول رتبهبندی مستقل وبسایت Artificial Analysis، تمامی 10 مدل برتر متنباز از نوع MoE هستند.
مفاهیم پایه
جایگزینی لایهی FFN
بلاک ترنسفورمر متراکم:
h = x + attn(norm(x))
h = h + FFN(norm(h))
بلاک MoE:
h = x + attn(norm(x))
scores = router(norm(h))              # (N_tokens, E)
top_k = argmax_k(scores)              # pick k of E per token
h = h + sum_{e in top_k}(
        gate(scores[e]) * Expert_e(norm(h))
    )
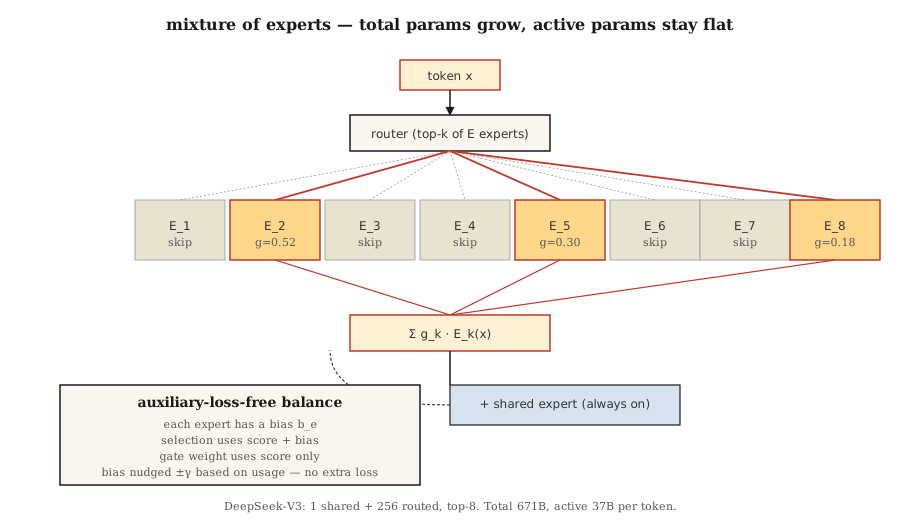
هر متخصص یک شبکهی پیشخور مستقل است (معمولاً با ساختار SwiGLU). مسیریاب هم صرفاً یک لایهی خطی ساده است. هر توکن k متخصص را برای خودش انتخاب میکند و ترکیبی وزندار از خروجیهای آنها را تحویل میگیرد.
مسئلهی تعادل بار (Load Balancing)
اگر مسیریاب 90 درصد توکنها را روانهی متخصص شمارهی 3 کند، باقی متخصصها بیاستفاده میمانند و از یادگیری محروم میشوند. برای رفع این چالش سه رویکرد آزمایش شده است:
- تابع زیان (loss) کمکی برای توازن بار (Auxiliary load-balancing loss) (در Switch Transformer و Mixtral). جریمهای متناسب با واریانس میزان استفاده از متخصصان به تابع زیان اضافه میشود. کارآمد است، اما یک هایپرپارامتر و یک سیگنال گرادیان ثانویه تحمیل میکند.
- ظرفیت متخصص بههمراه حذف توکن (Expert capacity + token dropping) (در نسخههای اولیهی Switch). هر متخصص حداکثر توکن را پردازش میکند؛ توکنهای سرریز بدون عبور از متخصصها از لایه رد میشوند. این روش به کیفیت مدل ضربه میزند.
- توازن بار بدون تابع زیان کمکی (Auxiliary-loss-free balancing) (در DeepSeek-V3). یک بایاس (bias) قابل یادگیری به هر متخصص اختصاص داده میشود که انتخابهای برتر (top-k) مسیریاب را جابهجا میکند. این بایاس بیرون از تابع زیان آموزش بهروزرسانی میشود. در نتیجه هیچ جریمهای روی هدف اصلی اعمال نمیشود؛ همان جهش بزرگ سال 2024.
رویکرد DeepSeek-V3 به این صورت است: پس از هر گام آموزشی، میزان استفادهی تکتک متخصصان نسبت به حد هدف بررسی میشود. اگر استفاده کمتر یا بیشتر بود، بایاس با ضریب ±γ تغییر کوچکی میکند. گزینش متخصصها با استفاده از scores + bias انجام میشود، اما احتمالات خروجی متخصصان برای اعمال وزن نهایی، از همان امتیازهای خام (scores) بدون تغییر محاسبه میشوند. این کار بخش مسیریابی را کاملاً از وزندهی به بازنماییها تفکیک میکند.
متخصصان مشترک (Shared Experts)
مدلهای DeepSeek-V2 و V3 متخصصان را به دو دستهی مشترک و مسیریابیشده تقسیم میکنند. همهی توکنها بدون استثنا از دل تمام متخصصان مشترک عبور میکنند؛ در حالی که متخصصان مسیریابیشده با سازوکار top-k برگزیده میشوند. وظیفهی متخصصان مشترک ثبت و نگهداری دانش عمومی است، در حالی که متخصصان مسیریابیشده تخصصیتر عمل میکنند. مدل V3 از 1 متخصص مشترک بههمراه 8 متخصص برگزیده از میان 256 متخصص مسیریابیشده بهره میبرد.
متخصصان ریزدانه (Fine-Grained Experts)
مدلهای کلاسیک MoE (مثل GShard و Switch): هر متخصص بهاندازهی یک لایهی کامل FFN پهنا دارد. تعداد متخصصان E اندک است (بین 8 تا 64) و تعداد متخصصان فعال k هم بسیار پایین است (1 یا 2).
مدلهای مدرن MoE ریزدانه (مثل DeepSeek-V3 و Qwen-MoE): هر متخصص بهمراتب باریکتر است (حدود یکهشتم اندازهی FFN). مقدار بزرگ است (256 به بالا) و نیز بزرگتر در نظر گرفته میشود (8 به بالا). مجموع پارامترها تغییری نمیکند، ولی ترکیبهای ممکن رشدی بسیار سریعتر دارند. برای هر توکن بیش از تریلیون ترکیب بالقوه از «متخصصها» شکل میگیرد. در نتیجه کیفیت بالا میرود و تاخیر ثابت میماند.
پروفایل هزینه
به ازای هر توکن، در هر لایه:
| پیکربندی | پارامترهای فعال / توکن | کل پارامترها |
|---|---|---|
| Mixtral 8×22B | حدود 39B | 141B |
| Llama 3 70B (متراکم) | 70B | 70B |
| DeepSeek-V3 | 37B | 671B |
| Kimi K2 (MoE) | حدود 32B | 1T |
مدل DeepSeek-V3 با وجود انجام فلاپس فعال کمتر به ازای هر توکن، مدل متراکم Llama 3 70B را تقریباً در تمام بنچمارکها شکست میدهد. پارامتر بیشتر مساوی است با دانشی غنیتر؛ فلاپس فعال بالاتر هم یعنی محاسبات بیشتر به ازای هر توکن. معماری MoE این دو مفهوم را از یکدیگر جدا میکند.
روی دیگر سکه: چالش حافظه
فارغ از اینکه کدام متخصصها فعال شوند، تمام آنها باید روی پردازندهی گرافیکی بارگذاری شوند. یک مدل 671B برای وزنهای fp16 خود به حدود 1.3 ترابایت حافظهی گرافیکی (VRAM) نیاز دارد. سرویسدهی مدلهای پیشروی MoE نیازمند موازیسازی متخصصان (expert parallelism) است؛ یعنی شارد کردن متخصصها میان چند پردازندهی گرافیکی و هدایت توکنها در بستر شبکه. در چنین حالتی، عامل اصلی تاخیر، ارتباطات سرتاسری (all-to-all) میان کارتهاست، نه محاسبات ضرب ماتریسی.
پیادهسازی از صفر
کد کامل داخل code/main.py قرار دارد. یک لایهی فشردهی MoE با استفاده از کتابخانهی استاندارد پایتون که ویژگیهای زیر را پیاده میکند:
n_experts=8متخصص با ساختاری شبیه SwiGLU (جهت نمایش مفهوم، هر کدام فقط با یک لایهی خطی)- مسیریابی مبتنی بر top-k=2
- وزنهای گیت نرمالشده با سافتمکس
- توازن بار بدون تابع زیان کمکی و از طریق بایاس مجزا برای هر متخصص
گام 1: مسیریاب
def route(hidden, W_router, top_k, bias):
scores = [sum(h * w for h, w in zip(hidden, W_router[e])) for e in range(len(W_router))]
biased = [s + b for s, b in zip(scores, bias)]
top_idx = sorted(range(len(biased)), key=lambda i: -biased[i])[:top_k]
# اعمال softmax روی امتیازهای اولیه متخصصهای انتخابشده
chosen = [scores[i] for i in top_idx]
m = max(chosen)
exps = [math.exp(c - m) for c in chosen]
s = sum(exps)
gates = [e / s for e in exps]
return top_idx, gatesبایاس فقط روی فرآیند انتخاب اثر میگذارد، نه روی وزن نهایی گیت. راز اصلی DeepSeek-V3 دقیقاً همینجاست؛ بایاس عدمتوازن در بار را بدون دستکاری پیشبینیهای مدل برطرف میکند.
گام 2: عبور دادن 100 توکن از مسیریاب
تعداد دفعات فعالسازی هر متخصص را ثبت کنید. بدون اعمال بایاس، توزیع استفاده کاملاً نامتعادل خواهد بود. با پیادهسازی حلقهی بهروزرسانی بایاس (کاهش با -γ برای متخصصان پرکار و افزایش با +γ برای کمکارها)، توزیع بار پس از چند تکرار به حالتی یکنواخت میل میکند.
گام 3: مقایسهی تعداد پارامترها
«معادل متراکم» پیکربندی MoE را روی صفحه چاپ کنید. اگر ابعادی مشابه DeepSeek-V3 در نظر بگیرید (256 متخصص مسیریابیشده + 1 متخصص مشترک، 8 متخصص فعال و d_model=7168)، تعداد کل پارامترها حیرتآور خواهد بود؛ در حالی که پارامترهای فعال آن تنها یکهفتم مدل متراکم Llama 3 70B است.
استفاده از ابزارهای واقعی
بارگذاری از طریق HuggingFace:
from transformers import AutoModelForCausalLM, AutoTokenizer
model = AutoModelForCausalLM.from_pretrained("mistralai/Mixtral-8x22B-v0.1")
استنتاج عملیاتی در سال 2026: فریمورک vLLM بهصورت پیشفرض از مسیریابی MoE پشتیبانی میکند و SGLang سریعترین مسیر موازیسازی متخصصان را ارائه میدهد. هر دوی این فریمورکها محاسبات top-k و موازیسازی متخصصان را خودکار مدیریت میکنند.
چه زمانی باید MoE را انتخاب کنیم:
- به دنبال کیفیتی در سطح مدلهای پیشرو با هزینهی استنتاج پایینتر به ازای هر توکن هستید.
- زیرساخت لازم برای تامین حافظهی گرافیکی و موازیسازی متخصصان را در اختیار دارید.
- سناریوی کاری شما پرتوکن است (مثل چت یا کدنویسی)، نه متمرکز بر متنهای طولانی (اسناد حجیم).
چه زمانی نباید به سراغ MoE برویم:
- استقرار روی لبه (edge deployment)؛ زیرا برای هر فلاپس فعال، باید هزینهی کامل نگهداری تمام وزنها در حافظه را بپردازید.
- سرویسدهیهای تککاربره که تاخیر در آنها حیاتی است؛ چرا که مسیریابی متخصصان سربار زمانی اضافه میکند.
- مدلهای کوچک (زیر 7B)؛ مزیت کیفی MoE تنها از یک آستانهی محاسباتی مشخص (حدود 6B پارامتر فعال) به بعد خود را نشان میدهد.
خروجی این درس
فایل outputs/skill-moe-configurator.md را بررسی کنید. این مهارت کاربردی، بر اساس بودجهی پارامتر، تعداد توکنهای آموزش و مقصد استقرار، مقادیر بهینهی E و k و ساختار متخصصان مشترک را برای یک مدل MoE جدید تعیین میکند.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. بررسی کنید که چطور بهروزرسانی بایاس بدون نیاز به تابع زیان کمکی، میزان استفاده از متخصصان را در طول 50 تکرار به تعادل میرساند. - متوسط. مسیریاب یادگیرنده را با یک مسیریاب مبتنی بر هش (قطعی و بدون یادگیری) جایگزین کنید. کیفیت و توازن بار خروجی را بسنجید. چرا عملکرد مسیریاب یادگیرنده بهتر است؟
- سخت. سازوکار مسیریابی منطبق بر نمونهبرداری (rollout-matched routing) را به سبک GRPO پیاده کنید (ترفندی از DeepSeek-V3.2): بررسی کنید کدام متخصصها حین استنتاج فعال میشوند و حین محاسبهی گرادیان، مدل را ملزم به استفاده از همان مسیرها کنید. اثر این کار را روی یک ساختار سادهی گرادیان خطمشی بسنجید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوهای عامیانه | معنای دقیق فنی |
|---|---|---|
| متخصص (Expert) | «یک FFN میان چند FFN دیگر» | یک شبکهی پیشخور مستقل؛ پارامترهایی که به بخش تنکی از محاسبات FFN اختصاص یافتهاند. |
| مسیریاب (Router) | «گیت» | یک لایهی خطی بسیار کوچک که با امتیازدهی به هر توکن در برابر هر متخصص، گزینش top-k را انجام میدهد. |
| مسیریابی برترینها (Top-k routing) | «k متخصص فعال به ازای هر توکن» | محاسبات پیشخور هر توکن منحصراً از k متخصص عبور کرده و با وزن گیت ترکیب میشود. |
| تابع زیان کمکی (Auxiliary loss) | «جریمهی توازن بار» | جملهای اضافه در تابع زیان (loss) که استفادهی نامتقارن از متخصصها را جریمه میکند. |
| توازن بدون تابع زیان کمکی (Auxiliary-loss-free) | «ترفند DeepSeek-V3» | ایجاد تعادل فقط از طریق بایاس مجزا روی انتخابهای مسیریاب؛ بدون هیچ گرادیان اضافه. |
| متخصص مشترک (Shared expert) | «همیشه روشن» | متخصص اضافه که همهی توکنها الزماً از آن عبور میکنند تا دانش عمومی را ثبت کند. |
| موازیسازی متخصصان (Expert parallelism) | «شارد بر مبنای متخصص» | توزیع متخصصان مختلف روی پردازندههای گرافیکی مجزا و مسیریابی توکنها در بستر شبکه. |
| تنکسازی (Sparsity) | «پارامترهای فعال کمتر از کل پارامترها» | نسبت ؛ که برای مثال در DeepSeek-V3 برابر است با 37/671 یا حدود 5.5 درصد. |
برای مطالعهی بیشتر
- Shazeer et al. (2017). Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer — مقالهی بنیادین این ایده.
- Fedus, Zoph, Shazeer (2022). Switch Transformer: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity — مقالهی ترنسفورمر Switch، ساختار کلاسیک MoE.
- Jiang et al. (2024). Mixtral of Experts — مدل Mixtral 8×7B.
- DeepSeek-AI (2024). DeepSeek-V3 Technical Report — جزئیات ترکیب معماریهای MLA، توازن MoE بدون تابع زیان کمکی و MTP.
- Wang et al. (2024). Auxiliary-Loss-Free Load Balancing Strategy for Mixture-of-Experts — مقالهی متوازنسازی بار بر پایهی بایاس.
- Dai et al. (2024). DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models — تفکیک متخصصان ریزدانه و مشترک که مبنای مسیریاب این درس است.
- Kim et al. (2022). DeepSpeed-MoE: Advancing Mixture-of-Experts Inference and Training — مقالهی اولیهی ایدهی متخصصان مشترک.