
یادگیری مکانیزم اتنشن بهتنهایی برای درک مدلهای زبانی کافی نیست؛ یک لایهی اتنشن فقط یک استخراجکنندهی ویژگی ساده است و برای ساخت مدلهای زبانی واقعی، به چیدمان عمیق لایهها روی هم نیاز دارید. بدون استفاده از اتصالهای باقیمانده، لایههای نرمالسازی و شبکههای پیشخور، گرادیانها در لایههای عمیق ناپدید شده و فرآیند یادگیری متوقف میشود.
در این درس اسکلت اصلی معماری ترنسفورمر را میسازید و بلوکهای انکودر و دیکودر را بههم متصل میکنید. همچنین تفاوت بلوکهای کلاسیک سال 2017 با استانداردهای مدرن (مانند جایگزینی LayerNorm با RMSNorm و استفاده از SwiGLU بهجای ReLU) را بررسی میکنید تا دقیقاً متوجه شوید مدلهای پیشرویی مثل Llama چگونه پیادهسازی میشوند.
تمام کدهای این درس مفهومی و ساختاری هستند و برای اجرای آنها نیازی به منابع پردازشی سنگین یا GPU ابری ندارید؛ میتوانید پیادهسازیها را بهراحتی روی CPU سیستم شخصی خود اجرا کنید.
ستارهی اصلی، مکانیزم اتنشن است. هر چیز دیگری — اتصالات باقیمانده، نرمالسازی، شبکهی پیشخور و کراساتنشن — صرفاً داربستی است که چیدنِ عمیق لایهها روی هم را ممکن میکند.
صورت مسئله
یک لایهی اتنشنِ تنها، صرفاً یک استخراجکنندهی ویژگی است، نه یک مدل. یک ضرب ماتریسی (matmul) در هر لایه گنجایش محاسباتیِ کافی را برای زبان ندارد. شما به عمق نیاز دارید — و عمق مدل هم بدون زیرساخت فنیِ درست از هم میپاشد.
مقالهی سال 2017 واسوانی (Vaswani) شش تصمیم در طراحی را کنار هم چید تا یک لایهی اتنشن به بلوکی تبدیل شود که رویهمچیدنی است. از آن زمان، تکتک ترنسفورمرها — چه فقط انکودر مثل BERT، چه فقط دیکودر مثل GPT و چه انکودر-دیکودر مثل T5 — اسکلتبندیِ یکسانی را به ارث بردهاند. در سال 2026 این بلوکها دستخوش بهینهسازیهایی شدهاند (RMSNorm، SwiGLU، پیشنرمالسازی یا pre-norm و RoPE)، اما اسکلت اصلی دقیقاً همان است.
این درس به همین اسکلت اختصاص دارد. در درسهای بعد جزئیات تخصصی هر یک بررسی میشود — درس 06 برای انکودرها، درس 07 برای دیکودرها و درس 08 برای معماریهای انکودر-دیکودر.
مفهوم
شش قطعهی سازنده
- امبدینگ بههمراه سیگنال مکانی. تبدیل توکنها به بردار. موقعیت یا با RoPE (در معماریهای مدرن) یا با امواج سینوسی (روش کلاسیک) اعمال میشود.
- خوداتنشن (Self-attention). هر موقعیت مکانی به تمام موقعیتهای دیگر توجه میکند. در دیکودرها ماسک میشود.
- شبکهی پیشخور (Feed-forward network یا FFN). یک پرسپترون دولایهای (MLP) مستقل برای هر موقعیت:
W_2 · activation(W_1 · x). ضریب افزایش بعد (expansion ratio) بهصورت پیشفرض 4× است. - اتصال باقیمانده (Residual connection). رابطهی
x + sublayer(x). بدون این اتصال، با عبور از حدود 6 لایه، گرادیانها بهکلی محو میشوند. - نرمالسازی لایهای (Layer normalization). لایههای
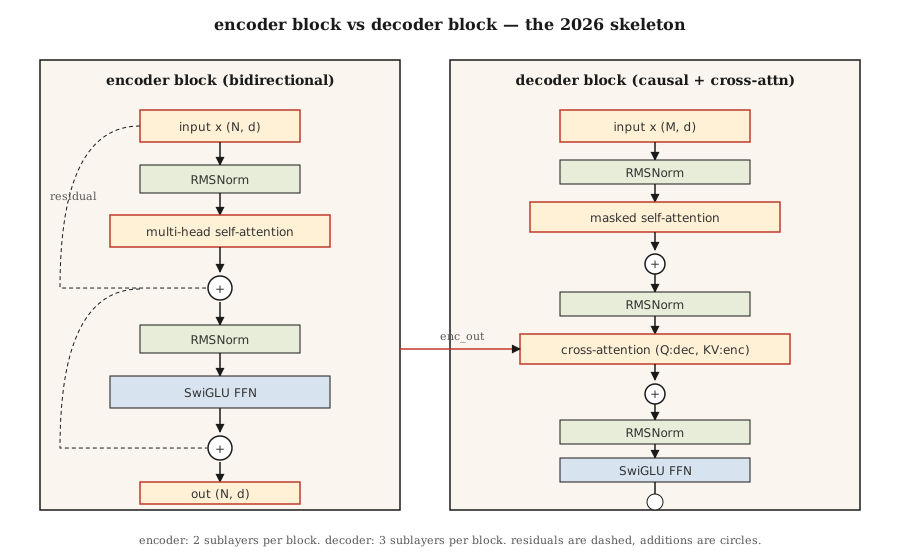
LayerNormیا نوع مدرنتر آنRMSNorm؛ جریان باقیمانده (residual stream) را پایدار نگه میدارند. - کراساتنشن (Cross-attention) (فقط در دیکودر). پرسشها (queries) از دیکودر میآیند، و کلیدها (keys) و مقادیر (values) از خروجی انکودر تأمین میشوند.
جریان حرکت یک بردار در دل یک بلوک را دنبال کنید: اتنشن دادهها را در طول موقعیتها درهم میآمیزد، اتصال باقیمانده اطلاعات قبلی را پیش میبرد، شبکهی FFN آن را بازتولید و تبدیل میکند و در نهایت، نرمالسازی لایهای پایداریِ کل جریان را حفظ میکند.
بلوک انکودر (استفادهشده در BERT و انکودر T5)
x → LN → MHA(self) → + → LN → FFN → + → out
                     ^              ^
                     |              |
                     └── residual ──┘
انکودر دوطرفه است؛ بدون ماسکگذاری کار میکند و تمام موقعیتها به همهی موقعیتها دید دارند.
بلوک دیکودر (استفادهشده در GPT و دیکودر T5)
x → LN → MHA(masked self) → + → LN → MHA(cross to encoder) → + → LN → FFN → + → outدیکودر در هر بلوک سه زیرلایه دارد. زیرلایهی میانی — یعنی کراساتنشن — تنها جایی است که اطلاعات از انکودر به دیکودر منتقل میشود. در معماریهای خالصِ فقط-دیکودر (مثل GPT)، کراساتنشن حذف میشود و شما صرفاً خوداتنشنِ ماسکشده و FFN را دارید.
مقایسهی پیشنرمالسازی با پسنرمالسازی (Pre-norm در برابر Post-norm)
مقالهی اصلی: LN(x + sublayer(x)) در برابر x + sublayer(LN(x)). از حدود سال 2019، ساختار پسنرمالسازی محبوبیتش را از دست داد؛ چون آموزش عمیقِ آن بدون برنامهی وارمآپ (پیشگرمایش) بسیار دقیق دشوار است. امروزه در سال 2026، پیشنرمالسازی (اعمال LN پیش از زیرلایه) گزینهی پیشفرض است: Llama، Qwen، GPT-3+ و Mistral همگی از آن استفاده میکنند.
بلوک مدرن در سال 2026
مقالهی سال 2017 واسوانی با LayerNorm و ReLU عرضه شد. طراحیهای مدرن هر دو را کنار گذاشتهاند. بلوکهای عملیاتی در دنیای واقعی اینگونه ساخته میشوند:
| مؤلفه | 2017 | 2026 |
|---|---|---|
| نرمالسازی | LayerNorm | RMSNorm |
| تابع فعالساز FFN | ReLU | SwiGLU |
| ضریب گسترش FFN | 4× | 2.6× (از آنجا که SwiGLU از سه ماتریس بهره میبرد، تعداد کل پارامترها یکسان میماند) |
| موقعیت مکانی | سینوسی مطلق | RoPE |
| اتنشن | MHA استاندارد | GQA (یا MLA) |
| جملات بایاس (Bias) | دارد | ندارد |
مکانیزم RMSNorm مرحلهی مرکززدایی (تفریق میانگین) در LayerNorm را حذف میکند (یک عمل تفریق کمتر) که باعث صرفهجویی در پردازش میشود و در عمل هم حداقل به همان اندازه پایدار است. از سوی دیگر، تابع فعالساز SwiGLU (Swish(W1 x) ⊙ W3 x) در مقالههای Llama، PaLM و Qwen همواره عملکرد بهتری در حد 0.5 نمره در پرپلکسیتی (ppl) نسبت به ترکیبهای ReLU/GELU با FFN نشان داده است.
محاسبهی تعداد پارامترها
برای یک بلوک با بعد d_model = d و ضریب گسترشِ FFN برابر با r:
- مکانیزم MHA: برابر با
4 · d²(تصویر کردن ماتریسهای Q، K، V و O) - شبکهی FFN (با SwiGLU): برابر با
3 · d · (r · d)≈3rd² - لایههای نرمالسازی: بسیار ناچیز
با مقادیر d = 4096، r = 2.6 و layers = 32 (تقریباً معادل Llama 3 8B)، جمع کل به این صورت درمیآید: 32 · (4·4096² + 3·2.6·4096²) ≈ 32 · (67M + 131M) ≈ 32 · 198M ≈ 6.3B پارامتر درون بلوکها، بهعلاوهی حدود 1 میلیارد پارامتر برای امبدینگها و سر خروجی (با واژگان 128K ضرب در 4096، بدون اشتراکگذاری وزنها). این رقم به عدد منتشرشدهی 8B نزدیک میشود. مدل واقعی از GQA (با ماتریسهای K و V کوچکتر) و FFN عریضتر (r = 3.5) استفاده میکند که پارامترها را از اتنشن به FFN منتقل میسازد، اما جمع نهایی را حوالی 8B حفظ میکند.
پیادهسازی
گام 1: قطعات پایه
با تکیه بر کلاس کوچک Matrix از درس 03 (که برای مستقل ماندن کد در این فایل هم کپی شده است):
- تابع
layer_norm(x, eps=1e-5)— کم کردن میانگین، تقسیم بر انحراف معیار. - تابع
rms_norm(x, eps=1e-6)— تقسیم بر جذر میانگین مربعات (RMS). بدون تفریق میانگین. - توابع
gelu(x)وsilu(x) * W3 x(برای SwiGLU). - تابع
ffn_swiglu(x, W1, W2, W3). - توابع
encoder_block(x, params)وdecoder_block(x, enc_out, params).
برای دیدن کد کامل سیمکشی و ارتباطات، فایل code/main.py را بررسی کنید.
گام 2: اتصال یک انکودر 2 لایهای و یک دیکودر 2 لایهای
لایهها را روی هم بچینید. خروجی انکودر را وارد لایهی کراساتنشن تکتک بلوکهای دیکودر کنید. پیش از تصویر کردن خروجی نهایی، یک لایهی LN نهایی اضافه کنید.
def encode(tokens, params):
    x = embed(tokens, params.emb) + sinusoidal(len(tokens), params.d)
    for block in params.encoder_blocks:
        x = encoder_block(x, block)
    return x

def decode(target_tokens, encoder_out, params):
    x = embed(target_tokens, params.emb) + sinusoidal(len(target_tokens), params.d)
    for block in params.decoder_blocks:
        x = decoder_block(x, encoder_out, block)
    return x
گام 3: اجرای مرحلهی پیشرو (Forward) روی یک مثال ساختگی
یک دنبالهی مبدأ 6 توکنی و یک دنبالهی مقصد 5 توکنی را به مدل بدهید. مطمئن شوید که ابعاد خروجی برابر با (5, vocab) باشد. در اینجا مدلی را آموزش نمیدهیم؛ تمرکز این درس روی خود معماری است نه محاسبهی تابع زیان (loss).
گام 4: جایگزینی RMSNorm و SwiGLU
بهجای LayerNorm و ReLU-FFN، از RMSNorm و SwiGLU استفاده کنید. دقت کنید که ابعاد خروجی همچنان همخوانی داشته باشند. این همان بهروزرسانیِ سال 2026 فقط با تغییر یک تابع است.
استفاده در عمل
پیادهسازیهای مرجع در PyTorch و TensorFlow به شکل nn.TransformerEncoderLayer و nn.TransformerDecoderLayer هستند. اما در کدهای محیطهای عملیاتی سال 2026، بیشتر پروژهها بلوکهای اختصاصی خودشان را مینویسند؛ به چند دلیل:
- فلش اتنشن (Flash Attention) مستقیماً درون تابع اتنشن صدا زده میشود، نه از طریق
nn.MultiheadAttention. - مکانیزمهای مدرنتر مثل GQA و MLA در پیادهسازیهای کتابخانهی استاندارد تعریف نشدهاند.
- RoPE، RMSNorm و SwiGLU گزینههای پیشفرض PyTorch نیستند.
کتابخانهی transformers در HF بلوکهای مرجع بسیار تمیزی دارد که باید حتماً بخوانید: فایل modeling_llama.py بلوک استاندارد فقط-دیکودر در سال 2026 است؛ کدی در حدود 500 خط که ارزش یک بار بررسی دقیق را دارد.
چه زمانی از انکودر، دیکودر یا مدل انکودر-دیکودر استفاده کنیم؟
| نیاز | انتخاب | نمونه |
|---|---|---|
| طبقهبندی، امبدینگ، پاسخ به پرسش از روی متن | فقط-انکودر | BERT، DeBERTa، ModernBERT |
| تولید متن، چت، کدنویسی، استدلال | فقط-دیکودر | GPT، Llama، Claude، Qwen |
| ورودی ساختاریافته به خروجی ساختاریافته (ترجمه، خلاصهسازی) | انکودر-دیکودر | T5، BART، Whisper |
معماری فقط-دیکودر میدان پردازش زبان را فتح کرد؛ چون هم تمیزتر مقیاسپذیر میشود و هم از پسِ کامپریهنشن (درک مطلب) و هم تولید متن برمیآید. با این حال، انکودر-دیکودر همچنان زمانی که ورودی ماهیت مشخصی بهعنوان «دنبالهی مبدأ» دارد (مثل ترجمه، تشخیص گفتار و تسکهای ساختاریافته) بهترین گزینه است.
تحویل به محیط عملیاتی
فایل outputs/skill-transformer-block-reviewer.md را بررسی کنید. این مهارت (skill)، پیادهسازی یک بلوک ترنسفورمر را با استانداردهای سال 2026 میسنجد و نبود مؤلفههای کلیدی را گزارش میکند (از جمله پیشنرمالسازی، RoPE، RMSNorm، GQA و ضریب گسترش FFN).
تمرینها
- ساده. تعداد پارامترهای تابع
encoder_blockخود را با مقادیرd_model=512،n_heads=8،ffn_expansion=4وswiglu=Trueمحاسبه کنید. با پیادهسازی بلوک و اجرای دستورsum(p.numel() for p in block.parameters())محاسبات خود را اعتبارسنجی کنید. - متوسط. معماری را از پسنرمالسازی به پیشنرمالسازی تغییر دهید. هر دو را مقداردهی اولیه کرده و نُرم فعالسازها را پس از چیدن 12 لایه روی ورودی تصادفی اندازه بگیرید. نُرم فعالسازها در حالت پسنرمالسازی باید رشد انفجاری داشته باشد، در حالی که در پیشنرمالسازی باید در بازهای مشخص و محدود بماند.
- سخت. یک مدل انکودر-دیکودر 4 لایهای را روی یک تسک کپیِ ساده (چاپ برعکس دنبالهی
x) پیاده کنید. مدل را به مدت 100 گام (step) آموزش دهید و تابع زیان (loss) را ثبت کنید. حالا RMSNorm + SwiGLU + RoPE را جایگزین کنید؛ آیا مقدار تابع زیان کاهش مییابد؟
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای دقیق فنی |
|---|---|---|
| بلوک (Block) | «یک لایه ترنسفورمر» | چیدمانی از نرمالسازی + اتنشن + نرمالسازی + FFN که در اتصالات باقیمانده پیچیده شدهاند. |
| اتصال باقیمانده (Residual) | «اتصال جهشی (Skip connection)» | خروجی x + f(x)؛ جریان گرادیان را در لایههای عمیق ممکن میسازد. |
| پیشنرمالسازی (Pre-norm) | «نرمالسازی قبل از لایه، نه بعدش» | فرمول مدرن: x + sublayer(LN(x)). آموزش لایههای عمیق را بدون دردسرهای وارمآپ ممکن میسازد. |
| RMSNorm | «لایِرنرم بدون میانگین» | تقسیم بر جذر میانگین مربعات (RMS)؛ یک عمل کمتر، با همان پایداری تجربی. |
| SwiGLU | «همان FFN معروفی که همه سراغش رفتند» | Swish(W1 x) ⊙ W3 x → W2. در شاخص ppl مدلهای زبانی از ReLU و GELU بهتر است. |
| کراساتنشن (Cross-attention) | «دید دیکودر به انکودر» | مکانیزم MHA که در آن پرسشها از دیکودر و کلیدها/مقادیر از خروجیهای انکودر میآیند. |
| ضریب گسترش FFN | «عرض لایهی میانی MLP» | نسبت بعد پنهان به d_model، معمولاً برابر با 4 (در LayerNorm) یا 2.6 (در SwiGLU). |
| بدون بایاس (Bias-free) | «حذف جملات b+» | معماریهای مدرن بایاسها را از لایههای خطی حذف میکنند؛ پرپلکسیتی اندکی بهتر و مدل کوچکتر میشود. |
برای مطالعهی بیشتر
- Vaswani et al. (2017). Attention Is All You Need — مشخصات اولیهی بلوک ترنسفورمر.
- Xiong et al. (2020). On Layer Normalization in the Transformer Architecture — چرایی برتری پیشنرمالسازی نسبت به پسنرمالسازی در مدلهای عمیق.
- Zhang, Sennrich (2019). Root Mean Square Layer Normalization — مقالهی معرفی RMSNorm.
- Shazeer (2020). GLU Variants Improve Transformer — مقالهی معرفی SwiGLU.
- HuggingFace
modeling_llama.py— بلوک استاندارد فقط-دیکودر در سال 2026.