
هنگام ساخت یا فاینتیون یک مدل زبانی، یکی از اولین تصمیمهای سرنوشتساز تقسیم بودجهی پردازشی میان «تعداد پارامترها» و «تعداد توکنهای داده» است. پیشتر تصور میشد مدل هرچه بزرگتر باشد بهتر است، اما پژوهشهای جدید نشان دادند که بیشتر مدلها با کمبود توکن روبهرو بودهاند و بدون دادهی کافی به پتانسیل واقعی خود نمیرسند.
درک قوانین مقیاسپذیری (Scaling Laws) به شما کمک میکند پیش از صرف هرگونه هزینه یا درگیر کردن سختافزار، معماری و بودجهی آموزشی را طوری بچینید که در مرز بهینه حرکت کنید. علاوه بر این، میآموزید چرا امروزه مدلهایی مثل Llama به جای مرز محاسباتی تئوری، بسیار بیشتر از حد بهینه آموزش میبینند تا در زمان استنتاج روی کارتهای گرافیک ارزانتر جا شوند.
با توجه به اینکه اجارهی GPUهای ابری قدرتمند خارجی برای توسعهدهندگان در ایران بسیار پرهزینه و دشوار است، تسلط بر توازن میان اندازه مدل و حجم داده نقشی کلیدی دارد. این دانش به شما امکان میدهد بودجهی سختافزاری محدود خود را هدر ندهید و بهترین عملکرد ممکن را استخراج کنید.
مقالهی سال 2020 کاپلان میگفت: مدل بزرگتر، تابع زیان (loss) کمتر. مقالهی سال 2022 هافمن گفت: مدلها را کمتر از حد لازم آموزش میدادید (under-training). توان پردازشی در دو سبد خرج میشود — پارامترها و توکنها — و نحوهی تقسیم آن اصلاً بدیهی نیست.
صورت مسئله
وقتی C فلاپس (FLOPs) توان پردازشی برای آموزش در اختیار دارید و بهترین مدل ممکن را میخواهید، با دو پیچ تنظیم روبهرو هستید:
- چند پارامتر (N)؟ مدل بزرگتر، ظرفیت بالاتر.
- چند توکن آموزشی (D)؟ دادهی بیشتر، بهرهبرداری بهتر از ظرفیت.
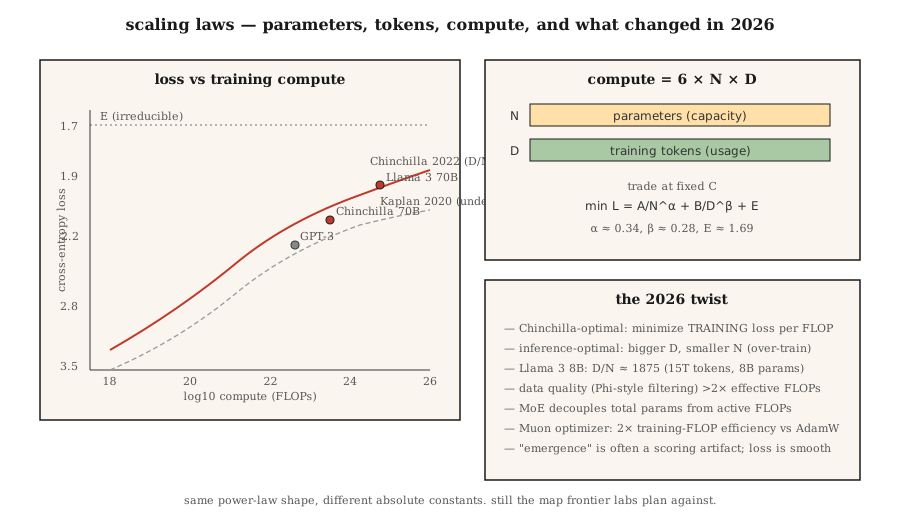
توان پردازشی مصرفی تقریباً به صورت 6 × N × D مقیاس میگیرد. میتوانید N را بالا ببرید و D را کم کنید، یا برعکس. کدام بهتر است؟
پیش از سال 2022، پاسخ این بود: «تا جای ممکن N را بالا ببرید». مدل GPT-3 (سال 2020) با 175 میلیارد پارامتر روی حدود 300 میلیارد توکن آموزش دید؛ یعنی نسبتی در حدود 1.7 توکن به ازای هر پارامتر. قوانین مقیاسپذیری (scaling laws) کاپلان هم پشت این دیدگاه بودند.
هافمن و همکارانش (2022) با آموزش خانوادهای از مدلهای کوچک به نام Chinchilla به یافتهی دیگری رسیدند: نسبت بهینه نزدیک به 20 توکن به ازای هر پارامتر است. مدل GPT-3 ده برابر کمتر از حد بهینه آموزش دیده بود. Chinchilla (با 70 میلیارد پارامتر و 1.4 تریلیون توکن) مدل GPT-3 (با 175 میلیارد پارامتر و 300 میلیارد توکن) را در تمام بنچمارکها شکست داد، آن هم با 2.5 برابر هزینهی استنتاج (inference) کمتر.
جهان سال 2026 بر مدار Chinchilla میچرخد — البته با یک پیچش مهم: مدل Llama 3 8B روی 15 تریلیون توکن آموزش دید؛ یعنی نسبت 1,875 توکن به ازای هر پارامتر، که 94 برابر فراتر از حد بهینهی Chinchilla است. برای مدلهایی که قرار است در مقیاس وسیع سرویسدهی کنند، هزینهی استنتاج بسیار مهمتر از هزینهی آموزش است؛ بنابراین بیشآموزش (over-training) — فراتر از بهینهی Chinchilla — برای رسیدن به اندازهای کوچکتر و ارزانتر در استقرار، رویکرد پیشفرض سال 2026 است.
مفاهیم پایه
قانون هافمن
طبق مقالهی Chinchilla، تابع زیان از این رابطه پیروی میکند:
- = تعداد پارامترها (بدون احتساب لایهی امبدینگ).
- = توکنهای آموزشی.
- ، (تقریباً متقارن).
- ، سقف تابع زیان کاهشناپذیر.
- ، .
با مقیاسپذیری، این دو عبارت با یکدیگر تعادل برقرار میکنند. اگر از رابطه نسبت به در توان پردازشی ثابت () مشتق بگیرید و معادله را حل کنید، با مقادیر و بالا، توانها حدود 0.45 برای و 0.55 برای به دست میآیند؛ بنابراین نسبت دقیق بهینه با تغییر بودجه به آرامی جابهجا میشود. اسکریپت code/main.py این مقدار را با جستجوی شبکهای (grid search) پیدا میکند. دو رویکرد اول برازش در مقاله که نقطهی بهینه را مستقیماً اندازه میگیرند، هر دو توان را حدود 0.5 برآورد میکنند. این موضوع قاعدهی تجربیِ یک نسبت ثابت را به دست میدهد. با قرار دادن در ، این قاعدهی سرانگشتی حاصل میشود:
بهینه از نظر توان پردازشی: 20 توکن به ازای هر پارامتر.
اصلاً چرا بیشآموزش؟
حالت بهینهی Chinchilla تابع زیان آموزش را به ازای هر فلاپس آموزش کمینه میکند. اما هزینهی آموزش را فقط یک بار میپردازید؛ هزینهی استنتاج را تا ابد.
برای باتی که ماهانه به یک تریلیون توکن پاسخ میدهد، هزینهی استنتاج بخش اعظم هزینهی کل است. رویکرد Llama این است: کوچکتر بساز، طولانیتر آموزش بده. مدل 8B با 15 تریلیون توکن عمیقاً برای استنتاج بهینهسازی شده است:
- روی پردازندههای گرافیکی مصرفی جا میگیرد.
- تاخیر آن کسر کوچکی از مدل 70B در حالت بهینهی Chinchilla است.
- کیفیت آن برای بیشتر تسکها به قدر کافی مناسب است.
مقالهی سال 2024 دیپمایند («بیشآموزش، بهینهی نوین است») این مفهوم را فرمولبندی کرد. برای بارهای کاری که هزینهی استنتاج بر آنها غلبه دارد، نسبت درست بسته به حجم سرویسدهی چیزی بین 100 تا 500 توکن به ازای هر پارامتر است.
توانمندیهای نوظهور در برابر رفتار هموار
ادعا میشود که برخی توانمندیها (محاسبات عددی، استدلال چندمرحلهای، دنبال کردن زنجیرهی تفکر) ناگهان در مقیاسی خاص «ظهور» میکنند.
شفر و همکارانش (2023) نشان دادند که این مسئله خطای روش اندازهگیری است: معیارهای نوظهور از امتیازدهی ناپیوسته (تطابق دقیق، دقت در آستانه) استفاده میکنند که بهبود تدریجی و هموار در لاجیتهای زیربنایی را پنهان میسازد. معیارهای پیوسته (مانند آنتروپی متقاطع) منحنیهایی هموار را نشان میدهند.
در سال 2026 اجماع بر این است: پیشبینیها از طریق تابع زیان پیوسته قابل اعتمادند. جهشها در بنچمارکها اغلب ناشی از شیوهی امتیازدهی هستند. بودجهها را بر اساس معیارهای پیوسته برنامهریزی کنید.
تصویر کلی در سال 2026
قوانین مقیاسپذیری هنوز کار میکنند، اما:
| عامل | نحوهی تغییر |
|---|---|
| کیفیت داده | گزینش توکنهای «خوب» (به سبک Phi) منحنیها را به اندازهی بیش از 2 برابر توان پردازشی موثر جابهجا میکند |
| MoE | پارامترهای کل از فلاپس فعال تفکیک میشوند؛ قوانین مقیاسپذیری به ازای هر فلاپس فعال تعریف میشوند |
| پسآموزش (Post-training) | برخی توانمندیها (دنبال کردن دستورالعمل، کدنویسی) با SFT و RLHF بیشتر از پیشآموزش جابهجا میشوند |
| چندوجهی (Multimodality) | توکنهای تصویر و متن با هم مقیاس میشوند؛ منحنیهای مجزا برای هر وجه |
| دادههای مصنوعی (Synthetic) | مدلها دادههای آموزشی تولید میکنند؛ توان پردازشی موثر میتواند به صورت تصاعدی افزایش یابد |
بهینهساز Muon (پروژهی Kimi Moonlight، سال 2024) در مقایسه با AdamW روی دادههای یکسان، حدود 2 برابر بهرهوری در توان پردازشی موثر نشان داد. برخی اجراهای آموزشی سال 2026 به صورت پیشفرض از Muon استفاده میکنند. این بهینهساز مقدار ثابت مطلق را در قانون مقیاسپذیری تغییر میدهد، نه شکل کلی آن را.
پیادهسازی
کد code/main.py را ببینید. در این بخش معادلهی تابع زیان Chinchilla را پیادهسازی میکنیم و نسبت بهینهی پردازشی را برای هر یک از چند بودجهی محاسباتی به دست میآوریم.
گام 1: تابع زیان Chinchilla
def chinchilla_loss(N, D, A=406.4, B=410.7, alpha=0.34, beta=0.28, E=1.69):
    return A / N ** alpha + B / D ** beta + E
نمودار کانتور را بر حسب در مقدار ثابت رسم کنید. نقطهی کمینه را بیابید.
گام 2: مرز بهینهی پردازشی
برای بودجههای محاسباتی از 1e17 تا 1e25 فلاپس، مقادیر را بیابید که تابع زیان را با شرط کمینه میکنند. بررسی کنید که آیا نسبت برقرار است یا خیر.
گام 3: هزینهی بیشآموزش
میزان زیان اضافهای را محاسبه کنید که برای آموزش مدلی 10 برابر کوچکتر (یکدهم پارامتر بهینهی N و 10 برابر دادهی بهینهی D) میپردازید. این بخش صرفهجویی در فلاپس استنتاج (متناسب با N) را در ازای این زیان اضافی گزارش میدهد.
گام 4: مقایسه با مدلهای واقعی
جفتهای شناختهشدهی (N, D) را برای مدلهای GPT-3، Chinchilla، Llama 3 8B و DeepSeek-V3 (پارامترهای فعال) قرار دهید و تابع زیان پیشبینیشده را با مقدار گزارششده مقایسه کنید.
کاربرد در عمل
شاید خودتان مستقیماً یک مدل پیشرو را آموزش ندهید، اما قوانین مقیاسپذیری به شما میگویند:
- آیا دادهی کافی برای فاینتیونینگ دارید یا خیر. اگر دادههای تسک خاص شما کمتر از 20 توکن به ازای هر پارامترِ مدل پایه باشد، باید منتظر اشباع روی یک کف زیان مشخص باشید.
- آیا مدل پایهی بزرگتری انتخاب کنید یا خیر. اگر تمام بودجهی خود را صرف استنتاج میکنید، مدلی کوچکتر را ترجیح دهید که طولانیتر آموزش دیده باشد.
- بازده نزولی از کجا آغاز میشود. فراتر از 1000 برابر حد بهینهی Chinchilla، تغییرات لگاریتمی تابع زیان عملاً تبدیل به نویز میشوند.
مسیر پژوهش در سال 2026:
- رژیم محدودیت داده. وب حاوی حجم محدودی از توکنهای باکیفیت است (حدود 5 تا 10 تریلیون توکن انگلیسی پس از فیلتر کردن). پیشآموزش مدلهای پیشرو به این سقف نزدیک میشود. دادههای ترکیبی، دادههای چندزبانه، مدلهای چندوجهی و فاینتیونینگ مقیاسیافته با RLHF اهرمهای بعدی هستند.
- ترفندهای ضریب توان پردازشی. بهینهساز Muon، معماری MoE و گزینش بهتر دادهها — هر کدام مقادیر ثابت را تغییر میدهند، نه مجانب نهایی را.
- قوانین مقیاسپذیری برای RL. این موضوع همچنان یک پرسش باز است. شواهد اولیه حاکی از برقراری قانون توانی در نمونههای RL است، اما با توانهایی کاملاً متفاوت از پیشآموزش.
خروجی نهایی
فایل outputs/skill-training-budget-estimator.md را ببینید. این مهارت با در نظر گرفتن بودجهی پردازشی، محدودیتهای استقرار و تابع زیان هدف، ترکیب مناسب (N, D, hours, GPU) را برای یک اجرای آموزشی جدید انتخاب میکند.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. نسبت بهینهی در Chinchilla را برای بودجههای پردازشی1e20،1e22و1e24چاپ کنید. نتایج را با جدول مدلهای واقعی مقایسه کنید. - متوسط. منحنی تابع زیان هافمن بر حسب توان پردازشی را پیادهسازی کنید. تابع زیان را بر حسب
log10(C)برای مرز بهینهی پردازشی رسم کنید. مشخص کنید طبق این قانون چه زمانی برای کاهش 0.1 بعدی در آنتروپی متقاطع به فلاپس نیاز خواهیم داشت. - سخت. قانون مقیاسپذیری اختصاصی خود را روی 5 مدل کوچک (از 100 هزار تا 10 میلیون پارامتر) که روی دادههای یکسان آموزش دیدهاند برازش دهید. مقادیر و را تخمین بزنید. توانهای بهدستآمده چقدر با مقادیر منتشرشده همخوانی دارند؟
اصطلاحات کلیدی
| اصطلاح | در گفتار عامیانه | مفهوم فنی و دقیق |
|---|---|---|
| پارامترها (N) | «اندازهی مدل» | تعداد وزنها بدون احتساب لایهی امبدینگ؛ تعیینکنندهی ظرفیت مدل. |
| توکنها (D) | «دادهی آموزشی» | تعداد توکنهای دیدهشده در آموزش؛ تعیینکنندهی کیفیت بهرهبرداری از پارامترها. |
| توان پردازشی (C) | «فلاپس مصرفشده» | تقریباً معادل 6 × N × D برای یک ترنسفورمر استاندارد. |
| بهینهی Chinchilla | «D/N ≈ 20» | نسبتی که تابع زیان را به ازای هر فلاپس پیشآموزش کمینه میکند. |
| بیشآموزش (Over-training) | «فراتر از Chinchilla» | صرف فلاپس آموزش بیشتر برای کاهش هزینهی فلاپس استنتاج؛ D/N >> 20. |
| زیان کاهشناپذیر | «کف زیان» | عبارت در قانون مقیاسپذیری؛ نشاندهندهی آنتروپی ذاتی خود داده. |
| توانمندی نوظهور | «جهشهای ناگهانی در مقیاس» | اغلب خطای ابزار سنجش؛ تابع زیان پیوسته حرکتی هموار و یکنواخت دارد. |
| توان پردازشی موثر | «ضریب بهرهوری آموزش» | داده، بهینهساز یا معماری بهتر که کارایی هر فلاپس را چند برابر میکند. |
برای مطالعهی بیشتر
- Kaplan et al. (2020). Scaling Laws for Neural Language Models — نخستین مقالهی قوانین مقیاسپذیری؛ مدلها کمتر از حد لازم آموزش دیده بودند.
- Hoffmann et al. (2022). Training Compute-Optimal Large Language Models — مقالهی معرفی Chinchilla.
- Schaeffer et al. (2023). Are Emergent Abilities of Large Language Models a Mirage? — بررسی پدیدهی ظهور به مثابهی خطای ابزار اندازهگیری.
- Sardana, Frankle (2024). Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws — چرایی درستی رویکرد بیشآموزش در Llama متناسب با بار کاری آن.
- Jordan et al. (2024). Muon: An optimizer for hidden layers in neural networks — دو برابر توان پردازشی موثرتر.