
مکانیسم اتنشن به خودی خود هیچ درکی از ترتیب توکنها ندارد. برای مدل تفاوتی نمیکند کلمات را سر جایشان بخواند یا تصادفی بر بزنید؛ بنابراین اگر ترتیب را به فرمولهای ریاضی تزریق نکنیم، پردازش زبان، کد یا هر ساختار ترتیبی دیگری عملاً غیرممکن خواهد بود. حل این چالش با معرفی ترنسفورمر اولیه آغاز شد و تا معماریهای مدرن امروزی مسیر تکاملی بزرگی را طی کرده است.
در مدلهای امروزی، انتخاب الگوریتم کدگذاری موقعیت نقش تعیینکنندهای در توانایی مدل برای مدیریت پنجرههای متنی بزرگ (Context Window) ایفا میکند. روشهای قدیمی سینوسی توانایی برونیابی ضعیفی داشتند، اما رویکردهای مدرنی مثل RoPE و ALiBi به استانداردی در مدلهای متنباز تبدیل شدهاند که امکان گسترش طول بافت را بدون نیاز به آموزش مجدد و با کمترین هزینه محاسباتی فراهم میکنند.
در این درس ساختار ریاضی و پیادهسازی پایتورچ سه رویکرد اصلی را گامبهگام بررسی میکنیم: کدگذاری سینوسی کلاسیک، روش امبدینگ دورانی (RoPE) که در مدلهایی نظیر Llama و DeepSeek استفاده میشود، و مکانیزم مبتنی بر بایاس خطی (ALiBi). در نهایت، ترفندهای مقیاسپذیری مانند YaRN و NTK-aware را برای پردازش متنهای طولانی یاد خواهید گرفت.
مکانیسم اتنشن (attention) نسبت به جایگشت ناوردا (permutation-invariant) است. بدون سیگنال موقعیت مکانی، جملهی «The cat sat on the mat» با «mat the on sat cat the» خروجی کاملاً یکسانی تولید میکند. سه الگوریتم این مشکل را برطرف میکنند؛ هر کدام با دیدگاهی متفاوت دربارهی اینکه «موقعیت» اصلاً چه معنایی دارد.
صورت مسئله
اتنشن ضرب داخلی مقیاسشده (scaled dot-product attention) نسبت به ترتیب کاملاً کور است. ماتریس اتنشن softmax(Q K^T / √d) V صرفاً بر اساس شباهتهای دوبهدو محاسبه میشود. اگر سطرهای X را بر بزنید، سطرهای خروجی هم دقیقاً به همان شکل جابهجا میشوند. درون سازوکار اتنشن، هیچ جزئی به موقعیت توکنها اهمیتی نمیدهد.
این ویژگی برای مدل کیسه کلمات (bag-of-words) باگ محسوب نمیشود؛ اما برای زبان طبیعی، کد، صوت، ویدیو یا هر چیزی که ترتیب در آن معنا میسازد، نقصی مرگبار است.
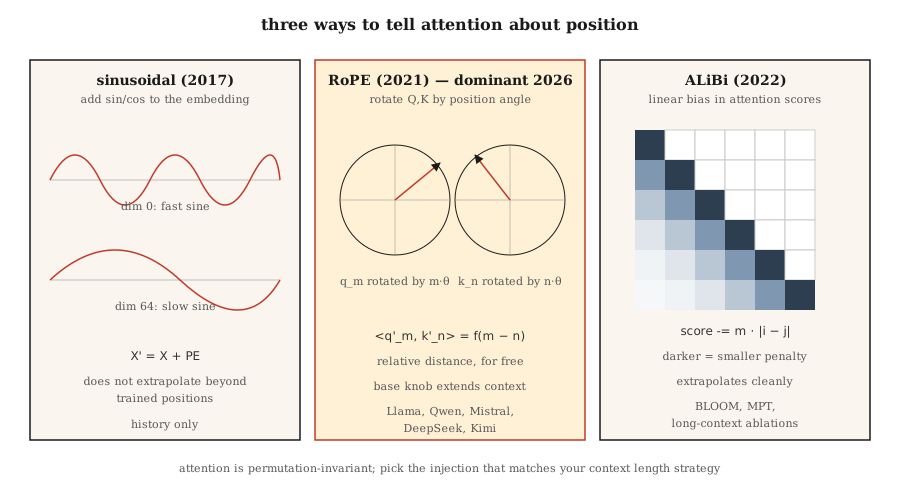
راهحل این است که موقعیت را به شکلی به امبدینگها (embeddings) تزریق کنیم. در گذر زمان سه پاسخ متمایز شکل گرفته است:
- سینوسی مطلق (Vaswani 2017): افزودن
sin/cosموقعیت به امبدینگ. ساده است و به پارامتر یادگیریپذیر نیاز ندارد، اما تعمیمپذیری (extrapolation) آن فراتر از طول دیدهشده در آموزش بسیار ضعیف است. - امبدینگ موقعیت دورانی یا RoPE (Su 2021): چرخاندن بردارهای Q و K با زاویهای متناسب با موقعیت. این روش موقعیت نسبی را مستقیماً در ضرب داخلی (dot product) کدگذاری میکند و در سال 2026 رویکرد غالب بازار است.
- اتنشن با بایاسهای خطی یا ALiBi (Press 2022): حذف کامل امبدینگ موقعیت؛ افزودن یک جریمهی خطی بر اساس فاصله به امتیازهای اتنشن در هر سر (head). تعمیمپذیری طول این رویکرد فوقالعاده است.
تا سال 2026، تقریباً تکتک مدلهای باز پیشرو از RoPE استفاده میکنند: Llama 2/3/4، Qwen 2/3، Mistral، Mixtral، DeepSeek-V3 و Kimi. تنها تعداد انگشتشماری از مدلهای با بافت طولانی (long-context) سراغ ALiBi یا گونههای مدرن آن رفتهاند. روش سینوسی مطلق دیگر جنبّهی تاریخی پیدا کرده است.
مفاهیم پایه
سینوسی مطلق
از قبل ماتریس ثابت PE را در ابعاد (max_len, d_model) محاسبه میکنیم:
سپس قبل از ورود به اتنشن، مقدار X' = X + PE[:N] را به دست میآوریم. هر بُعد یک موج سینوسی با بسامدی متفاوت است. مدل یاد میگیرد موقعیت را از روی الگوی فاز بخواند. این روش فراتر از max_len به بنبست میخورد؛ وقتی مدل فقط موقعیتهای 0 تا 2047 را دیده باشد، هیچ چیزی به آن یاد نداده که در موقعیت 2048 چه اتفاقی میافتد.
RoPE
بردارهای Q و K را میچرخانیم (نه امبدینگها را). برای یک جفت بعد :
همین دوران را روی کلیدها (K) با موقعیت pos_k اعمال میکنیم. ضرب داخلی تنها تابعی از میشود. یعنی: امتیاز اتنشن تنها به فاصلهی نسبی وابسته است، هرچند مبنای دورانها بر اساس موقعیتهای مطلق بوده است؛ ترفندی بینهایت هوشمندانه.
توسعهی RoPE: برای برونیابی به بافتهای طولانیتر بدون بازآموزی، میتوان base را مقیاسبندی کرد (روشهای NTK-aware، YaRN و LongRoPE). مدل Llama 3 پنجرهی بافت خود را با همین ترفند از 8K به 128K رساند.
ALiBi
ترفند امبدینگ را کاملاً کنار بگذارید و مستقیماً روی امتیازهای اتنشن بایاس اعمال کنید:
در اینجا شیب خطی اختصاصی برای هر سر است (مثلاً ). توکنهای نزدیکتر تقویت میشوند و توکنهای دورتر جریمه میخورند. این روش هیچ هزینهای در زمان آموزش ندارد. مقالهی اصلی نشان میدهد که تعمیمپذیری طول آن، سینوسی را پشت سر میگذارد و در طول آموزش اولیه با RoPE برابری میکند.
در سال 2026 سراغ کدام گزینه برویم؟
| گونه | تعمیمپذیری طول | هزینه آموزش | استفادهشده در |
|---|---|---|---|
| سینوسی مطلق | ضعیف | رایگان | ترنسفورمر اولیه، نسخههای نخستین BERT |
| یادگیریپذیر مطلق | ندارد | ناچیز | GPT-2، GPT-3 |
| RoPE | با مقیاسبندی خوب است | رایگان | Llama 2/3/4، Qwen 2/3، Mistral، DeepSeek-V3، Kimi |
| RoPE + YaRN | عالی | در مرحلهی فاینتیونینگ | Qwen2-1M، Llama 3.1 128K |
| ALiBi | عالی | رایگان | BLOOM، MPT، Baichuan |
RoPE از بقیه جلو افتاد چون بدون دستکاری در معماری درون اتنشن مینشیند، موقعیت نسبی را کدگذاری میکند و ابرپارامتر base آن اهرمی بیدردسر برای فاینتیونینگ مدل در بافتهای طولانی به دست میدهد.
پیادهسازی از صفر
گام 1: کدگذاری مکانی سینوسی
کد مربوطه را در code/main.py ببینید. یک محاسبهی جمعوجور 4 خطی:
def sinusoidal(N, d):
    pe = [[0.0] * d for _ in range(N)]
    for pos in range(N):
        for i in range(d // 2):
            theta = pos / (10000 ** (2 * i / d))
            pe[pos][2 * i]     = math.sin(theta)
            pe[pos][2 * i + 1] = math.cos(theta)
    return pe
این مقدار را پیش از اولین لایهی اتنشن به ماتریس امبدینگ اضافه کنید.
گام 2: اعمال RoPE روی Q و K
روش RoPE مستقیماً درجا (in-place) روی Q و K اعمال میشود. برای هر جفت از ابعاد:
def apply_rope(x, pos, base=10000):
    d = len(x)
    out = list(x)
    for i in range(d // 2):
        theta = pos / (base ** (2 * i / d))
        c, s = math.cos(theta), math.sin(theta)
        a, b = x[2 * i], x[2 * i + 1]
        out[2 * i]     = a * c - b * s
        out[2 * i + 1] = a * s + b * c
return outنکتهی حیاتی: دقیقاً همین تابع را روی Q در موقعیت و K در موقعیت اعمال کنید. ضرب داخلی آنها فاکتور را در هر جفت مختصات دریافت میکند. به این ترتیب اتنشن موقعیت نسبی را رایگان یاد میگیرد.
گام 3: شیبها و بایاس در ALiBi
def alibi_bias(n_heads, seq_len):
    # slope_h = 2 ** (-8 * h / n_heads) for h = 1..n_heads
    slopes = [2 ** (-8 * (h + 1) / n_heads) for h in range(n_heads)]
    bias = []
    for m in slopes:
        row = [[-m * abs(i - j) for j in range(seq_len)] for i in range(seq_len)]
        bias.append(row)
    return bias  # add to attention scores before softmax
مقدار bias[h] را به ماتریس امتیاز اتنشن با ابعاد (seq_len, seq_len) در سر h اضافه کنید و سپس سافتمکس بگیرید.
گام 4: اعتبارسنجی ویژگی فاصلهی نسبی در RoPE
دو بردار تصادفی a, b بردارید. آنها را با (pos_a, pos_b) بچرخانید؛ سپس همین کار را با (pos_a + k, pos_b + k) انجام دهید. ضرب داخلی در هر دو حالت باید در حد خطای ممیز شناور یکسان دربیاید. اصلاً تمام فلسفهی وجودی RoPE همین ویژگی است: اینکه نسبت به جابهجایی مطلق ناورداست و فقط فاصلهی نسبی اهمیت دارد.
استفاده در عمل
در PyTorch 2.5 به بعد، توابع کمکی RoPE در torch.nn.functional در دسترس هستند. بیشتر کدهای پروداکشن از flash_attn یا xformers استفاده میکنند که در آنها RoPE مستقیماً درون کرنل (kernel) اتنشن اعمال میشود.
from transformers import AutoModel
model = AutoModel.from_pretrained("meta-llama/Llama-3.2-3B")
# model.config.rope_scaling → {"type": "yarn", "factor": 32.0, "original_max_position_embeddings": 8192}
ترفندهای بافت طولانی در سال 2026:
- درونیابی آگاه از NTK (یا NTK-aware interpolation): هنگام ارتقا از 4K به بالای 16K، مقدار
baseرا به صورتbase * (scale_factor)^(d/(d-2))تغییر مقیاس دهید. - روش YaRN: روش هوشمندانهتری از درونیابی که آنتروپی اتنشن را در بافتهای طولانی دستنخورده نگه میدارد. مدل Llama 3.1 128K از همین تکنیک استفاده میکند.
- روش LongRoPE: رویکرد مایکروسافت در سال 2024 که با جستوجوی تکاملی، ضرایب مقیاسبندی مجزا برای هر بعد پیدا میکند. Phi-3-Long از آن بهره میبرد.
- درونیابی موقعیت + فاینتیونینگ: کافی است موقعیتها را به نسبت ضریب گسترش فشرده کنید و مدل را به اندازهی 1 تا 5 میلیارد توکن فاینتیون کنید؛ نتیجهاش بهطرز شگفتآوری عالی است.
آمادهسازی خروجی
فایل outputs/skill-positional-encoding-picker.md را بررسی کنید. این مهارت با توجه به طول بافت هدف، نیازهای برونیابی و بودجهی آموزش، استراتژی کدگذاری موقعیت مناسب را برای مدل جدید انتخاب میکند.
تمرینها
- ساده. ماتریس سینوسی
PEرا بهصورت هیتمپ با ابعادmax_len=512, d=128رسم کنید. بررسی کنید که آیا با افزایش ایندکس بعد، خطوط واقعاً پهنتر میشوند یا نه. - متوسط. مقیاسبندی NTK-aware را برای RoPE پیادهسازی کنید. یک مدل زبانی کوچک را روی توالیهایی به طول 256 آموزش دهید، سپس روی طول 1024 با و بدون مقیاسبندی تست بگیرید و پرپلکسیتی (perplexity) را بسنجید.
- سخت. هر دو روش ALiBi و RoPE را در یک ماژول اتنشن یکسان پیاده کنید. یک ترنسفورمر 4 لایه را برای مسئلهی کپیکردن (copy task) در توالیهایی به طول 512 آموزش دهید. در زمان تست، طول را به 2048 برونیابی کنید و میزان افت عملکرد دو مدل را بسنجید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای فنی دقیق |
|---|---|---|
| Positional encoding | «ترتیب رو به اتنشن میفهمونه» | هر سیگنالی که برای کدگذاری موقعیت به امبدینگها یا اتنشن اضافه شود. |
| Sinusoidal | «همون اولیهست» | توابع sin/cos با فرکانسهای هندسی که به امبدینگ اضافه میشوند؛ تعمیمپذیری طول ندارند. |
| RoPE | «امبدینگ دورانی» | چرخاندن Q و K با زاویهای وابسته به موقعیت؛ فاصلهی نسبی مستقیماً در ضرب داخلی کدگذاری میشود. |
| ALiBi | «ترفند بایاس خطی» | افزودن به امتیازهای اتنشن؛ بدون نیاز به امبدینگ، با قابلیت برونیابی عالی. |
| base | «پیچ تنظیم RoPE» | ضریب بسامد در RoPE؛ با بالا بردن آن در زمان استنتاج، طول بافت را افزایش میدهند. |
| NTK-aware | «ترفند مقیاسبندی RoPE» | تغییر مقیاس base تا هنگام باز شدن پنجرهی بافت، ابعاد فرکانسبالا فشرده نشوند. |
| YaRN | «اون مدل پیشرفتهتره» | درونیابی و برونیابی تفکیکشده برای هر بعد، طوری که آنتروپی اتنشن حفظ شود. |
| Extrapolation | «برای طولهای بالاتر هم جواب میده» | توانایی ساختار کدگذاری موقعیت در تولید خروجی درست، فراتر از max_len دیدهشده در زمان آموزش. |
برای مطالعهی بیشتر
- Vaswani et al. (2017). Attention Is All You Need §3.5 — مقالهی کدگذاری سینوسی اولیه.
- Su et al. (2021). RoFormer: Enhanced Transformer with Rotary Position Embedding — مقالهی اصلی RoPE.
- Press, Smith, Lewis (2021). Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation — مقالهی اصلی ALiBi.
- Peng et al. (2023). YaRN: Efficient Context Window Extension of Large Language Models — مدرنترین روش مقیاسبندی RoPE.
- Chen et al. (2023). Extending Context Window of Large Language Models via Positional Interpolation — مقالهی متا دربارهی بافت طولانی در Llama 2.
- Ding et al. (2024). LongRoPE: Extending LLM Context Window Beyond 2 Million Tokens — روش مایکروسافت که در Phi-3-Long به کار رفت و در بخش «استفاده در عمل» هم به آن اشاره شد.
- HuggingFace Transformers —
modeling_rope_utils.py— پیادهسازیهای پروداکشن برای تمام تکنیکهای مقیاسبندی RoPE (شامل default، linear، dynamic، YaRN، LongRoPE و Llama-3).