
در روزگاری که مدلهای زبانی بزرگ تولید متن (مانند خانوادهی GPT) همهی توجهها را به خود جلب کردهاند، پیادهسازی تسکهایی مثل دستهبندی، استخراج موجودیتها و بازرتبهبندی در خطوط بازیابی اطلاعات (RAG) به ابزاری سبکتر، سریعتر و دقیقتر نیاز دارد. مدل BERT با تکیه بر سازوکار توجه دوطرفه و مدلسازی زبان پوشاندهشده (MLM)، همچنان زیربنای بخش عمدهای از سیستمهای مدرن بازنمایی و جستجوی معنایی است.
این درس به شما نشان میدهد که چرا نیازی نیست برای هر پردازش متنی هزینهی سنگین مدلهای دیکودر را بپردازید و چگونه با فهم سازوکار ماسکگذاری و انکودر، مدلهای بسیار سریعتر و پایدارتر بسازید. پیادهسازی گامبهگام منطق MLM و درک تحولات اخیر تا ModernBERT به شما امکان میدهد سیستمهای طبقهبندی و امبدینگ اختصاصی خود را بهشکل بهینه پیادهسازی و مستقر کنید.
مدل GPT کلمهی بعدی را پیشبینی میکند؛ BERT کلمهی جاافتاده را. تفاوت در حد یک جمله است، اما همین تفاوت مسیر نیمی از یک دهه نوآوری در حوزهی امبدینگ را رقم زد.
صورتمسئله
در سال 2018 برای هر تسک پردازش زبان طبیعی (NLP) مثل تحلیل احساسات، بازشناسی موجودیتهای نامدار (NER)، پاسخ به سوالات یا استلزام معنایی، باید مدلی جداگانه از صفر و روی دادههای برچسبدار خودش آموزش میدید. هیچ چکپوینت ازپیشآموزشدیدهای برای «درک زبان انگلیسی» وجود نداشت که بتوانید آن را فاینتیون کنید. مدل ELMo (2018) نشان داد که میتوان امبدینگهای وابسته به متن را با یک LSTM دوطرفه پیشآموزش داد؛ مفید بود، ولی تعمیمپذیری بالایی نداشت.
BERT (دولین و همکاران، 2018) این پرسش را مطرح کرد: چه میشود اگر یک انکودر ترنسفورمر را با تکتک جملات اینترنت آموزش دهیم و وادارش کنیم کلمات جاافتاده را با تکیه بر بافتِ هر دو طرف پیشبینی کند؟ سپس فقط یک سربرگ را برای تسک پاییندستیتان فاینتیون میکنید. بهرهوری پارامتری آن مثل یک معجزه بود.
نتیجه چه شد؟ ظرف 18 ماه، BERT و مشتقاتش (مانند RoBERTa ،ALBERT و ELECTRA) صدر تمام لیدربوردهای NLP دنیا را تصاحب کردند. تا سال 2020، در قلب هر موتور جستجو، پایپلاین بررسی محتوا و سامانهی جستجوی معنایی روی کرهی زمین ردی از BERT دیده میشد.
در سال 2026، مدلهای مبتنی بر انکودر (Encoder-only) هنوز هم ابزار مناسب برای دستهبندی، بازیابی و استخراج ساختاریافتهاند؛ سرعت اجرای آنها بهازای هر توکن 5 تا 10 برابر دیکودرهاست و امبدینگهایشان بکبون تمام استکهای مدرن بازیابی اطلاعات است. مدل ModernBERT (دسامبر 2024) با ترکیب Flash Attention و RoPE و GeGLU طول بافت (context) این معماری را به 8K رساند.
مفهوم
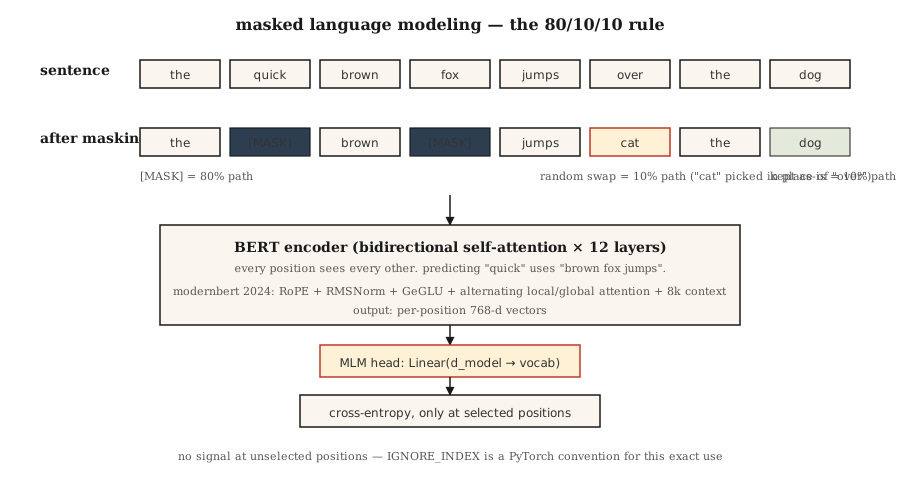
سیگنال آموزش
این جمله را در نظر بگیرید: the quick brown fox jumps over the lazy dog.
15% از توکنها را بهشکل تصادفی ماسک کنید:
input:  the [MASK] brown fox jumps [MASK] the lazy dog
target: the  quick brown fox jumps  over  the lazy dog
مدل را آموزش دهید تا توکنهای اصلی را در موقعیتهای ماسکشده پیشبینی کند. از آنجا که انکودر دوطرفه است، پیشبینی [MASK] در موقعیت 1 میتواند از brown fox jumps در موقعیتهای 2 به بعد استفاده کند؛ کاری که GPT از انجامش ناتوان است.
قواعد ماسکگذاری BERT
از میان 15% توکنِ انتخابشده برای پیشبینی:
- 80% با توکن
[MASK]جایگزین میشوند. - 10% با یک توکن تصادفی جایگزین میشوند.
- 10% بدون تغییر باقی میمانند.
چرا همیشه [MASK] نباشد؟ چون در زمان استنتاج هیچوقت [MASK] ظاهر نمیشود. اگر مدل را طوری آموزش دهید که در 100% جایگاههای ماسکشده انتظار [MASK] داشته باشد، بین مرحلهی پیشآموزش و فاینتیونینگ ناهماهنگی در توزیع دادهها (distribution shift) پیش میآید. آن 10% تصادفی و 10% بدون تغییر مدل را واقعبین نگه میدارند.
پیشبینی جملهی بعدی (NSP) — و علت کنار گذاشتن آن
نسخهی اولیهی BERT روی NSP هم آموزش میدید: با دریافت دو جملهی A و B، پیشبینی کند آیا B ادامهی A است یا نه. RoBERTa (2019) با آزمایش ابلیشن (حذف این بخش) نشان داد که NSP به عملکرد مدل آسیب میزند، نه کمک. انکودرهای امروزی از آن صرفنظر میکنند.
چه چیزی در سال 2026 تغییر کرد: ModernBERT
مقالهی سال 2024 ModernBERT این بلاک ساختاری را با المانهای پایهی سال 2026 از نو ساخت:
| بخش | BERT اولیه (2018) | ModernBERT (2024) |
|---|---|---|
| جایگاهگذاری (Positional) | مطلقِ یادگیریشده | RoPE |
| تابع فعالساز | GELU | GeGLU |
| نرمالسازی | LayerNorm | Pre-norm RMSNorm |
| اتنشن | کاملاً چگال (Dense) | ترکیب متناوب محلی (128) + سراسری |
| طول پنجرهی بافت | 512 | 8192 |
| توکنایزر | WordPiece | BPE |
علاوه بر این، برخلاف ساختار سال 2018، این نسخه بهشکل نیتیو از Flash Attention پشتیبانی میکند. سرعت استنتاج آن در طول توالی 8K حدود 2 تا 3 برابر DeBERTa-v3 است و امتیازهای بهتری هم در بنچمارک GLUE میگیرد.
تسکهایی که هنوز هم در سال 2026 سراغ انکودر میروند
| تسک | چرا انکودر از دیکودر بهتر عمل میکند؟ |
|---|---|
| امبدینگهای بازیابی / جستجوی معنایی | بافت دوطرفه = کیفیت امبدینگ بهتر بهازای هر توکن |
| دستهبندی (احساسات، نیت، سمیت محتوا) | یک گذر رو به جلو؛ بدون سربار تولید متن |
| NER / برچسبگذاری توکنها | خروجی بهازای هر موقعیت، ذاتاً دوطرفه |
| استلزام معنایی زیروشات (NLI) | سربرگ دستهبند روی انکودر |
| بازرتبهبند (Reranker) در معماری RAG | امتیازدهی کراسانکودر، 10 برابر سریعتر از بازرتبهبندهای مبتنی بر LLM |
ساخت از صفر
مرحلهی 1: منطق ماسکگذاری
فایل code/main.py را ببینید. تابع create_mlm_batch فهرستی از شناسههای توکن، اندازهی دایرهی واژگان (vocab size) و احتمال ماسکگذاری را میگیرد. این تابع شناسههای ورودی (با ماسکهای اِعمالشده) و لیبلها را برمیگرداند؛ لیبلها فقط در موقعیتهای ماسکشده مقدار دارند و در بقیهی جاها طبق قرارداد PyTorch برای نادیدهگرفتن ایندکس، برابر با 100- هستند.
def create_mlm_batch(tokens, vocab_size, mask_prob=0.15, rng=None):
    input_ids = list(tokens)
    labels = [-100] * len(tokens)
    for i, t in enumerate(tokens):
        if rng.random() < mask_prob:
            labels[i] = t
            r = rng.random()
            if r < 0.8:
                input_ids[i] = MASK_ID
            elif r < 0.9:
                input_ids[i] = rng.randrange(vocab_size)
            # در غیر این صورت: حالت اصلی حفظ شود
return input_ids, labelsمرحلهی 2: اجرای پیشبینی MLM روی یک پیکرهی کوچک
یک انکودر 2 لایه را بههمراه سربرگ MLM روی واژگانی با 20 کلمه و 200 جمله آموزش دهید. بدون گرادیان — فقط صحت گذر رو به جلو را بررسی میکنیم. آموزش کامل به PyTorch نیاز دارد.
مرحلهی 3: مقایسهی انواع ماسک
نشان دهید که قاعدهی سهگانه چگونه مدل را بدون [MASK] هم کاربردی نگه میدارد. پیشبینی را یک بار روی جملهای بدون ماسک و بار دیگر روی جملهی ماسکدار انجام دهید. هر دو حالت باید توزیعهای معقولی از توکنها بسازند؛ چون مدل در زمان آموزش هر دو الگو را دیده است.
مرحلهی 4: فاینتیون سربرگ
سربرگ MLM را با یک سربرگ دستهبندی روی یک مجموعهدادهی اسباببازی تحلیل احساسات جایگزین کنید. فقط سربرگ آموزش میبیند؛ انکودر فریز است. تمام کاربردهای BERT از همین الگو پیروی میکنند.
استفادهی عملی
from transformers import AutoModel, AutoTokenizer

tok = AutoTokenizer.from_pretrained("answerdotai/ModernBERT-base")
model = AutoModel.from_pretrained("answerdotai/ModernBERT-base")

text = "Attention is all you need."
inputs = tok(text, return_tensors="pt")
out = model(**inputs).last_hidden_state # (1, N, 768)مدلهای امبدینگ همان BERT فاینتیونشده هستند. مدلهای کتابخانهی sentence-transformers مثل all-MiniLM-L6-v2 در واقع مدلهای BERT هستند که با تابع زیان کنتراستیو آموزش دیدهاند. انکودر همان است؛ تابع زیان تغییر کرده است.
بازرتبهبندهای کراسانکودر هم BERTهای فاینتیونشدهاند. دستهبندی جفتی روی ساختار [CLS] query [SEP] doc [SEP]. اتنشن دوطرفه میان پرسوجو (query) و سند (doc) دقیقاً همان چیزی است که به کراسانکودرها برتری کیفی نسبت به بایانکودرها میدهد.
چه زمانی در سال 2026 سراغ BERT نرویم؟ هر تسک تولیدی (generative). انکودر هیچ روش معقولی برای تولید توکنها بهشکل خودبازگشتی (autoregressive) ندارد. همچنین: در مدلهای زیر 1 میلیارد پارامتر که یک دیکودر کوچک میتواند همان کیفیت را با انعطافپذیری بیشتری تحویل دهد (مانند Phi-3-Mini یا Qwen2-1.5B).
پیادهسازی نهایی
فایل outputs/skill-bert-finetuner.md را ببینید. این مهارت، دامنهی کار فاینتیونینگ BERT را برای یک تسک جدید دستهبندی یا استخراج تعیین میکند (انتخاب بکبون، مشخصات سربرگ، دادهها، ارزیابی و توقف آموزش).
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید و توزیع ماسک را روی 10,000 توکن نمایش دهید. مطمئن شوید حدود 15% از توکنها انتخاب شدهاند و از میان آنها نزدیک به 80% تبدیل به[MASK]میشوند. - متوسط. ماسکگذاری کل کلمه (Whole-word masking) را پیاده کنید: اگر کلمهای به چند زیرکلمه شکسته شده است، تمام زیرکلمههای آن را با هم ماسک کنید یا هیچکدام را ماسک نکنید. بررسی کنید آیا این کار دقت MLM را روی یک مجموعهدادهی 500 جملهای بهبود میدهد یا خیر.
- سخت. یک مدل BERT بسیار کوچک (2 لایه، d=64) را روی 10,000 جمله از یک مجموعهدادهی عمومی آموزش دهید. سپس توکن
[CLS]را برای تحلیل احساسات SST-2 فاینتیون کنید. عملکرد آن را با یک بیسلاینِ صرفاً دیکودر (decoder-only) با تعداد پارامتر برابر مقایسه کنید — کدامیک برنده میشود؟
اصطلاحات کلیدی
| اصطلاح | آنچه میگویند | معنای واقعی آن |
|---|---|---|
| MLM | «مدلسازی زبان پوشاندهشده» | سیگنال آموزش: جایگزینی تصادفی 15% از توکنها با [MASK] و پیشبینی موارد اصلی. |
| Bidirectional | «به هر دو طرف نگاه میکند» | اتنشن انکودر هیچ ماسک علیتی ندارد — هر جایگاه همهی موقعیتهای دیگر را میبیند. |
[CLS] |
«توکن پولر» | توکن خاصی که اول هر توالی قرار میگیرد؛ امبدینگ نهایی آن بهعنوان بازنمایی سطح جمله استفاده میشود. |
[SEP] |
«جداکنندهی سگمنت» | جفت توالیها را از هم جدا میکند (مثلاً پرسوجو/سند، جملهی A/B). |
| NSP | «پیشبینی جملهی بعدی» | تسک دوم پیشآموزش BERT؛ نشان داده شد که در RoBERTa بیفایده است و پس از سال 2019 کنار گذاشته شد. |
| Fine-tuning | «سازگار کردن با یک تسک» | ثابت نگه داشتن بخش اعظم انکودر؛ آموزش یک سربرگ کوچک روی آن برای تسک پاییندستی. |
| Cross-encoder | «یک بازرتبهبند» | مدلی از جنس BERT که پرسوجو و سند را با هم بهعنوان ورودی میگیرد و یک امتیاز مرتبط بودن تحویل میدهد. |
| ModernBERT | «بازنگری 2024» | بازسازی انکودر با RoPE ،RMSNorm ،GeGLU، اتنشن متناوب محلی/سراسری و طول بافت 8K. |
برای مطالعهی بیشتر
- Devlin et al. (2018). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding — مقالهی مرجع اصلی.
- Liu et al. (2019). RoBERTa: A Robustly Optimized BERT Pretraining Approach — شیوهی آموزش درست BERT؛ حذف NSP.
- Clark et al. (2020). ELECTRA: Pre-training Text Encoders as Discriminators Rather Than Generators — روش تشخیص توکن جایگزینشده در توان پردازشی برابر، MLM را شکست میدهد.
- Warner et al. (2024). Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder — مقالهی ModernBERT.
- HuggingFace
modeling_bert.py— مرجع اصلی برای معماری انکودر.