
تبدیل صوت به متن همواره یکی از چالشهای پرهزینه در هوش مصنوعی بوده است؛ سیستمهای قدیمی مانند wav2vec 2.0 با پایپلاینهای پیچیده و حساسیت بالا نسبت به نویز، توسعهدهندگان را در پردازش زبانهای گوناگون دچار دردسر میکردند. مدل Whisper با بازتعریف این فرایند و استفاده از معماری انکودر-دکودر استاندارد بر پایهی اسپکتروگرامهای مِل، استانداردی نوین در پایداری و دقت تشخیص گفتار بنا کرد.
در این درس ساختار داخلی Whisper را از ورودیهای صوتی 30 ثانیهای و ساقهی کانولوشنی گرفته تا توکنهای کنترلی تسک و تولید خودبازگشتی متن بررسی میکنید. همچنین یاد میگیرید چگونه پایپلاین پیشپردازش صوتی را خودتان پیاده کرده و مدلهای مدرنی مثل Whisper-turbo یا فریمورکهای سریعی نظیر faster-whisper را برای سناریوهای بلادرنگ به کار ببرید.
اگر قصد دارید این مدلها را در محیط پروداکشن یا سیستم شخصی خود مستقر کنید، مدلهای سبکتر مانند نسخههای Tiny و Base بهسادگی روی پردازندههای معمولی (CPU) اجرا میشوند. برای مدلهای سنگینتر نظیر Large، با توجه به دشواری تهیه و هزینهی بالای GPUهای ابری برای کاربران ایرانی، استفاده از نسخههای کوانتیزهشده یا ابزارهایی مانند faster-whisper روی سیستم محلی راهکاری کاملاً عملی و اقتصادی است.
صوت همان تصویرِ فرکانس در گذر زمان است. Whisper یک مدل ترنسفورمر بینایی (ViT) به حساب میآید که اسپکتروگرام مِل (mel spectrogram) میبلعد و متن پس میدهد.
صورت مسئله
پیش از معرفی Whisper (توسط OpenAI، رادفورد و همکاران، 2022)، پیشرفتهترین مدلهای تشخیص خودکار گفتار (ASR یا Automatic Speech Recognition) مواردی مانند wav2vec 2.0 و HuBERT بودند؛ یعنی استخراجکنندههای ویژگیِ مبتنی بر یادگیری خودنظارتی (Self-supervised learning) به همراه یک سرِ (head) فاینتیونشده. خروجی کیفیت بالایی داشت، اما پایپلاینهای داده بهشدت گرانقیمت بودند و مدلها در دامنههای کاری متفاوت شکننده عمل میکردند. تشخیص گفتار چندزبانه هم نیازمند مدلهای مجزا برای هر خانوادهی زبانی بود.
مدل Whisper روی سه ایدهی اساسی قمار کرد:
- آموزش روی همهچیز. 680,000 ساعت فایل صوتی با برچسبگذاری ضعیف (weakly-labeled) که از اینترنت برای 97 زبان جمعآوری شده بود؛ بدون استفاده از پیکرههای تمیز دانشگاهی و بدون برچسبهای واجی (phoneme).
- یک مدل واحد برای چند وظیفه. یک دکودر واحد که بهصورت همزمان برای رونویسی متن، ترجمه، تشخیص فعالیت صوتی (VAD)، شناسایی زبان و ثبت برچسب زمانی (timestamping) به کمک توکنهای وظیفه آموزش دیده است.
- ترنسفورمر انکودر-دکودر استاندارد. انکودر، اسپکتروگرامهای لگاریتمی مِل را دریافت میکند و دکودر بهشکل خودبازگشتی (autoregressive) توکنهای متن را تولید میکند؛ بدون نیاز به وکودر (vocoder)، CTC یا HMM.
نتیجه اینکه مدل Whisper large-v3 در برابر لهجههای گوناگون، نویز محیطی و زبانهایی با دادههای برچسبدار صفر، بسیار پایدار و مقاوم است. در سال 2026، این مدل رابط ورودی گفتارِ پیشفرض برای همهی دستیارهای صوتی متنباز و اکثر نمونههای تجاری محسوب میشود.
مفاهیم پایه
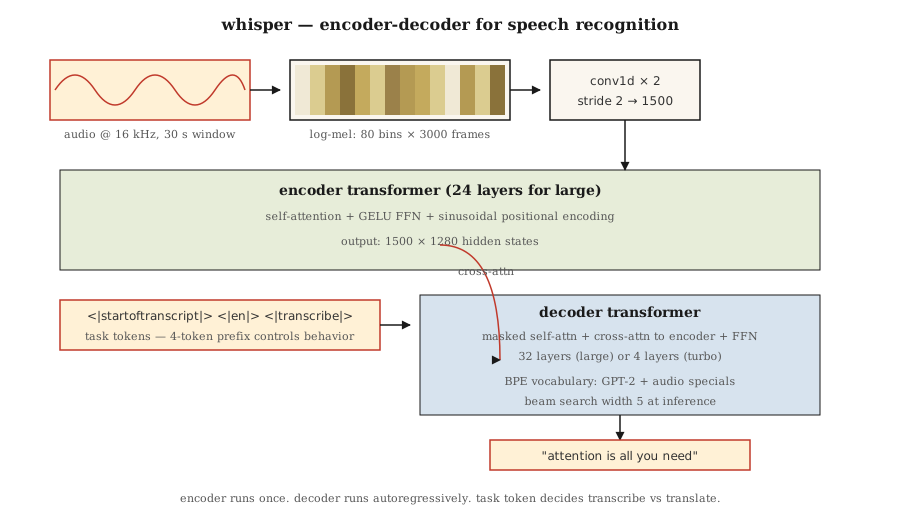
مرحلهی 1 — بازنمونهبرداری + پنجرهبندی
صوت با نرخ 16 kHz نمونهبرداری میشود. صدا به قطعات 30 ثانیهای برش میخورد یا با پدینگ پر میشود. سپس اسپکتروگرام لگاریتمی مِل محاسبه میگردد: 80 خانهی فرکانسی (frequency bin) مِل با استراید (گام لغزش) 10 میلیثانیهای که به حدود 3,000 فریم ضربدر 80 ویژگی تبدیل میشود. این همان «تصویر ورودی» است که Whisper میبیند.
مرحلهی 2 — ساقهی کانولوشنی
دو لایهی Conv1D با کرنل 3 و استراید 2، تعداد 3,000 فریم را به 1,500 فریم کاهش میدهند. این کار طول توالی را به نصف میرساند، بدون آنکه پارامترهای مدل را چندان افزایش دهد.
مرحلهی 3 — انکودر
یک انکودر ترنسفورمر 24 لایهای (در نسخهی large) روی 1,500 گام زمانی. با کدگذاری مکانی (Positional Encoding) سینوسی، اتنشن به خود (self-attention) و شبکهی پیشخور GELU. خروجی آن 1,500 × 1,280 وضعیت پنهان (hidden state) است.
مرحلهی 4 — دکودر
یک دکودر ترنسفورمر 24 لایهای که بهشیوهی خودبازگشتی از دایرهی واژگان BPE (یک ابرمجموعه از واژگان GPT-2 بههمراه چند توکن ویژهی صوتی) توکن تولید میکند.
مرحلهی 5 — توکنهای وظیفه
پرامپت دکودر با توکنهای کنترلی شروع میشود که به مدل فرمان میدهند چه کاری انجام دهد:
<|startoftranscript|> <|en|> <|transcribe|> <|0.00|>یا
<|startoftranscript|> <|fr|> <|translate|> <|0.00|>مدل بر پایهی همین قرارداد آموزش دیده است. شما وظیفهی مدل را با این پیشوند کنترل میکنید؛ چیزی شبیه به نسخهی صوتی فاینتیونینگ دستورپذیر (instruction-tuning) در سال 2026.
مرحلهی 6 — خروجی
الگوریتم جستجوی پرتو (beam search با عرض 5) همراه با یک آستانهی لگاریتم احتمال اعمال میشود. در صورتی که توکن <|notimestamps|> حضور نداشته باشد، برچسبهای زمانی بهازای هر 0.02 ثانیه از صوت پیشبینی میشوند.
اندازههای مدل Whisper
| مدل | پارامترها | لایهها | d_model | سرها | حافظهی گرافیکی (fp16) |
|---|---|---|---|---|---|
| Tiny | 39M | 4 | 384 | 6 | حدود 1 گیگابایت |
| Base | 74M | 6 | 512 | 8 | حدود 1 گیگابایت |
| Small | 244M | 12 | 768 | 12 | حدود 2 گیگابایت |
| Medium | 769M | 24 | 1024 | 16 | حدود 5 گیگابایت |
| Large | 1550M | 32 | 1280 | 20 | حدود 10 گیگابایت |
| Large-v3 | 1550M | 32 | 1280 | 20 | حدود 10 گیگابایت |
| Large-v3-turbo | 809M | 32 | 1280 | 20 | حدود 6 گیگابایت (دکودر 4 لایهای) |
مدل Large-v3-turbo (معرفیشده در 2024) لایههای دکودر را از 32 به 4 کاهش داد. حاصل کار، 8 برابر سرعت بیشتر در دکود با افتی کمتر از 1 امتیاز در نرخ خطای کلمات (WER) بود. همین سرعت فوقالعاده در دکود باعث شده Whisper-turbo انتخاب اول ایجنتهای صوتی بلادرنگ در سال 2026 باشد.
مواردی که Whisper پوشش نمیدهد
- تفکیک گویندگان یا Diarization (چه کسی صحبت میکند). برای این کار باید از ابزارهایی مثل pyannote در کنارش استفاده کنید.
- استریمینگ بلادرنگ بهصورت پیشفرض؛ پنجرهی پردازش 30 ثانیهای ثابت است. ابزارهای مدرنتر (مانند
faster-whisperوWhisperX) قابلیت استریمینگ را با تلفیق VAD و همپوشانی به آن اضافه کردهاند. - درک محتوای طولانیمدت فراتر از 30 ثانیه بدون قطعهبندی متن (chunking) از بیرون. این موضوع در عمل دردسرساز نیست، چون برای رونویسیِ صحبت انسان بهندرت نیاز به زمینهی متنی با دامنهی طولانی خواهید داشت.
وضعیت ابزارها در سال 2026
| وظیفه | مدل | توضیحات |
|---|---|---|
| ASR انگلیسی | Whisper-turbo, Moonshine | مدل Moonshine روی دستگاههای لبه (edge) تا 4 برابر سریعتر است |
| ASR چندزبانه | Whisper-large-v3 | پشتیبانی از 97 زبان |
| ASR استریمینگ | faster-whisper + VAD | امکان رسیدن به تاخیر 150 میلیثانیهای |
| متن به گفتار (TTS) | Piper, XTTS-v2, Kokoro | الگوی انکودر-دکودر با ساختاری مشابه Whisper |
| صوت + زبان | AudioLM, SeamlessM4T | ترکیب توکنهای متن و صوت در یک ترنسفورمر واحد |
پیادهسازی از صفر
کد code/main.py را ببینید. ما قرار نیست Whisper را آموزش دهیم، بلکه پایپلاین اسپکتروگرام لگاریتمی مِل و قالببندی پرامپت توکنهای وظیفه را پیادهسازی میکنیم؛ یعنی همان بخشهایی که در محیط پروداکشن با آنها سر و کار دارید.
مرحلهی 1: تولید صوت مصنوعی
تولید یک موج سینوسی 1 ثانیهای در فرکانس 440 Hz با نرخ نمونهبرداری 16 kHz که شامل 16,000 نمونه میشود.
مرحلهی 2: اسپکتروگرام لگاریتمی مِل (سادهسازیشده)
اسپکتروگرام کامل مِل نیاز به تبدیل فوریه (FFT) دارد. ما نسخهای ساده بر پایهی فریمبندی و انرژی هر فریم میسازیم تا منطق پایپلاین را بدون نیاز به کتابخانهی librosa متوجه شوید:
def frame_signal(x, frame_size=400, hop=160):
    frames = []
    for start in range(0, len(x) - frame_size + 1, hop):
        frames.append(x[start:start + frame_size])
    return frames
طول فریم برابر با 25 میلیثانیه و گام جهش (hop) برابر با 10 میلیثانیه است؛ دقیقاً مثل پنجرهبندی Whisper. در اینجا انرژی هر فریم برای آموزش بهتر جایگزین خانههای فرکانسی مل شده است.
مرحلهی 3: پدینگ تا 30 ثانیه
مدل Whisper همواره بخشهای 30 ثانیهای را پردازش میکند. اسپکتروگرام را تا 3,000 فریم پد (یا برش) دهید.
مرحلهی 4: ساخت توکنهای پرامپت
def whisper_prompt(lang="en", task="transcribe", timestamps=True):
    tokens = ["<|startoftranscript|>", f"<|{lang}|>", f"<|{task}|>"]
    if not timestamps:
        tokens.append("<|notimestamps|>")
    return tokens
تمام رابط کنترلی وظایف مدل همین است: یک پیشوند 4 توکنی.
استفاده از ابزارهای واقعی
import whisper
model = whisper.load_model("large-v3-turbo")
result = model.transcribe("meeting.wav", language="en", task="transcribe")
print(result["text"])
print(result["segments"][0]["start"], result["segments"][0]["end"])
روش سریعتر و سازگار با OpenAI:
from faster_whisper import WhisperModel
model = WhisperModel("large-v3-turbo", compute_type="int8_float16")
segments, info = model.transcribe("meeting.wav", vad_filter=True)
for s in segments:
    print(f"{s.start:.2f} - {s.end:.2f}: {s.text}")
چه زمانی در سال 2026 به سراغ Whisper برویم؟
- نیاز به ASR چندزبانه با یک مدل واحد.
- رونویسی پایدار از فایلهای صوتی شلوغ و با نویز بالا.
- تحقیق یا ساخت نمونههای اولیه (prototype) صوتی؛ چون سریعترین نقطهی شروع است.
چه زمانی از گزینههای دیگر استفاده کنیم؟
- استریمینگ با تاخیر بسیار کم روی دستگاههای لبه؛ مدل Moonshine با کیفیتی معادل، Whisper را شکست میدهد.
- هوش مصنوعی مکالمهای بلادرنگ با تاخیر زیر 200 میلیثانیه که نیازمند ASR اختصاصیِ استریمینگ است.
- تفکیک گویندگان (Diarization)؛ مدل Whisper این کار را انجام نمیدهد و باید pyannote را کنار آن به کار بگیرید.
خروجی این درس
محتوای فایل outputs/skill-asr-configurator.md را بررسی کنید. این مهارت به انتخاب مدل ASR، پارامترهای دکود و پایپلاین پیشپردازش برای یک برنامهی صوتی جدید میپردازد.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. تایید کنید که تعداد فریمها برای سیگنالی 1 ثانیهای در نرخ 16 kHz با گام 10 میلیثانیه حدود 100 فریم است. برای 30 ثانیه این مقدار باید حدود 3,000 فریم باشد. - متوسط. با استفاده از
numpy.fftاسپکتروگرام لگاریتمی کامل مِل را بسازید. بررسی کنید که 80 خانهی فرکانسی ملِ بهدستآمده، با در نظر گرفتن خطای محاسباتی جزئی، با خروجی تابعlibrosa.feature.melspectrogram(n_mels=80)همخوانی داشته باشد. - پیشرفته. استنتاج استریمینگ را پیاده کنید: صوت را به پنجرههای 10 ثانیهای با همپوشانی 2 ثانیهای تقسیم کنید، مدل Whisper را روی هر پنجره اجرا کرده و متنها را merge کنید. نرخ خطای کلمات (WER) را در مقایسه با پردازش یکباره روی یک نمونه پادکست 5 دقیقهای اندازه بگیرید.
اصطلاحات کلیدی
| اصطلاح | آنچه میگویند | معنای واقعی آن |
|---|---|---|
| Mel spectrogram | «تصویر صوت» | نمایشی دوبعدی: خانههای فرکانسی روی یک محور، فریمهای زمانی روی محوری دیگر؛ همراه با انرژی بر مقیاس لگاریتمی در هر خانه. |
| Log-mel | «آنچه Whisper میبیند» | اسپکتروگرام مِل بعد از عبور از تابع لگاریتم؛ رفتاری شبیه به ادراک شنوایی انسان از شدت بلندی صدا دارد. |
| Frame | «یک برش زمانی» | یک پنجرهی 25 میلیثانیهای از نمونههای صوتی با استراید متوالی 10 میلیثانیه. |
| Task token | «پیشوند پرامپت برای گفتار» | توکنهای ویژه مثل <|transcribe|> یا <|translate|> درون پرامپت دکودر. |
| Voice activity detection (VAD) | «پیدا کردن بخشهای گفتار» | سازوکاری که سکوت را پیش از ارسال به ASR حذف میکند و هزینهی پردازش را بهشدت کاهش میدهد. |
| CTC | «دستهبندی زمانی ارتباطگرا» | یک تابع زیان (loss) کلاسیک در ASR برای آموزش بدون نیاز به تراز زمانی دادهها؛ مدل Whisper از آن استفاده نمیکند. |
| Whisper-turbo | «دکودر کوچک، انکودر کامل» | انکودر large-v3 همراه با دکودر 4 لایهای؛ 8 برابر سریعتر در دکود کردن. |
| Faster-whisper | «نسخهی بهینهی پروداکشن» | بازپیادهسازی به کمک کتابخانهی CTranslate2 با کوانتیزاسیون int8؛ تا 4 برابر سریعتر از کد مرجع OpenAI. |
برای مطالعهی بیشتر
- Radford et al. (2022). Robust Speech Recognition via Large-Scale Weak Supervision — مقالهی اصلی Whisper.
- مخزن Whisper در گیتهاب متعلق به OpenAI — کد مرجع به همراه وزنهای مدل. فایل
whisper/model.pyرا مطالعه کنید تا کل ساقهی Conv1D، انکودر و دکودر را در حدود 400 خط کد ببینید. - OpenAI Whisper —
whisper/decoding.py— منطق جستجوی پرتو و توکنهای وظیفه که در مراحل 5 و 6 توضیح داده شد در این فایل است؛ کدی 500 خطی و کاملاً خوانا. - Baevski et al. (2020). wav2vec 2.0: A Framework for Self-Supervised Learning of Speech Representations — اثر پیشگام در این حوزه که استخراج ویژگیهای آن هنوز در برخی شرایط بهترین عملکرد را دارد.
- SYSTRAN/faster-whisper — ابزار محیط پروداکشن که 4 برابر از نسخهی اصلی سریعتر اجرا میشود.
- Jia et al. (2024). Moonshine: Speech Recognition for Live Transcription and Voice Commands — مدل ASR سال 2024 مناسب برای دستگاههای لبه؛ با ساختاری شبیه Whisper اما کمحجمتر.
- پست وبلاگ هاگینگفیس با عنوان "Fine-Tune Whisper For Multilingual ASR with 🤗 Transformers" — راهنمای مرجع فاینتیونینگ از جمله پیشپردازش اسپکتروگرام مل و مدیریت برچسبهای زمانی توکنها.
- فایل
modeling_whisper.pyدر هاگینگفیس — پیادهسازی کامل (انکودر، دکودر، کراساتنشن، تولید متن) که دیاگرام معماری این درس را نمایش میدهد.