
برخلاف مرحلهی آموزش مدلهای زبانی که فرآیندی موازی و محدود به توان پردازشی خام (FLOP-bound) است، مرحلهی استنتاج (Inference) رفتاری کاملاً متوالی دارد و در گلوگاه پهنای باند حافظه (Memory-bound) گرفتار میشود. اگر مدلی را بدون بهینهسازی اجرا کنید، بخش عمدهای از زمان پردازش صرف خواندن و نوشتنهای تکراری روی حافظهی گرافیکی (VRAM) خواهد شد؛ مسئلهای که هزینهی سرویسدهی را به شدت بالا میبرد و سرعت تولید توکن را پایین میآورد.
در شرایطی که دسترسی به پردازندههای گرافیکی قدرتمند دیتاسنتری یا اجارهی نمونههای ابری خارجی به دلیل محدودیتهای پرداخت ارزی و هزینههای بالا دشوار و پرچالش است، اجرای کارآمد و حداکثر استفاده از منابع سختافزاری اهمیت دوچندانی پیدا میکند. تسلط بر تکنیکهای کاهش ردپای حافظه به شما کمک میکند مدلها را روی کارتهای دردسترستر با کمترین منابع ممکن به تولید برسانید.
در این درس یاد میگیرید که چگونه کش KV (KV Cache) محاسبات زائد پیشوند را حذف میکند، فلش اتنشن (Flash Attention) با کاشیکاری در SRAM گلوگاه جابهجایی داده به HBM را دور میزند و فریمورکهای مدرن نظیر vLLM با پجد اتنشن (PagedAttention) بهرهوری حافظه را تا چندین برابر افزایش میدهند.
آموزش، موازی و محدود به توان پردازشی (FLOP-bound) است؛ استنتاج، متوالی و محدود به پهنای باند حافظه (memory-bound). دو گلوگاه متفاوت، ترفندهای متفاوتی هم میطلبند.
صورت مسئله
یک دیکودر خودبازگشت (autoregressive) ساده برای تولید توکن، به اندازهی کار انجام میدهد: در هر گام، محاسبات اتنشن (attention) را روی کل پیشوند از اول تکرار میکند. برای پاسخی با 4K توکن، این یعنی 16M عملیات اتنشن که بیشترشان کاملاً زائد و تکراریاند. وضعیت پنهان (hidden state) هر توکنِ پیشوند به محض محاسبه، قطعی و ثابت است؛ کافی است کوریِ (query) توکن جدید را فقط روی کلیدها (keys) و مقدارهای (values) کششده از توکنهای قبلی اجرا کنید.
علاوه بر این، خود اتنشن حجم عظیمی از داده را جابهجا میکند. اتنشن استاندارد یک ماتریس امتیاز N×N، یک خروجی سافتمکس (softmax) در ابعاد N×d و یک خروجی نهایی N×d در حافظه میسازد؛ یعنی حجم بسیار بالایی از خواندن و نوشتن روی HBM. برای N≥2K، محاسبات اتنشن پیش از آنکه به سقف محاسباتی (FLOPs) برسد، در گلوگاه حافظه گیر میافتد. کرنلهای (kernel) سنتی اتنشن، پردازندههای گرافیکی مدرن را 4 تا 10 برابر کمتر از ظرفیت واقعیشان به کار میگیرند.
دو بهینهسازی که هر دو حاصل کار تری دائو (Dao et al.) هستند، سرعت استنتاج مدلهای پیشرو را از «کُند» به «سریع» رساندند:
- کش KV (یا KV cache): بردارهای K و V مربوط به همهی توکنهای پیشوند را ذخیره کنید. اتنشنِ هر توکن جدید تنها یک کوری در برابر کلیدهای کششده خواهد بود. با این کار، هزینهی استنتاج در هر گام تولید از به کاهش مییابد.
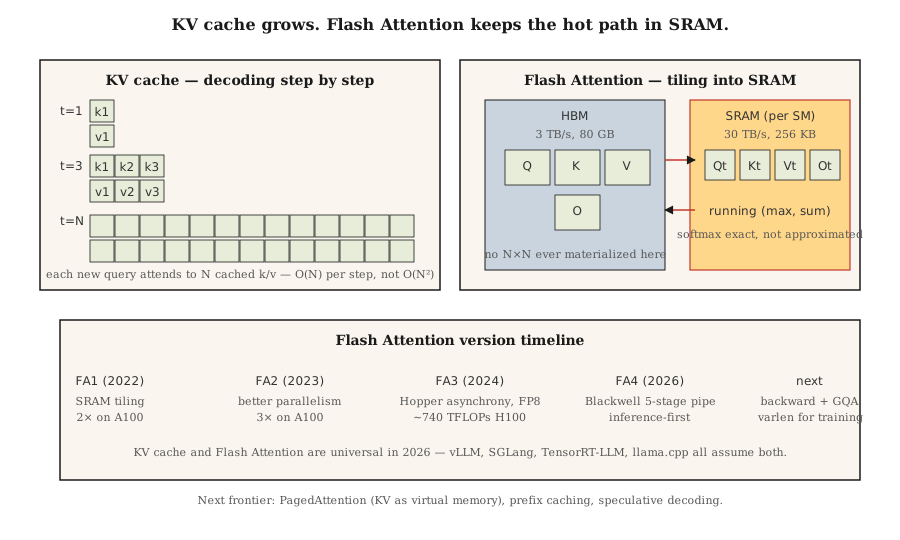
- فلش اتنشن (Flash Attention): محاسبات اتنشن را به صورت کاشیکاریشده (tiling) خرد کنید تا ماتریس کامل N×N هرگز وارد HBM نشود. تمام مراحل سافتمکس به اضافهی ضرب ماتریسی (matmul) درون حافظهی SRAM پردازنده رخ میدهد؛ یعنی 2 تا 4 برابر شتاب زمانی روی A100، و 5 تا 10 برابر روی H100 با دقت FP8.
تا سال 2026، هر دوی این روشها فراگیر و استاندارد شدهاند. تمامی پشتههای استنتاج عملیاتی (مثل vLLM، TensorRT-LLM، SGLang و llama.cpp) پیشفرض را روی آنها میگذارند و تمام مدلهای پیشرو نیز با فلش اتنشنِ فعال عرضه میشوند.
مفاهیم کلیدی
محاسبات ریاضی کش KV
به ازای هر لایه از دیکودر، به ازای هر توکن، و در تمام سرهای (heads) KV:
bytes_per_token_per_layer = 2 * n_kv_heads * d_head * dtype_size
                          ^
                          K and V
برای یک مدل 7B با 32 لایه، 32 سر (که همگی برای K و V استفاده میشوند)، d_head=128 و دقت fp16:
per token per layer = 2 * 32 * 128 * 2 = 16384 bytes (16 KiB)
per token (32 layers) = 512 KiB
per 32K context = 16 GiB
برای مدل Llama 3 70B (شامل 80 لایه، d_head=128 و معماری GQA با 8 سر KV):
per token per layer = 2 * 8 * 128 * 2 = 4096 bytes (4 KiB)
per 32K context = 10 GiB
این 10 GiB در طول توالی 32K، در طول توالی 128K به 40 GiB میرسد؛ یعنی تمام ظرفیت یک GPU از نوع A100 با 40 GB حافظه، آن هم فقط برای کش KV و در اندازهی دستهی (batch size) برابر با 1 پر میشود.
معماری GQA برگ برندهی کش KV است. اگر از MHA با 64 سر KV استفاده میشد، حجم کش 8 برابر بزرگتر و در طول 32K حدود 80 GiB میشد. معماری MLA این فشردهسازی را از این هم فراتر میبرد.
ابعاد را تغییر دهید و بالا و پایین رفتن حجم کش را ببینید. طول توالی یا اندازهی دسته را بالا ببرید تا ببینید چقدر سریع از ظرفیت حافظهی یک GPU عبور میکند:
فلش اتنشن — ترفند کاشیکاری
اتنشن استاندارد:
S = Q @ K^T          (HBM read, N×N, HBM write)
P = softmax(S)       (HBM read, HBM write)
O = P @ V            (HBM read, HBM write)
سه بار رفتوبرگشت به HBM. در پردازندهی H100، پهنای باند HBM برابر با 3 TB/s و پهنای باند SRAM معادل 30 TB/s است. هر بار جابهجایی داده به HBM در مقایسه با نگه داشتن همهچیز روی چیپ، افت سرعتی معادل 10 برابر ایجاد میکند.
فلش اتنشن:
for each block of Q (tile size ~128 × 128):
    load Q_tile into SRAM
    for each block of K, V:
        load K_tile, V_tile into SRAM
        compute S_tile = Q_tile @ K_tile^T     (SRAM)
        running softmax aggregation             (SRAM)
        accumulate into O_tile                  (SRAM)
    write O_tile to HBM
به ازای هر کاشی فقط یک رفتوبرگشت به HBM داریم. ردپای کلی حافظه از به افت میکند. در گام رو به عقب (backward pass) نیز به جای ذخیرهی مقادیر، برخی از دادههای گذر رو به جلو (forward pass) دوباره محاسبه میشوند که خود برگ برندهی دیگری در مصرف حافظه است.
ترفند عددی: سافتمکسِ جاری مقادیر (max, sum) را میان کاشیها بهروز نگه میدارد تا نرمالسازی نهایی کاملاً دقیق باشد. این روش تقریب نیست؛ خروجی فلش اتنشن با اتنشن استاندارد از نظر بیتی کاملاً یکسان است (صرفنظر از خاصیت شرکتپذیری شناورها در fp16).
سیر تکامل نسخهها:
| نسخه | سال | تغییر کلیدی | شتاب روی سختافزار مرجع |
|---|---|---|---|
| Flash 1 | 2022 | کرنل کاشیکاریشده در SRAM | 2 برابر روی A100 |
| Flash 2 | 2023 | موازیسازی بهتر، اولویتدهی علّی (causal-first) | 3 برابر روی A100 |
| Flash 3 | 2024 | ناهمگامی (asynchrony) در Hopper، دقت FP8 | 1.5 تا 2 برابر روی H100 (حدود 740 TFLOPs در FP16) |
| Flash 4 | 2026 | پایپلاین 5 مرحلهای Blackwell، تابع نرمافزاری exp2 | تمرکز بر استنتاج (در ابتدا فقط گذر رو به جلو) |
فلش 4 در زمان عرضه فقط از گذر رو به جلو پشتیبانی میکند؛ بنابراین برای آموزش همچنان از فلش 3 استفاده میشود. پشتیبانی از GQA و طول متغیر (varlen) در فلش 4 در دست اقدام است (اواسط 2026).
رمزگشایی حدسی — دستاورد بعدی در کاهش تاخیر
یک مدل ارزان و سبک N توکن را پیشنهاد میدهد؛ سپس مدل بزرگ همهی این N توکن را به شکل موازی اعتبارسنجی میکند. اگر فرآیند اعتبارسنجی k توکن را تایید کند، شما تنها با هزینهی 1 گذر رو به جلو در مدل بزرگ، k توکن تولید کردهاید. در سناریوهای رایج کدنویسی و متنهای معمول، k معمولاً بین 3 تا 5 است.
گزینههای پیشفرض در سال 2026:
- EAGLE 2 / Medusa: سرهای پیشنویس (draft heads) یکپارچهای که از وضعیتهای پنهان مدل اعتبارسنج استفاده میکنند؛ 2 تا 3 برابر شتاب بدون هیچ افت کیفیتی.
- رمزگشایی حدسی (Speculative decoding) با مدل پیشنویس: 2 تا 4 برابر شتاب روی سختافزارهای تجاری و مصرفی.
- رمزگشایی با نگاه به جلو (Lookahead decoding): بر پایهی تکرار یاکوبی (Jacobi iteration)؛ بدون نیاز به مدل پیشنویس. کاربرد خاصی دارد ولی هزینهی اضافی ندارد.
دستهبندی پیوسته (Continuous Batching)
پردازش دستهای کلاسیک در استنتاج: منتظر بمانید تا کُندترین توالی تمام شود و سپس دستهی جدید را شروع کنید. این کار به خاطر پایان زودهنگام پاسخهای کوتاه، منابع GPU را هدر میدهد.
دستهبندی پیوسته (اولین بار در Orca و اکنون در vLLM، TensorRT-LLM و SGLang): به محض تمام شدن درخواستهای قبلی، درخواستهای جدید را بلافاصله وارد دسته کنید. این ترفند برای بارهای کاری معمول چت، نرخ پردازش (throughput) را 5 تا 10 برابر بالا میبرد.
پجد اتنشن (PagedAttention) — کش KV به عنوان حافظهی مجازی
ویژگی شاخص vLLM. کش KV در بلوکهای 16 توکنی تخصیص مییابد و یک جدول صفحه (page table) موقعیتهای منطقی را به بلوکهای فیزیکی نگاشت میکند. این قابلیت امکان اشتراکگذاری KV بین نمونههای موازی (مثل جستجوی پرتو یا نمونهبرداری موازی)، جابهجایی سریع پیشوندها برای کش کردن پرامپت، و رفع تکهتکه شدن حافظه را فراهم میسازد؛ در نتیجه در مقایسه با تخصیص ساده و پیوسته در حافظه (contiguous)، نرخ پردازش تا 4 برابر بهتر میشود.
پیادهسازی
کد code/main.py را ببینید. موارد زیر را پیادهسازی میکنیم:
- یک دیکودر تدریجی ساده از مرتبهی .
- یک دیکودر مجهز به کش KV از مرتبهی .
- یک سافتمکس کاشیکاریشده که الگوریتم بیشینهی پویای فلش اتنشن را شبیهسازی میکند.
گام 1: کش KV
class KVCache:
    def __init__(self, n_layers, n_heads, d_head):
        self.K = [[[] for _ in range(n_heads)] for _ in range(n_layers)]
        self.V = [[[] for _ in range(n_heads)] for _ in range(n_layers)]

    def append(self, layer, head, k, v):
        self.K[layer][head].append(k)
        self.V[layer][head].append(v)

    def read(self, layer, head):
        return self.K[layer][head], self.V[layer][head]
روال ساده است: به ازای هر توکن، بردارهای K و V را در لیستهای مربوط به هر لایه و هر سر ذخیره کرده و گسترش دهید.
گام 2: سافتمکس کاشیکاریشده
def tiled_softmax_dot(q, K, V, tile=4):
    """Flash-attention-style softmax(qK^T)V with running max/sum."""
    m = float("-inf")
    s = 0.0
    out = [0.0] * len(V[0])
    for start in range(0, len(K), tile):
        k_block = K[start:start + tile]
        v_block = V[start:start + tile]
        scores = [sum(qi * ki for qi, ki in zip(q, k)) for k in k_block]
        new_m = max(m, *scores)
        exp_old = math.exp(m - new_m) if m != float("-inf") else 0.0
        exp_new = [math.exp(sc - new_m) for sc in scores]
        s = s * exp_old + sum(exp_new)
        for j in range(len(out)):
            out[j] = out[j] * exp_old + sum(e * v[j] for e, v in zip(exp_new, v_block))
        m = new_m
    return [o / s for o in out]
خروجی از نظر بیتی کاملاً مشابه با اجرای یکبارهی softmax(qK) V است؛ با این تفاوت که در هر لحظه، حجم دادهی فعال در حافظه یک بلوک tile × d_head است، نه کل N × d_head.
گام 3: مقایسهی دیکودر ساده با دیکودر مجهز به کش در تولید 100 توکن
تعداد محاسبات اتنشن را میشماریم. حالت ساده: = 5050. حالت مجهز به کش: = 100. کد، خروجی هر دو حالت را چاپ میکند.
استفادهی عملی
# کتابخانه HuggingFace transformers کَش KV را در generate() مدلهای decoder-only بهطور خودکار فعال میکند.
from transformers import AutoModelForCausalLM
model = AutoModelForCausalLM.from_pretrained(
"meta-llama/Llama-3.2-3B",
attn_implementation="flash_attention_2", # use FA3 if Hopper
torch_dtype="bfloat16",
)
# generate() uses KV cache automaticallyدر محیط عملیاتی با vLLM:
pip install vllm
vllm serve meta-llama/Llama-3.1-70B-Instruct \
    --tensor-parallel-size 4 \
    --max-model-len 32768 \
    --enable-prefix-caching \
    --kv-cache-dtype fp8
کش کردن پیشوند میان درخواستهای مختلف (Prefix caching) یکی از دستاوردهای بزرگ سال 2026 است؛ پرامپت ثابت سیستم، مثالهای چندشات (few-shot)، یا اسناد متنی طولانی، همگی کش KV خود را میان فراخوانیهای گوناگون به اشتراک میگذارند. در بارهای کاری ایجنتها که پرامپتهای مربوط به ابزارها مدام تکرار میشوند، کش پیشوند نرخ پردازش را به طور معمول 5 برابر افزایش میدهد.
جمعبندی و استقرار
فایل outputs/skill-inference-optimizer.md را بررسی کنید. این مهارت نحوه پیادهسازی اتنشن، استراتژی کش KV، کوانتیزاسیون و رمزگشایی حدسی را متناسب با محیط استنتاجی جدید انتخاب میکند.
تمرینها
- ساده: کد
code/main.pyرا اجرا کنید. مطمئن شوید خروجی هر دو دیکودر ساده و کشدار یکی است و اختلاف تعداد محاسبات را بررسی کنید. - متوسط: کش پیشوند را پیادهسازی کنید: با فرض یک پرامپت P و چندین خروجی تکمیلی مختلف، ابتدا یک گذر رو به جلو روی P اجرا کنید تا کش KV پر شود، سپس محاسبات را برای هر خروجی در یک branch جدا ادامه دهید. شتاب به دست آمده را در مقایسه با بازخوانی و انکود مجدد P بسنجید.
- سخت: یک PagedAttention ساده بسازید: کش KV را در قالب بلوکهای ثابت 16 توکنی همراه با یک لیست از بلوکهای آزاد پیاده کنید. وقتی یک توالی تمام شد، بلوکهای آن را به مخزن برگردانید. 1,000 خروجی چت با طولهای گوناگون را شبیهسازی کنید و میزان تکهتکه شدن حافظه را با تخصیص پیوسته در حافظه بسنجید.
اصطلاحات کلیدی
| اصطلاح | در گفتار عامیانه | معنای دقیق فنی |
|---|---|---|
| کش KV (KV cache) | «ترفندی که استنتاج را سریع میکند» | ذخیرهی K و V مربوط به همهی توکنهای پیشوند؛ کوریهای جدید به جای محاسبهی مجدد، روی همینها اتنشن میزنند. |
| HBM | «حافظهی اصلی GPU» | حافظهی با پهنای باند بالا (High Bandwidth Memory)؛ معادل 80 GB در H100 و 192 GB در B200 با پهنای باند حدود 3 TB/s. |
| SRAM | «حافظهی روی چیپ» | حافظهی سریع داخلی در هر SM، حدود 256 KB به ازای هر SM در H100 با پهنای باند حدود 30 TB/s. |
| فلش اتنشن (Flash Attention) | «کرنل اتنشن کاشیکاریشده» | اتنشن را بدون ساختن ماتریس کامل N×N در حافظهی HBM محاسبه میکند. |
| دستهبندی پیوسته (Continuous batching) | «دستهبندی بدون انتظار» | جایگزینی بیدرنگ توالیهای تمامشده با درخواستهای جدید، بدون خالی کردن کل دسته. |
| پجد اتنشن (PagedAttention) | «برگ برندهی vLLM» | تخصیص کش KV در بلوکهای ثابت با یک جدول صفحه؛ از بین بردن تکهتکه شدن حافظه. |
| کش پیشوند (Prefix caching) | «استفادهی دوباره از پرامپتهای طولانی» | کش کردن مقادیر KV برای پیشوندهای مشترک میان درخواستها؛ کاهش محسوس هزینهها در ایجنتها. |
| رمزگشایی حدسی (Speculative decoding) | «پیشنویس + اعتبارسنجی» | یک مدل سبک چند توکن پیشنهاد میدهد و مدل اصلی k تای آنها را در یک گذر تایید میکند. |
برای مطالعهی بیشتر
- Dao et al. (2022). FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness — فلش 1.
- Dao (2023). FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning — فلش 2.
- Shah et al. (2024). FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision — فلش 3.
- یادداشتهای انتشار FlashAttention-4 (در Dao-AILab سال 2026) — پایپلاین 5 مرحلهای Blackwell و ترفند exp2 نرمافزاری؛ توضیحات README مخزن را دربارهی محدودیتهای اولیهی آن (فقط گذر رو به جلو) که در متن درس هم اشاره شد بخوانید.
- Kwon et al. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention — مقالهی vLLM.
- Leviathan et al. (2023). Fast Inference from Transformers via Speculative Decoding — رمزگشایی حدسی.
- Li et al. (2024). EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty — مقالهی EAGLE-1/2 برای بررسی راهکار پیشنویس ادغامشده که در درس به آن اشاره شد.
- Cai et al. (2024). Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads — معماری Medusa که در کنار EAGLE مطرح شد.
- مستندات vLLM — پجد اتنشن (PagedAttention) — مستندات مرجع برای درک عمیق طراحی بلوکهای 16 توکنی و جدول صفحه.