
در ساخت دستیارهای صوتی سنتی، پایپلاین متوالی ASR سپس LLM و در نهایت TTS تاخیری بین 300 تا 500 میلیثانیه ایجاد میکند. این تاخیر مانع از یک مکالمه طبیعی، همراه با قطع صحبت (Interruption) یا بازخوردهای کلامی همزمان میشود. با ظهور مدلهای گفتاربهگفتار تمامدوطرفه (Full-duplex) مانند Moshi و Hibiki، صوت مستقیماً به صوت تبدیل میشود و تاخیر مکالمه به حدود 200 میلیثانیه کاهش مییابد.
این درس به کالبدشکافی معماری این مدلها، نقش کدک عصبی Mimi و مفهوم تکگویی درونی (Inner Monologue) میپردازد تا بتوانید تفاوت ساختاری این مدلهای یکپارچه را با سیستمهای سنتی درک کنید و برای کاربردهای مکالمهای زنده تصمیم درستی بگیرید.
اگر قصد تست یا اجرای محلی این مدلها یا دانلود وزنهای آنها از Hugging Face را داشته باشید، با توجه به حجم بالای مدلها و ناپایداریهای اتصال شبکه، ممکن است به تنظیم ابزارهای دانلود یا آینههای مناسب نیاز پیدا کنید. همچنین اجرای چنین مدلهایی روی یک نشست کامل، به کارت گرافیک مناسب (مانند سری L4) نیاز دارد که با توجه به چالشهای دسترسی به پردازندههای گرافیکی ابری خارجی باید در طراحی سیستم لحاظ شود.
سالهای 2024 تا 2026 تعریف هوش مصنوعی صوتی را دگرگون کردند. Moshi در قالب مدلی یکپارچه عرضه شد که همزمان میشنود و با تاخیر 200 میلیثانیهای صحبت میکند. Hibiki کار ترجمهی گفتاربهگفتار (speech-to-speech) را تکهبهتکه (chunk-by-chunk) انجام میدهد. هر دو مدل، پایپلاین سنتی ASR → LLM → TTS را کنار گذاشته و به یک معماری یکپارچهی تمامدوطرفه (full-duplex) روی توکنهای کدک Mimi روی آوردهاند؛ این رویکرد، طرح مرجع استاندارد جدید است.
صورت مسئله
تمام ایجنتهای صوتی که در درسهای 11 و 12 ساختیم، یک کف تاخیر بنیادی در محدودهی 300 تا 500 میلیثانیه دارند: VAD فعال میشود، STT پردازش میکند، LLM به استدلال میپردازد و در نهایت TTS صوت را میسازد. هر مرحله حداقل تاخیر خاص خودش را دارد. هرچقدر هم تنظیمات را دستکاری و مراحل را موازی کنید، ساختار خطی پایپلاین برایتان محدودیت ایجاد میکند.
مدل Moshi (توسعهیافته در Kyutai، سالهای 2024 تا 2026) پرسش متفاوتی را مطرح میکند: چه میشود اگر اصلاً پایپلاینی در کار نباشد؟ اگر یک مدل واحد، صوت را پیوسته و مستقیماً تحویل بگیرد و صدا تولید کند، و در این میان متن صرفاً نقش یک «تکگویی درونی» (inner monologue) میانی را داشته باشد نه یک مرحلهی اجباری؟
پاسخ، گفتاربهگفتار تمامدوطرفه است. تاخیر نظری آن 160 میلیثانیه است (فریم 80 میلیثانیهای Mimi بهعلاوهی 80 میلیثانیه تاخیر آکوستیک). تاخیر عملیاتی روی یک کارت گرافیک L4 به 200 میلیثانیه میرسد؛ یعنی نصف تاخیر بهترین ایجنتهای صوتی مبتنی بر پایپلاین.
مفاهیم کلیدی
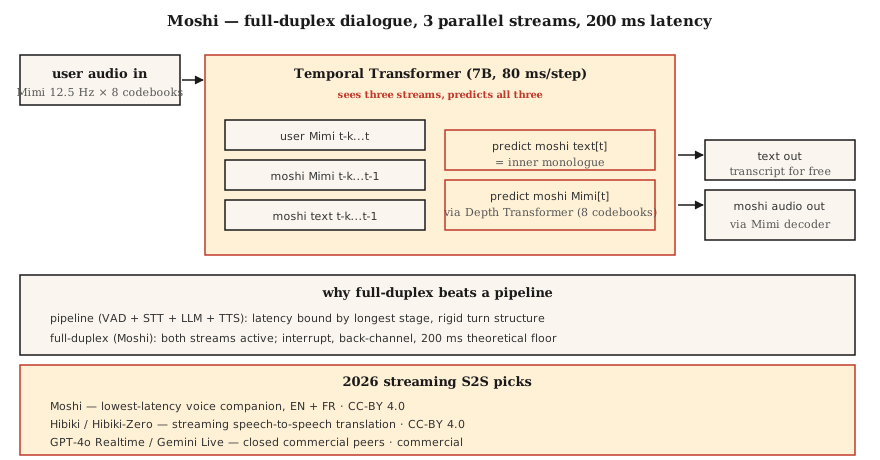
معماری Moshi
ورودیها. دو استریم کدک Mimi، هر دو با نرخ 12.5 Hz در 8 کتابچهی کد (codebook):
- استریم 1: صدای کاربر (کدگذاریشده با Mimi که پیوسته دریافت میشود)
- استریم 2: صدای خود Moshi (تولیدشده توسط مدل)
ترنسفورمر. یک ترنسفورمر زمانی (Temporal Transformer) با 7 میلیارد پارامتر، هر دو استریم و یک استریم متنی «تکگویی درونی» را پردازش میکند. این مدل در هر گام 80 میلیثانیهای:
- آخرین توکنهای Mimi کاربر را دریافت میکند (8 کتابچهی کد).
- جدیدترین توکنهای Mimi تولیدشدهی Moshi را دریافت میکند (8 کتابچهی کد، همزمان با تولید).
- توکن متنی بعدی Moshi را تولید میکند (تکگویی درونی).
- توکنهای Mimi بعدی Moshi را تولید میکند (8 کتابچهی کد از طریق یک ترنسفورمر عمق کوچک).
هر سه استریم — صدای کاربر، صدای Moshi و متن Moshi — موازی اجرا میشوند. Moshi میتواند هنگام صحبت کردن، صدای کاربر را بشنود؛ با قطع کلام از طرف کاربر، صحبتش را متوقف کند؛ و بدون شکستن جریان کلام اصلیاش، بازخوردهای کلامی کوتاه (مثل «اوومهوم») بدهد (back-channel).
ترنسفورمر عمق (Depth transformer). در یک فریم، این 8 کتابچهی کد موازی پیشبینی نمیشوند؛ چون به یکدیگر وابستگی دارند. یک ترنسفورمر عمق کوچک 2 لایهای، آنها را پشت سر هم و در بازهی 80 میلیثانیهای پیشبینی میکند. این روش، فاکتورگیری استاندارد برای مدلهای زبانی کدک خودهمبسته (AR codec LMs) است (که در VALL-E و VibeVoice نیز استفاده میشود).
چرا متن تکگویی درونی راهگشاست؟
بدون وجود متن صریح، مدل ناچار است ساختار زبان را بهصورت ضمنی درون استریم آکوستیک خود مدلسازی کند. ابتکار Moshi در این است که مدل را وادار میکند همزمان با صوت، توکنهای متنی را هم تولید کند. این استریم متنی در واقع همان متن پیادهشدهی حرفهایی است که Moshi میزند. این کار انسجام معنایی را بالا میبرد، تعویض سر (head) مدل زبانی را سادهتر میکند و متن پیادهشده را هم بدون هیچ هزینهای در اختیارتان میگذارد.
مدل Hibiki: ترجمهی گفتاربهگفتار استریمینگ
همان معماری را تصور کنید که روی جفتدادههای ترجمه آموزش دیده است. صوت مبدأ را میگیرد و پیوسته صدای زبان مقصد را تحویل میدهد. مدل Hibiki-Zero (فوریه 2026) نیاز به دادههای آموزشی همترازشده در سطح کلمه (word-level aligned) را حذف کرده است؛ این مدل از دادههای سطح جمله بههمراه بهینهسازی تاخیر با یادگیری تقویتی (Reinforcement Learning) به روش GRPO بهره میبرد.
در ابتدا از چهار جفتزبان پشتیبانی میکرد؛ برای سازگار کردن آن با یک زبان جدید، به حدود 1000 ساعت داده نیاز است.
اکوسیستم گستردهتر Kyutai (سال 2026)
- Moshi — گفتوگوی تمامدوطرفه (در ابتدا فرانسوی، با پشتیبانی کامل از انگلیسی)
- Hibiki / Hibiki-Zero — ترجمهی همزمان گفتار
- Kyutai STT — بازشناسی گفتار (ASR) استریمینگ (با پنجرهی پیشنگری 500 میلیثانیهای یا 2.5 ثانیهای)
- Kyutai Pocket TTS — مدل تبدیل متن به گفتار با 100 میلیون پارامتر که روی CPU اجرا میشود (ژانویه 2026)
- Unmute — پایپلاین کاملی که همهی این ابزارها را روی سرورهای عمومی ترکیب میکند
نرخ پردازش (Throughput) روی یک پردازندهی گرافیکی L40S: اجرای همزمان 64 نشست با سرعتی معادل 3 برابر زمان واقعی.
مدل Sesame CSM — عضو همخانواده
مدل Sesame CSM (سال 2025) از ایدهی مشابهی بهره میبرد — یک بکبون (Backbone) از نوع Llama-3 با یک سر کدک Mimi. اما CSM بهجای تمامدوطرفه، یکطرفه عمل میکند (بافتار و متن را میگیرد و گفتار تولید میکند). این مدل بهترین TTS از نظر «حس حضور صدا» (voice presence) در بازار است؛ اما قابلیت تمامدوطرفهی Moshi را ندارد.
ارقام عملکردی در سال 2026
| مدل | تاخیر | کاربرد | مجوز |
|---|---|---|---|
| Moshi | 200 ms (روی L4) | گفتوگوی تمامدوطرفهی انگلیسی / فرانسوی | CC-BY 4.0 |
| Hibiki | نرخ فریم 12.5 Hz | ترجمهی استریمینگ فرانسوی ↔ انگلیسی | CC-BY 4.0 |
| Hibiki-Zero | مشابه | 5 جفتزبان، بدون دادههای همترازشده | CC-BY 4.0 |
| Sesame CSM-1B | 200 ms تا اولین صوت (TTFA) | تبدیل متن به گفتار بر اساس بافتار | Apache-2.0 |
| GPT-4o Realtime | حدود 300 ms | سورسبسته، API شرکت OpenAI | تجاری |
| Gemini 2.5 Live | حدود 350 ms | سورسبسته، API شرکت Google | تجاری |
پیادهسازی
گام 1: رابط تعاملی
مدل Moshi یک سرور WebSocket ارائه میدهد که تکههای 80 میلیثانیهای صدای کدگذاریشده با Mimi را میگیرد و خروجیهایی با همان مشخصات برمیگرداند. دوطرفه و کاملاً پیوسته.
import asyncio
import websockets
from moshi.client_utils import encode_audio_mimi, decode_audio_mimi

async def moshi_chat():
    async with websockets.connect("ws://localhost:8998/api/chat") as ws:
        mic_task = asyncio.create_task(stream_mic_to(ws))
        spk_task = asyncio.create_task(stream_from_to_speaker(ws))
        await asyncio.gather(mic_task, spk_task)
گام 2: حلقهی پردازش تمامدوطرفه
async def stream_mic_to(ws):
    async for chunk_80ms in mic_stream_at_12_5_hz():
        mimi_tokens = encode_audio_mimi(chunk_80ms)
        await ws.send(serialize(mimi_tokens))

async def stream_from_to_speaker(ws):
    async for msg in ws:
        mimi_tokens, text_token = deserialize(msg)
        audio = decode_audio_mimi(mimi_tokens)
        await play(audio)
هر دو مسیر همزمان اجرا میشوند. استفاده از asyncio در Python یا futures در Rust، پروتکلهای استاندارد انتقال داده در این معماری هستند.
گام 3: تابع هدف آموزش (مفهومی)
برای هر فریم 80 میلیثانیهای t:
- ورودی:
user_mimi[0..t]،moshi_mimi[0..t-1]،moshi_text[0..t-1] - پیشبینی: ابتدا
moshi_text[t]، سپسmoshi_mimi[t, codebook_0..7]
متن پیش از صوت پیشبینی میشود (تکگویی درونی)؛ و سپس در ترنسفورمر عمق، کتابچههای کد صوتی پشت سر هم پیشبینی میشوند.
گام 4: نقاط قوت و ضعف Moshi
نقاط قوت Moshi:
- تاخیر زیر 250 میلیثانیه در کل مسیر رفتوبرگشت روی سختافزارهای ارزانقیمت.
- واکنشهای کلامی کوتاه طبیعی و مدیریت روان قطع صحبت توسط کاربر.
- بینیازی از کدهای واسط پایپلاین (glue code).
نقاط ضعف Moshi:
- فراخوانی ابزار (Tool call)؛ برای این کار آموزش ندیده است و به یک مسیر LLM جداگانه نیاز دارید.
- استدلالهای طولانی (Moshi یک مدل گفتوگوی حدوداً 8 میلیاردی است، نه مدلی در ابعاد Claude یا GPT-4).
- درستی فکتها در موضوعات تخصصی.
- بیشتر کاربردهای عملیاتی سازمانی (که در سال 2026 هنوز از پایپلاینها استفاده میکنند).
موارد استفاده
| موقعیت | انتخاب مناسب |
|---|---|
| همنشین صوتی با کمترین تاخیر ممکن | Moshi |
| تماس ترجمهی زنده | Hibiki |
| دموی صوتی یا کارهای تحقیقاتی | Moshi، CSM |
| ایجنت سازمانی مجهز به ابزارها | معماری پایپلاین (درس 12)، نه Moshi |
| تبدیل متن به گفتار با صدای سفارشی و متناسب با بافتار | Sesame CSM |
| گفتاربهگفتار در تمام زبانها | GPT-4o Realtime یا Gemini 2.5 Live (تجاری) |
دامها و چالشها
- محدودیت در فراخوانی ابزار. Moshi یک مدل گفتوگو است، نه یک فریمورک ایجنتی. برای فراخوانی ابزارها باید آن را با یک پایپلاین ترکیب کنید.
- شرطیسازی روی صدای خاص. Moshi با یک کاراکتر صوتی آموزشدیده کار میکند؛ کلون کردن صدا به یک دورهی آموزشی جداگانه نیاز دارد.
- پوشش زبانی. برای زبانهای فرانسوی و انگلیسی عالی است، اما سایر زبانها محدودند. Hibiki-Zero این فاصله را کم میکند، ولی همچنان به دادههای آموزشی نیاز دارید.
- هزینهی منابع پردازشی. هر نشستِ فعال Moshi، یک اسلات GPU را درگیر نگه میدارد؛ این مدل برای استقرار اشتراکی و ارزانقیمت (shared-tenant) مناسب نیست.
تحویل پروژه
این فایل را در مسیر outputs/skill-duplex-pipeline.md ذخیره کنید. برای یک سناریوی کاری در ایجنت صوتی، بین معماری پایپلاین و تمامدوطرفه یکی را انتخاب کنید و دلیل فنی آن را بنویسید.
تمرینها
- ساده. فایل
code/main.pyرا اجرا کنید. این کد معماری دو استریم بههمراه تکگویی درونی را بهصورت نمادین شبیهسازی میکند. - متوسط. مدل Moshi را از HuggingFace دانلود کنید، سرور آن را بالا بیاورید و یک مکالمه را تست کنید. تاخیر زمانی واقعی (wall-clock latency) را از پایان صحبت کاربر تا شروع پاسخ Moshi بسنجید.
- سخت. ایجنت پایپلاین درس 12 را بردارید و تاخیر P50 آن را با Moshi روی 20 عبارت تستی یکسان مقایسه کنید. بنویسید در چه شرایطی یک معماری پایپلاین از نظر ساختاری همچنان دست برتر را دارد.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها | معنای دقیق فنی |
|---|---|---|
| تمامدوطرفه (Full-duplex) | شنیدن و گفتن همزمان | دو استریم صوتی فعال همزمان روی یک مدل مشترک. |
| تکگویی درونی (Inner monologue) | استریم متنی مدل | تولید توکنهای متنی توسط Moshi در کنار خروجی صوتیاش. |
| ترنسفورمر عمق (Depth transformer) | پیشبینیکنندهی بین کتابچههای کد | ترنسفورمر کوچکی که 8 کتابچهی کد را در بازهی یک فریم 80 میلیثانیهای پیشبینی میکند. |
| میمی (Mimi) | کدک توسعهدادهشده در Kyutai | نرخ 12.5 Hz در 8 کتابچهی کد؛ حامل ویژگیهای معنایی و آکوستیک؛ زیربنای Moshi. |
| گفتاربهگفتار استریمینگ (Streaming S2S) | صوت به صوت زنده | ترجمه یا گفتوگوی تکهبهتکه، بدون مراحل تفکیکشدهی پایپلاین. |
| بازخورد کلامی کوتاه (Back-channeling) | واکنشهایی مثل «اوومهوم» | توانایی Moshi در دادن بازخوردهای تایید کوتاه بدون قطع کردن نوبت صحبت خودش. |
برای مطالعهی بیشتر
- Défossez et al. (2024). Moshi — speech-text foundation model — مقالهی اصلی.
- Kyutai Labs (2026). Hibiki-Zero — ترجمهی استریمینگ بدون دادههای همترازشده.
- Sesame (2025). Crossing the uncanny valley of voice — مستندات فنی CSM.
- Kyutai — Moshi repo — ریپازیتوری نصب و اجرای سرور.
- OpenAI — Realtime API — رقیب تجاری و سورسبسته.
- Kyutai — Delayed Streams Modeling — فریمورک پایه برای ساخت STT و TTS.