
تشخیص رویدادهای محیطی، شناسایی زبان، تفکیک فرمانهای صوتی و تحلیل احساسات گوینده همگی زیرمجموعهی مسالهی طبقهبندی صدا (audio classification) هستند. اگر در توسعهی نرمافزارهای ایرانی با پردازش دادههای گفتاری یا سیگنالهای صوتی روبهرو شده باشید، احتمالاً میدانید که برخلاف حوزهی تصویر یا متن، چالش اصلی لزوماً معماری مدل نیست؛ بلکه نویز محیط، توزیع نامتوازن کلاسها و نحوهی استخراج ویژگیهای طیفی تعیینکننده است.
در این درس یاد میگیرید چطور از یک خط پایهی بسیار سبک و بدون نیاز به GPU مثل k-NN روی ویژگیهای MFCC شروع کنید، به معماریهای کانولوشنی 2D روی طیفنگارهای log-mel برسید و در نهایت مدلهای ترنسفورمر قدرتمندی مانند AST و BEATs را روی تسک صوتی خود فاینتیون کنید.
برای اجرای کدهای پایه، استخراج ضرایب و حتی آموزش مدلهای سبک به کارت گرافیکهای گرانقیمت خارجی نیاز ندارید و روی CPU یا پردازندههای معمولی نیز قابل پیادهسازی هستند. البته برای دانلود وزنهای اولیهی مدلها از مخازنی مانند Hugging Face Hub، با توجه به ناپایداریهای معمول شبکه در ایران، ممکن است استفاده از ابزارهای مدیریت دانلود یا تنظیم میرور کمکتان کند.
از «پارس سگ در برابر آژیر خطر» گرفته تا «این چه زبانی است»، همگی در حوزهی طبقهبندی صدا (audio classification) قرار میگیرند. ویژگیها از جنس مقیاس مِل (mel) هستند. معماریها با هر دهه تغییر میکنند، اما معیارهای ارزیابی دستنخورده باقی میمانند: AUC، F1 و بازخوانی به ازای هر کلاس.
صورت مسئله
یک کلیپ صوتی 10 ثانیهای دریافت میکنید و میخواهید بدانید: «این چیست؟» صدای شهری (آژیر، دریل، سگ)، فرمان صوتی (بله/خیر/توقف)، تشخیص زبان (en/es/ar)، حسوحال گوینده (عصبانی/خنثی) یا صدای محیطی (فضای بسته/باز، همهمهی جمعیت). همهی اینها مصداق طبقهبندی صدا هستند، و در سال 2026 معماری پایهی استاندارد کاملاً جا افتاده است: تبدیل log-mel ← شبکه عصبی کانولوشنی (CNN) یا ترنسفورمر ← سافتمکس.
چالش اصلی ساختار شبکه نیست؛ داده است. دیتاستهای صوتی با عدمتوازن کلاسها (class imbalance) شدید، جابهجایی شدید دامنه دادهها (دادهی تمیز در برابر نویزی) و برچسبهای آلوده و مبهم (چه کسی مرز بین «همهمهی شهری» و «صدای رستوران» را تعیین کرده؟) روبهرو هستند. 80 درصد کار، جمعآوری داده، افزایش داده (augmentation) و ارزیابی است؛ نه صرفاً جایگزین کردن CNN با ترنسفورمر.
مفاهیم پایه
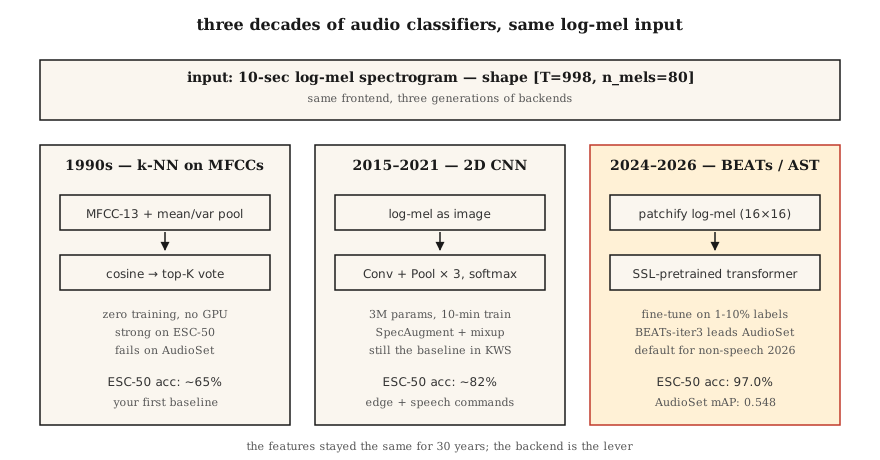
الگوریتم k-NN روی MFCCها (خط پایهی دههی 1990). ضرایب کپسترال فرکانس مل (MFCC) را برای هر کلیپ تخت (flatten) کنید، شباهت کسینوسی آن را نسبت به یک بانک نمونههای برچسبدار بسنجید و رأی اکثریت K همسایهی نزدیک را برگردانید. این روش روی دیتاستهای تمیز و کوچک (مثل Speech Commands یا ESC-50) خروجی شگفتآوری دارد و بدون نیاز به GPU اجرا میشود.
شبکه 2D CNN روی ویژگیهای log-mel (سالهای 2015 تا 2019). تنسور (T, n_mels) حاصل از log-mel را مانند یک تصویر در نظر بگیرید. یک معماری از نوع ResNet-18 یا سبک VGG روی آن پیاده کنید. روی محور زمان میانگینگیری سراسری (global mean pool) انجام دهید و سپس با سافتمکس روی کلاسها خروجی بگیرید. این رویکرد در سال 2026 هنوز در بیشتر مسابقات Kaggle خط پایهی اصلی به حساب میآید.
ترنسفورمر طیفنگار صوتی، AST (سالهای 2021 تا 2024). ماتریس log-mel را به پچهای کوچک (مثلاً 16×16) تقسیم کنید، امبدینگهای موقعیت مکانی (position embeddings) را به آن بیفزایید و خروجی را به یک ViT بدهید. این روش در یادگیری نظارتشده (supervised learning) روی دیتاست AudioSet به پیشرفتهترین نتیجه (mAP معادل 0.485) رسید.
مدلهای BEATs و WavLM-base (سالهای 2024 تا 2026). پیشآموزش خودنظارتی (self-supervised) روی میلیونها ساعت دادهی صوتی. سپس برای تسک مدنظر خود، آن را تنها با 1 تا 10 درصد از دادههای نظارتشدهای که در گذشته نیاز بود فاینتیون کنید. در سال 2026 این روش نقطهی شروع پیشفرض برای صداهای غیرگفتاری است. مدل BEATs-iter3 با مصرف تنها یکچهارم توان پردازشی، در AudioSet به میزان 1 تا 2 واحد mAP بهتر از AST عمل میکند.
انکودر Whisper به عنوان یک بکبون منجمد (2024). انکودر مدل Whisper را بردارید، دیکودر آن را کنار بگذارید و یک طبقهبند خطی به آن وصل کنید. این ساختار در تشخیص زبان و طبقهبندی رویدادهای صوتی ساده، حتی بدون هیچگونه افزایش داده، عملکردی نزدیک به بهترین مدلهای روز (near-SOTA) ارائه میدهد؛ یک گزینهی پایهی بسیار کمهزینه و پربازده.
چالش اصلی: عدمتوازن کلاسها
دیتاست ESC-50 شامل 50 کلاس و 40 کلیپ برای هر کدام است؛ کاملاً متوازن و ساده. دیتاست UrbanSound8K شامل 10 کلاس است، با نسبت عدمتوازن 10 به 1. دیتاست AudioSet شامل 632 کلاس با دنبالهی طولانی (long tail) و نسبت 100,000 به 1 است. تکنیکهایی که واقعاً نتیجه میدهند:
- نمونهبرداری متوازن در مرحلهی آموزش (نه در مرحلهی ارزیابی).
- روش Mixup: ترکیب خطی دو کلیپ صوتی (و برچسبهای متناظرشان) به عنوان تکنیک افزایش داده.
- روش SpecAugment: ماسک کردن تصادفی بازههای زمانی و فرکانسی؛ ساده ولی حیاتی.
ارزیابی
- چندکلاسی انحصاری (Speech Commands): دقت برتر (top-1 accuracy) و دقت top-5.
- چندکلاسی چندبرچسبی (AudioSet و سبک UrbanSound): میانگین دقت متوسط (mAP).
- دیتاستهای بهشدت نامتوازن: بازخوانی به ازای هر کلاس + معیار macro F1.
آمارهای کلیدی سال 2026 که باید بدانید:
| بنچمارک | خط پایه | SOTA در 2026 | منبع |
|---|---|---|---|
| ESC-50 | 82% (AST) | 97.0% (BEATs-iter3) | مقاله BEATs (2024) |
| AudioSet mAP | 0.485 (AST) | 0.548 (BEATs-iter3) | جدول ردهبندی HEAR 2026 |
| Speech Commands v2 | 98% (CNN) | 99.0% (Audio-MAE) | نتایج HEAR v2 |
پیادهسازی از صفر
مرحلهی 1: استخراج ویژگی
def featurize_mfcc(signal, sr, n_mfcc=13, n_mels=40, frame_len=400, hop=160):
    mag = stft_magnitude(signal, frame_len, hop)
    fb = mel_filterbank(n_mels, frame_len, sr)
    mels = apply_filterbank(mag, fb)
    log = log_transform(mels)
return [dct_ii(frame, n_mfcc) for frame in log]مرحلهی 2: بردار خلاصه با طول ثابت
def summarize(mfcc_frames):
    n = len(mfcc_frames[0])
    mean = [sum(f[i] for f in mfcc_frames) / len(mfcc_frames) for i in range(n)]
    var = [
        sum((f[i] - mean[i]) ** 2 for f in mfcc_frames) / len(mfcc_frames) for i in range(n)
    ]
    return mean + var
ساده اما کارآمد: ترکیب میانگین و واریانس در طول زمان، برای یک MFCC با 13 ضریب، یک امبدینگ ثابت 26 بعدی میسازد. فوراً اجرا میشود و تا همین سال 2017 در بنچمارک ESC-50 مدلهای پایهی شبکههای عصبی مدرن را شکست میداد.
مرحلهی 3: مدل k-NN
def cosine(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    na = math.sqrt(sum(x * x for x in a)) or 1e-12
    nb = math.sqrt(sum(x * x for x in b)) or 1e-12
    return dot / (na * nb)

def knn_classify(q, bank, labels, k=5):
    sims = sorted(range(len(bank)), key=lambda i: -cosine(q, bank[i]))[:k]
    votes = Counter(labels[i] for i in sims)
return votes.most_common(1)[0][0]مرحلهی 4: ارتقا به CNN روی log-mel
پیادهسازی در PyTorch:
import torch.nn as nn

class AudioCNN(nn.Module):
    def __init__(self, n_mels=80, n_classes=50):
        super().__init__()
        self.body = nn.Sequential(
            nn.Conv2d(1, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
            nn.Conv2d(64, 128, 3, padding=1), nn.ReLU(),
            nn.AdaptiveAvgPool2d(1),
        )
        self.head = nn.Linear(128, n_classes)

    def forward(self, x):  # x: (B, 1, T, n_mels)
        return self.head(self.body(x).flatten(1))
با 3 میلیون پارامتر، روی دیتاست ESC-50 با یک کارت گرافیک RTX 4090 در حدود 10 دقیقه آموزش میبیند و به دقت بالای 80 درصد میرسد.
مرحلهی 5: فاینتیونینگ یک ترنسفورمر صوتی پیشآموزشدیده (با نمایش AST)
from transformers import ASTFeatureExtractor, ASTForAudioClassification

ext = ASTFeatureExtractor.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
model = ASTForAudioClassification.from_pretrained(
    "MIT/ast-finetuned-audioset-10-10-0.4593",
    num_labels=50,
    ignore_mismatched_sizes=True,
)

inputs = ext(audio, sampling_rate=16000, return_tensors="pt")
logits = model(**inputs).logits
این مثال، مدل AST را از Hugging Face Hub فاینتیون میکند. مدل BEATs که استاندارد سال 2026 است، روی Hugging Face Hub قرار ندارد: یک چکپوینت از صفحهی رسمی BEATs در ریپوی microsoft/unilm دانلود کنید و آن را با کلاسهای BEATs و BEATsConfig همان ریپوزیتوری لود نمایید؛ ساختار حلقهی فاینتیونینگ به همین شکل باقی میماند.
استفاده از ابزارهای واقعی
پشتهی فناوری در سال 2026:
| شرایط مسئله | گزینهی شروع |
|---|---|
| دیتاست بسیار کوچک (کمتر از 1000 کلیپ) | الگوریتم k-NN روی میانگین MFCC (خط پایهی اولیه) + افزایش دادهی صوتی |
| دیتاست متوسط (1K تا 100K) | فاینتیونینگ BEATs یا AST |
| دیتاست بزرگ (بیشتر از 100K) | آموزش مدل از صفر یا فاینتیونینگ انکودر Whisper |
| بیدرنگ (Real-time) و دستگاههای لبه (Edge) | مدل CNN با 40 ضریب MFCC، کوانتیزهشده به int8 (سبک KWS) |
| چندبرچسبی (AudioSet) | مدل BEATs-iter3 با تابع زیان (loss) از نوع BCE + روش Mixup + روش SpecAugment |
| تشخیص زبان | مدل MMS-LID یا خط پایهی VoxLingua107 در SpeechBrain |
قاعدهی تصمیمگیری: کار را با یک بکبون منجمد شروع کنید، نه یک مدل خام از صفر. فاینتیون کردن یک سر (head) روی مدل BEATs، شما را در عرض چند ساعت به 95 درصد کارایی بهترین مدلهای روز میرساند، نه چند هفته.
خروجی این درس
این مستند را با نام outputs/skill-classifier-designer.md ذخیره کنید. در آن معماری، تکنیکهای افزایش داده، استراتژی متوازنسازی کلاسها و معیار ارزیابی را برای یک تسک طبقهبندی صدای مشخص تعیین نمایید.
تمرینها
- ساده. فایل
code/main.pyرا اجرا کنید. این اسکریپت خط پایهی k-NN روی MFCC را روی یک دیتاست مصنوعی 4 کلاسی (تنهای صوتی خالص با گامهای فرکانسی مختلف) آموزش میدهد. ماتریس درهمریختگی (confusion matrix) خروجی را گزارش کنید. - متوسط. تابع
summarizeرا تغییر دهید و مقادیر [mean, var, skew, kurtosis] را استخراج کنید. آیا ادغام 4 گشتاور آماری (4-moment pooling) در مقایسه با میانگین+واریانس روی همان دیتاست مصنوعی نتیجهی بهتری میدهد؟ - پیشرفته. با استفاده از کتابخانهی
torchaudio، یک مدل 2D CNN را روی فولد 1 از دیتاست ESC-50 آموزش دهید. دقت حاصل از اعتبارسنجی متقاطع 5 برابری (5-fold cross-validation) را ثبت کنید. سپس روش SpecAugment را (با پارامترهای time mask = 20 و freq mask = 10) اضافه کنید و میزان تغییر عملکرد (دلتا) را گزارش دهید.
اصطلاحات کلیدی
| اصطلاح | در گفتار رایج | معنای فنی دقیق |
|---|---|---|
| AudioSet | ایمیجنت دنیای صوت | دیتاست گوگل شامل 2 میلیون کلیپ یوتیوب با برچسبگذاری ضعیف در 632 کلاس. |
| ESC-50 | بنچمارک طبقهبندی کوچک | 50 کلاس و در هر کدام 40 کلیپ از صداهای محیطی. |
| AST | ترنسفورمر طیفنگار صوتی | معماری ViT روی پچهای log-mel؛ بهترین مدل سالهای 2021 تا 2024. |
| BEATs | مدل صوتی خودنظارتی | مدل مایکروسافت که نسخهی iter3 آن از سال 2026 صدرنشین بنچمارک AudioSet است. |
| Mixup | افزایش داده جفتی | ترکیب خطی دو ورودی و برچسبهایشان: x = λ·x1 + (1-λ)·x2; y = λ·y1 + (1-λ)·y2. |
| SpecAugment | افزایش داده مبتنی بر ماسک | صفر کردن تصادفی بخشهایی از باندهای زمانی و فرکانسی طیفنگار. |
| mAP | معیار اصلی چندبرچسبی | میانگین دقت متوسط در بین تمامی کلاسها و آستانهها. |
برای مطالعهی بیشتر
- Gong, Chung, Glass (2021). AST: Audio Spectrogram Transformer — معماری شاخص و مرجع سالهای 2021 تا 2024.
- Chen et al. (2022, rev. 2024). BEATs: Audio Pre-Training with Acoustic Tokenizers — گزینهی استاندارد و پیشفرض از 2024 به بعد.
- Park et al. (2019). SpecAugment — پرکاربردترین تکنیک افزایش داده در پردازش سیگنالهای صوتی.
- Piczak (2015). ESC-50 dataset — بنچمارک 50 کلاسی ماندگار و پرکاربرد.
- Gemmeke et al. (2017). AudioSet — ساختار دستهبندی ویدیوهای یوتیوب با 632 کلاس؛ همچنان معیار طلایی ارزیابی دادههای صوتی.