
فناوری هوش مصنوعی پس از تحول در متن و تصویر، اکنون به حوزهی تولید صدا و موسیقی رسیده است. در سالهای اخیر، ساخت آهنگ کامل، تولید لوپهای صوتی و تفکیک اجزای موسیقی با استفاده از پرامپتهای متنی وارد فاز عملیاتی شده است. مهندسان نرمافزار و فعالان رسانهای برای ساخت موسیقی بازی، جینگلهای تبلیغاتی یا آهنگسازی سریع، به ابزارهای خودکار روی آوردهاند.
درک معماریهای زیربنایی این حوزه — از مدلهای زبانی خودبازگشتی روی توکنهای کدک صوتی (مانند MusicGen) تا مدلهای دیفیوژن روی مِل یا متغیرهای نهان (مانند Stable Audio) — برای انتخاب ابزار متناسب با هر پروژه ضروری است. علاوه بر مسائل فنی، چالشهای مربوط به حق نشر، انطباق با قوانین و استفادهی تجاری از مدلهای بسته و متنباز اهمیت بالایی پیدا کردهاند.
اگر برای راهاندازی این ابزارها با مدلهای تجاری خارجی مانند Suno یا دانلود وزن مدلها کار میکنید، محدودیتهای پرداخت ارزی برای فعالسازی اشتراکها یا ناپایداریهای دانلود وزنها از مخازنی مانند Hugging Face و PyPI از چالشهای رایج کاربران در ایران است. با این حال، اجرای مدلهای سبکتر روی سختافزار محلی یا استفاده از گزینههای متنباز با مجوزهای باز، مسیر جایگزین و پایداری را پیش روی شما میگذارد.
تولید موسیقی در سال 2026: در بازار تجاری، Suno v5 و Udio v4 دست بالا را دارند؛ در دنیای متنباز هم MusicGen، Stable Audio Open و ACE-Step پیشتازند. چالش فنی تا حد زیادی حل شده، اما چالشهای حقوقی (توافق 500 میلیون دلاری Warner Music و توافق UMG) این حوزه را در سالهای 2025 و 2026 کاملاً دگرگون کرده است.
صورت مسئله
متن → یک قطعهی موسیقی 30 ثانیهای تا 4 دقیقهای، همراه با شعر، وکال و ساختار موسیقایی. این مسئله سه بخش دارد:
- تولید موسیقی بیکلام (Instrumental): تبدیل متنی مثل «lo-fi hip-hop drums with warm keys» به صدا. مدلها: MusicGen، Stable Audio و AudioLDM.
- تولید آهنگ کامل (همراه با وکال و شعر): تبدیل متنی مثل «Country song about rainy Texas nights» به یک آهنگ کامل. مدلها: Suno، Udio، YuE و ACE-Step.
- کنترلپذیری / تولید شرطی (Conditional): ادامهدادن یک قطعهی موجود، بازتولید بخش بریج (bridge)، تغییر سبک، تفکیک ساقه (stem separation) یا اینپینتینگ (inpainting). قابلیت اینپینتینگ و تفکیک ساقهی Udio، قابلیتی کلیدی در سال 2026 است که بقیه هم باید به آن برسند.
مفاهیم پایه
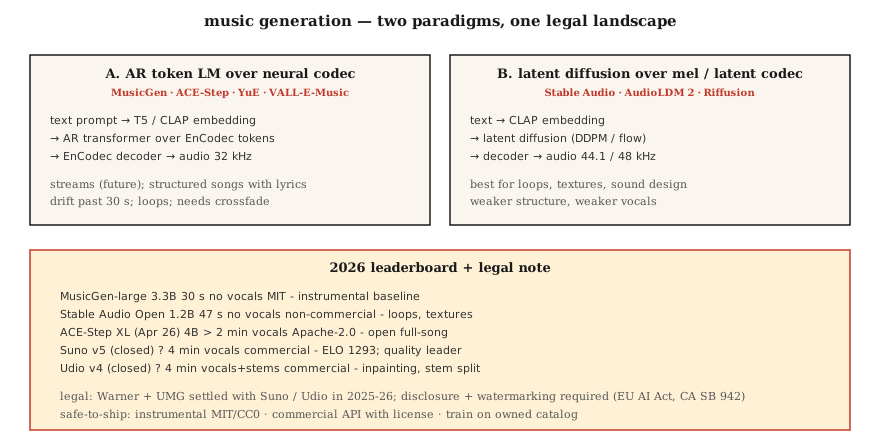
مدل زبانی توکنمحور روی توکنهای کدک عصبی
مدل MusicGen متا (2023، با مجوز MIT) و مشتقات پرتعداد آن: با شرطیسازی روی امبدینگهای متن یا ملودی، توکنهای EnCodec را بهصورت خودبازگشتی (autoregressive) پیشبینی میکنند (نرخ نمونهبرداری 32 کیلوهرتز، 4 کتابکد یا codebook) و در نهایت خروجی با EnCodec رمزگشایی میشود. اندازهی این مدلها بین 300 میلیون تا 3.3 میلیارد پارامتر است. این رویکرد یک بیسلاین قدرتمند محسوب میشود، ولی برای قطعات بالای 30 ثانیه به چالش میخورد.
مدل ACE-Step (متنباز؛ نسخهی 4B XL آن در آوریل 2026 منتشر شد) همین ایده را برای تولید آهنگ کامل و شرطیشده روی شعر توسعه داده است؛ نزدیکترین گزینهی جامعهی متنباز به Suno.
دیفیوژن روی مِل یا متغیرهای نهان
مدلهای Stable Audio (2023) و Stable Audio Open (2024): دیفیوژن نهان روی صدای فشردهشده. این مدلها در ساخت لوپ (loop)، طراحی صدا و بافتهای امبینت (ambient) فوقالعادهاند؛ اما در تولید آهنگهای کامل و ساختاریافته چندان قوی نیستند.
مدلهای AudioLDM / AudioLDM2: تبدیل متن به صدا از طریق دیفیوژن نهانِ مشابه مدلهای متن به تصویر (T2I)، با تعمیم به موسیقی، جلوههای صوتی و گفتار.
مدلهای ترکیبی (محیطهای عملیاتی) — Suno، Udio و Lyria
وزنهای این مدلها بسته است. معماری محتمل آنها ترکیبی از یک مدل زبانی خودبازگشتی بر پایهی کدک بههمراه وُکودر (vocoder) مبتنی بر دیفیوژن است که سرهای اختصاصی برای صدا، درامز و ملودی دارد. مدل Suno v5 (محصول 2026) با امتیاز ELO 1293 پیشتاز بیرقیب کیفیت است. Udio v4 نیز قابلیت اینپینتینگ و تفکیک ساقه (امکان دانلود جداگانهی بیس، درامز و وکال) را به این جمع اضافه کرده است.
ارزیابی
- فاصلهی صوتی فرشه (FAD یا Fréchet Audio Distance): محاسبهی فاصلهی بین توزیع صدای تولیدی و صدای واقعی در سطح امبدینگ با استفاده از ویژگیهای VGGish یا PANNs. هرچه عدد پایینتر باشد، نتیجه بهتر است. مقدار FAD نسخهی کوچک MusicGen روی بنچمارک MusicCaps برابر با 4.5 است؛ بهترین رکورد کنونی (SOTA) نیز حدود 3.0 است.
- موسیقیایی بودن (ذهنی): ترجیح انسان. مدل Suno v5 با ELO 1293 در صدر قرار دارد.
- همراستایی متن و صدا: امتیاز CLAP بین پرامپت و خروجی.
- آرتیفکتهای موسیقایی: پاساژهای خارج از ضرب، ناهماهنگی در جملهبندی وکال و از دست رفتن ساختار در قطعات بالای 30 ثانیه.
نقشهی مدلهای سال 2026
| مدل | تعداد پارامترها | طول قطعه | وکال | مجوز |
|---|---|---|---|---|
| MusicGen-large | 3.3B | 30 ثانیه | خیر | MIT |
| Stable Audio Open | 1.2B | 47 ثانیه | خیر | Stability غیرتجاری |
| ACE-Step XL (آوریل 2026) | 4B | بیش از 2 دقیقه | بله | Apache-2.0 |
| YuE | 7B | بیش از 2 دقیقه | بله، چندزبانه | Apache-2.0 |
| Suno v5 (بسته) | نامشخص | 4 دقیقه | بله، با ELO 1293 | تجاری |
| Udio v4 (بسته) | نامشخص | 4 دقیقه | بله + ساقهها | تجاری |
| Google Lyria 3 (بسته) | نامشخص | بلادرنگ (real-time) | بله | تجاری |
| MiniMax Music 2.5 | نامشخص | 4 دقیقه | بله | API تجاری |
چشمانداز حقوقی (2025-2026)
- توافق Warner Music با Suno: توافقی 500 میلیون دلاری. اکنون WMG روی استفاده از شباهت چهره/صدای هنرمندان (AI-likeness)، حقوق موسیقی و ترکهای تولیدشدهی کاربران در Suno نظارت مستقیم دارد. UMG نیز توافق مشابهی با Udio امضا کرد.
- قانون هوش مصنوعی اتحادیهی اروپا (EU AI Act) و لایحهی SB 942 کالیفرنیا: افشای استفاده از هوش مصنوعی در تولید موسیقی الزامی است.
- مدلهای Riffusion / MusicGen با مجوز MIT دغدغهی انطباق با قوانین را ندارند، اما از طرف دیگر خروجی وکال تجاری هم ارائه نمیدهند.
الگوهای امن برای محیط عملیاتی:
- فقط خروجی بیکلام تولید کنید (با MusicGen، Stable Audio Open یا خروجیهای دارای مجوز MIT/CC0).
- سراغ APIهای تجاری (مثل Suno، Udio یا ElevenLabs Music) با مجوز به ازای هر بار تولید بروید.
- مدل را روی کاتالوگهای اختصاصی یا دارای حق امتیاز قانونی آموزش دهید (بسیاری از سازمانها نهایتاً به همین مسیر میرسند).
- خروجیها را با واترمارک و متادیتا برچسبگذاری کنید.
پیادهسازی گامبهگام
گام 1: تولید صدا با MusicGen
from audiocraft.models import MusicGen
import torchaudio

model = MusicGen.get_pretrained("facebook/musicgen-small")
model.set_generation_params(duration=10)
wav = model.generate(["upbeat synthwave with driving drums, 128 BPM"])
torchaudio.save("out.wav", wav[0].cpu(), 32000)
این مدل در سه سایز عرضه میشود: small (با 300 میلیون پارامتر، سریع)، medium (با 1.5 میلیارد پارامتر) و large (با 3.3 میلیارد پارامتر). نسخهی کوچک برای ارزیابی اولیهی ایده کاملاً کفایت میکند.
گام 2: شرطیسازی روی ملودی
melody, sr = torchaudio.load("humming.wav")
wav = model.generate_with_chroma(
    ["jazz piano cover"],
    melody.squeeze(),
    sr,
)
مدل MusicGen-melody یک کروموگرام (chromagram) را بهعنوان ورودی میگیرد؛ در نتیجه اصل ملودی را حفظ میکند و صرفاً جنس صدا (timbre) را تغییر میدهد. این قابلیت برای سناریوهایی مثل «همین ملودی را با کوارتت زهی اجرا کن» بسیار کاربردی است.
گام 3: ارزیابی با FAD
from frechet_audio_distance import FrechetAudioDistance
fad = FrechetAudioDistance()

fad.get_fad_score("generated_folder/", "reference_folder/")
این اسکریپت فاصلهی امبدینگهای VGGish را اندازه میگیرد. روش مناسبی برای تستهای رگرسیون در سطح سبک است؛ اما جایگزین گوش شنوندهی انسانی نمیشود.
گام 4: افزودن موسیقی به جریان کاری مدلهای زبانی
ترکیب مفاهیم این بخش با درسهای 7 و 8:
prompt = "Write a 30-second jazz loop. Describe the drums, bass, and piano voicing."
description = llm.complete(prompt)
music = musicgen.generate([description], duration=30)
موارد استفاده
| هدف | ابزارها و فناوریها |
|---|---|
| طراحی صدای سازها | Stable Audio Open |
| موسیقی بازی و تعاملی | Google Lyria RealTime (بسته) |
| آهنگ کامل همراه با وکال (تجاری) | Suno v5 یا Udio v4 با مجوز شفاف |
| آهنگ کامل همراه با وکال (متنباز) | ACE-Step XL یا YuE |
| تیزر و جینگل تبلیغاتی کوتاه | مدل MusicGen-melody با ورودی زمزمهی ملودی |
| موسیقی پسزمینهی ویدیو | ترکیب MusicGen و Stable Video Diffusion |
خطاهای رایجی که در سال 2026 هم به پروداکشن راه پیدا میکنند
- پرامپتهای پولشویی کپیرایت: پرامپتهایی مثل «آهنگی به سبک تیلور سوئیفت»؛ سرویسهای تجاری مثل Suno و Udio این موارد را مسدود میکنند، ولی مدلهای متنباز نه. خودتان باید یک لیست فیلتر اضافه کنید.
- تکرار و انحراف در قطعات بالای 30 ثانیه: مدلهای خودبازگشتی به حلقهی تکرار میافتند. چند خروجی مختلف را با محو تدریجی تقاطعی (crossfade) پیوند بزنید، یا برای حفظ ساختار سراغ ACE-Step بروید.
- انحراف از تمپو: مدلها از BPM تعیینشده خارج میشوند. تگهای ضربآهنگ (BPM) را مستقیماً داخل پرامپت بیاورید و در پسپردازش با تابع
beat_trackکتابخانهی librosa آن را فیلتر کنید. - وضوح گفتار وکال: خروجی Suno عالی است؛ اما مدلهای متنباز کلمات را مبهم ادا میکنند. اگر وضوح شعر برایتان حیاتی است، از API تجاری استفاده کنید یا به فکر فاینتیونینگ باشید.
- خروجی مونو: مدلهای متنباز خروجی تککاناله (مونو) یا استریوی جعلی تولید میکنند. کیفیت خروجی را با بازسازی استریوی استاندارد (مثل ezst یا مدلهای دیفیوژن استریوی Cartesia) ارتقا دهید.
تحویل پروژه
خروجی را در فایل outputs/skill-music-designer.md ذخیره کنید. مدل انتخابی، راهبرد مجوزدهی، برنامهی ساختار و زمان قطعات، و متادیتای افشای هوش مصنوعی را برای راهاندازی سامانهی تولید موسیقی در محیط عملیاتی مشخص کنید.
تمرینها
- ساده: اسکریپت
code/main.pyرا اجرا کنید. این کد یک توالی آکورد بههمراه الگوی درامز را در قالب کاراکترهای اسکی (ASCII) تولید میکند که شبیه یک کاریکاتور ساده از مدلهای تولید موسیقی است. در صورت تمایل میتوانید خروجی را با یک رندرر MIDI پخش کنید. - متوسط: کتابخانهی
audiocraftرا نصب کنید، با مدل MusicGen-small قطعاتی 10 ثانیهای برای 4 پرامپت در سبکهای مختلف بسازید، و سپس FAD آنها را در برابر یک مجموعهی مرجع از همان سبک اندازه بگیرید. - پیشرفته: با کمک ACE-Step (یا MusicGen-melody)، از یک ملودی مشخص سه نسخهی متفاوت با پرامپتهای سازبندی گوناگون بگیرید. میزان شباهت CLAP را با پرامپت اولیه محاسبه کنید تا همراستایی آن تأیید شود.
اصطلاحات کلیدی
| اصطلاح | اصطلاح رایج | مفهوم فنی دقیق |
|---|---|---|
| FAD | معادل FID برای صوت | فاصلهی فرشه میان توزیعهای امبدینگ صدای واقعی و صدای تولیدی. |
| کروموگرام (Chromagram) | ملودی در قالب زیروبمی | بردار 12بعدی در هر فریم؛ ورودی شرطیسازی بر اساس ملودی. |
| ساقهها (Stems) | تِرکهای جداگانهی سازها | فایلهای صوتی WAV مجزا برای بیس، درامز، وکال و ملودی. |
| اینپینتینگ (Inpainting) | بازتولید یک بخش از قطعه | ماسککردن یک بازهی زمانی تا مدل صرفاً همان محدوده را دوباره تولید کند. |
| CLAP | مدل CLIP برای متن و صدا | امبدینگ همبستهساز (contrastive) متن و صدا؛ ارزیابی همراستایی متن و صدا. |
| EnCodec | کدک صوتی موسیقی | کدک عصبی متا در MusicGen با نرخ 32 کیلوهرتز و 4 کتابکد. |
برای مطالعهی بیشتر
- مقالهی کوپت و همکاران (2023) دربارهی MusicGen — بنچمارک استاندارد مدلهای خودبازگشتی متنباز.
- مقالهی ایوانز و همکاران (2024) دربارهی Stable Audio Open — گزینهی پیشفرض برای طراحی صدا.
- پروژهی ACE-Step — مدل متنباز 4B برای تولید آهنگ کامل، عرضهشده در آوریل 2026.
- مستندات پلتفرم Suno v5 — پیشتاز کیفیت در محصولات تجاری.
- مقالهی AudioLDM2 — دیفیوژن نهان برای موسیقی و جلوههای صوتی.
- گزارش توافق WMG و Suno — سابقهی حقوقی مهم در نوامبر 2025.