
بسیاری از سیستمهای پردازش صدا به پیادهسازی متنی (ASR) محدود میشوند؛ اما پاسخ به پرسشهایی مثل تحلیل خطر از روی صدای محیط، درک لحن یا استخراج اطلاعات از فایلهای طولانی، نیازمند فهم همزمان محتوای کلامی، لحن و صداهای پیرامونی است. مدلهای صوتی-زبانی (LALM) با پیوند دادن بازنماییهای صوتی به مدلهای زبانی بزرگ، چنین استدلالهایی را در یک پرامپت ممکن میسازند.
اگر برای سرویسهای تجاری مانند Gemini API یا GPT-4o دسترسی با IP ایران با محدودیت روبهرو باشد یا پرداخت ارزی چالش ایجاد کند، شناخت مدلهای باز قدرتمندی مثل Qwen2.5-Omni و Audio Flamingo اهمیت دوچندانی دارد. این مدلها به شما اجازه میدهند پردازش صوت را بدون وابستگی مستقیم به پلتفرمهای ابری خارجی پیادهسازی کنید.
در این درس ساختار سهمؤلفهای LALMها (انکودر، پروجکتور و دیکودر)، نتایج بنچمارکهای روز مانند MMAU-Pro، و سناریوهای واقعی کاربرد یا نقاط ضعف این مدلها را بررسی میکنیم.
مدلهای صوتی-زبانی در سال 2026 روی گفتار، صداهای محیطی و موسیقی استدلال میکنند. Qwen2.5-Omni-7B در بنچمارک MMAU-Pro شانهبهشانهی GPT-4o Audio پیش میرود. Audio Flamingo Next نیز در LongAudioBench مدل Gemini 2.5 Pro را شکست میدهد. شکاف بین مدلهای متنباز و اختصاصی تقریباً از بین رفته است؛ بهجز در تسکهای چندصوتی (multi-audio)، که در آنها عملکرد همهی مدلها نزدیک به حدس تصادفی است.
صورت مسئله
یک قطعه صوتی 5 ثانیهای دارید: صدای پارس سگ، فریاد «وایسا!»ی یک نفر و سپس سکوت. پرسشهای کاربردی حول چند محور مختلف شکل میگیرند:
- پیادهسازی متنی (Transcription). «چه چیزی گفته شد؟» — قلمرو تشخیص خودکار گفتار (ASR).
- استدلال معنایی. «آیا فرد در خطر است؟» — نیازمند درک همزمان پارس + فریاد + سکوت.
- استدلال موسیقایی. «کدام سازها ملودی را مینوازند؟»
- بازیابی در فایلهای صوتی طولانی. «استاد در کجای این سخنرانی 90 دقیقهای گرادیان کاهشی (gradient descent) را توضیح داد؟»
مدلی یکپارچه که با یک پرامپت (Prompt) به همهی این پرسشها پاسخ میدهد، یک مدل صوتی-زبانی (LALM یا ALM) است. این مدلها با ASR خالص تفاوت دارند: LALMها فقط متن پیادهشده تولید نمیکنند، بلکه پاسخهایی به زبان طبیعی و با ساختار آزاد ارائه میدهند.
مفاهیم کلیدی
الگوی سهمؤلفهای
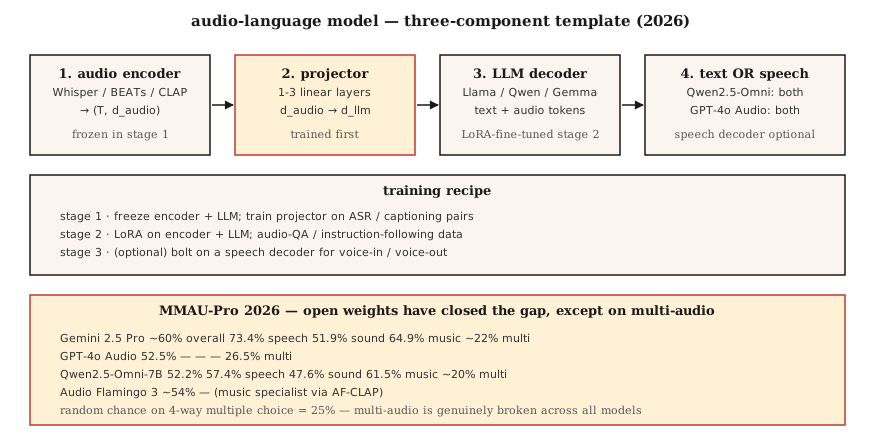
تمام LALMهای سال 2026 اسکلتبندی یکسانی دارند:
- انکودر صوتی (Audio encoder). انکودر Whisper، مدل BEATs، CLAP، WavLM یا یک انکودر سفارشی برای هر مدل.
- پروجکتور (Projector). یک لایهی خطی یا MLP که ویژگیهای انکودر صوتی را به فضای امبدینگ (Embedding) توکنهای مدل زبانی بزرگ (LLM) پل میزند.
- مدل زبانی بزرگ (LLM). دیکودری بر پایهی Llama، Qwen یا Gemma. توکنهای درهمتنیدهی متن + صوت را دریافت میکند و خروجی متنی میسازد.
مراحل آموزش:
- مرحلهی 1. انکودر و LLM فریز میشوند؛ فقط پروجکتور روی دادههای ASR یا کپشننویسی صوتی آموزش میبیند.
- مرحلهی 2. فاینتیون کامل یا با LoRA روی تسکهای صوتیِ مبتنی بر پیروی از دستورالعمل (پرسش و پاسخ، استدلال، درک موسیقی).
- مرحلهی 3 (اختیاری). سناریوی ورودی صدا / خروجی صدا (Voice-in / voice-out) که یک دیکودر گفتار به سیستم اضافه میکند؛ Qwen2.5-Omni و AF3-Chat از این روش استفاده میکنند.
نقشهی مدلهای سال 2026
| مدل | بکبون | انکودر صوتی | مُدالیتهی خروجی | نوع دسترسی |
|---|---|---|---|---|
| Qwen2.5-Omni-7B | Qwen2.5-7B | سفارشی + Whisper | متن + گفتار | Apache-2.0 |
| Qwen3-Omni | Qwen3 | سفارشی | متن + گفتار | Apache-2.0 |
| Audio Flamingo 3 | Qwen2 | AF-CLAP | متن | غیرتجاری NVIDIA |
| Audio Flamingo Next | Qwen2 | AF-CLAP v2 | متن | غیرتجاری NVIDIA |
| SALMONN | Vicuna | Whisper + BEATs | متن | Apache-2.0 |
| LTU / LTU-AS | Llama | CAV-MAE | متن | Apache-2.0 |
| GAMA | Llama | AST + Q-Former | متن | Apache-2.0 |
| Gemini 2.5 Flash/Pro (اختصاصی) | Gemini | اختصاصی | متن + گفتار | API |
| GPT-4o Audio (اختصاصی) | GPT-4o | اختصاصی | متن + گفتار | API |
ارزیابی واقعبینانهی بنچمارکها (2026)
بنچمارک MMAU-Pro. شامل 1800 جفت پرسش و پاسخ که گفتار، صدا، موسیقی و ترکیب آنها را پوشش میدهد. زیرمجموعهی چندصوتی نیز در آن گنجانده شده است.
| مدل | کلی | گفتار | صدا | موسیقی | چندصوتی |
|---|---|---|---|---|---|
| Gemini 2.5 Pro | ~60% | 73.4% | 51.9% | 64.9% | ~22% |
| Gemini 2.5 Flash | ~57% | 73.4% | 50.5% | 64.9% | 21.2% |
| GPT-4o Audio | 52.5% | — | — | — | 26.5% |
| Qwen2.5-Omni-7B | 52.2% | 57.4% | 47.6% | 61.5% | ~20% |
| Audio Flamingo 3 | ~54% | — | — | — | — |
| Audio Flamingo Next | پیشرو در LongAudioBench | — | — | — | — |
ستون چندصوتی عملکرد ناامیدکنندهی همهی مدلها را نشان میدهد. در سؤالات چهارگزینهای، شانس انتخاب تصادفی 25% است؛ نمرهی بیشتر مدلها دقیقاً حول همین عدد میچرخد. LALMها هنوز هنگام مقایسهی دو فایل صوتی مجزا بهشدت با مشکل روبهرو میشوند.
کاربردهای مؤثر LALMها در سال 2026
- ممیزی تطبیق با مقررات در ضبطهای مرکز تماس. «آیا ایجنت (Agent) به رفع مسئولیت الزامی اشاره کرد؟»
- دسترسپذیری. توصیف رخدادهای صوتی برای کاربران ناشنوا (فراتر از پیادهسازی متنی صرف).
- مدیریت محتوا. شناسایی ادبیات خشونتآمیز + لحن تهدیدآمیز + بستر محیطی.
- فصلبندی پادکست و جلسات. خلاصهسازی معنایی، بهجای تشخیص صرف نوبت صحبت افراد.
- تحلیل آرشیو موسیقی. «پیدا کردن تمام قطعاتی که در بخش B تغییر گام دارند.»
جاهایی که هنوز کاربرد ندارند
- تئوری موسیقی دقیق و جزئینگر (پایینتر از سطح آکورد).
- استدلال مبتنی بر تفکیک گوینده در مکالمات طولانی (افت دقت بعد از 10 دقیقه).
- مقایسهی چند فایل صوتی با یکدیگر (دقت 22 تا 26 درصدی تقریباً تفاوتی با حدس تصادفی ندارد).
- استدلال بیدرنگ به شیوهی استریمینگ (اکثر مدلها فقط برای استنتاج دستهای آفلاین مناسباند).
پیادهسازی
مرحلهی 1: فراخوانی Qwen2.5-Omni
from transformers import AutoModelForCausalLM, AutoProcessor

processor = AutoProcessor.from_pretrained("Qwen/Qwen2.5-Omni-7B")
model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2.5-Omni-7B", torch_dtype="auto")

audio, sr = load_wav("clip.wav", sr=16000)
messages = [{
    "role": "user",
    "content": [
        {"type": "audio", "audio": audio},
        {"type": "text", "text": "What sounds do you hear, and what's happening?"},
    ],
}]
inputs = processor.apply_chat_template(messages, tokenize=True, return_tensors="pt")
output = model.generate(**inputs, max_new_tokens=200)
print(processor.decode(output[0], skip_special_tokens=True))مرحلهی 2: الگوی پروجکتور
import torch.nn as nn

class AudioProjector(nn.Module):
    def __init__(self, audio_dim=1280, llm_dim=4096):
        super().__init__()
        self.down = nn.Linear(audio_dim, llm_dim)
        self.act = nn.GELU()
        self.up = nn.Linear(llm_dim, llm_dim)

    def forward(self, audio_features):
        return self.up(self.act(self.down(audio_features)))
همین و بس. پروجکتور معمولاً از 1 تا 3 لایهی خطی تشکیل میشود. آموزش آن روی جفتدادههای ASR (تبدیل صوت به متن پیادهشده) وظیفهی بهانهای (Pretext task) در مرحلهی 1 است.
مرحلهی 3: ارزیابی روی MMAU و LongAudioBench
from datasets import load_dataset
mmau = load_dataset("gamma-lab-umd/MMAU-Pro", split="test")
mcq = mmau.filter(lambda item: len(item["choices"] or []) > 1)

correct = 0
for item in mcq:
    answer = call_model(item["audio_path"], item["question"], item["choices"])
    if answer == item["answer"]:
        correct += 1
print(f"Accuracy: {correct / len(mcq):.3f}")
پارامتر audio_path به فایل data.zip در مخزن دیتاست (با حجم حدود 47 GB) ارجاع میدهد؛ بنابراین پیش از امتیازدهی باید آن را دانلود و از حالت فشرده خارج کنید. این حلقهی تطابق دقیق (exact-match) صرفاً یک بررسی اولیهی صحت عملکرد است، نه سیستم امتیازدهی رسمی بنچمارک؛ در نتیجه نمرهی آن با نتایج منتشرشدهی MMAU-Pro قابل مقایسه نیست. ارزیاب رسمی، پاسخهای چندگزینهای را با شباهت امبدینگ (NV-Embed-v2) میسنجد، پاسخهای تشریحی را با یک LLM داور تصحیح میکند و دستورپذیری را با الگوهای regex بررسی میکند: پیشبینیها را داخل یک ستون به نام model_output بنویسید و اسکریپت evaluate_mmau_pro_comprehensive.py را از مخزن MMAU-Pro اجرا کنید. نتایج هر دستهبندی (category شامل گفتار، صدا، موسیقی، چندصوتی و بقیه) را بهصورت جداگانه گزارش کنید؛ میانگین اعداد کلی نقاط ضعف مدل را پنهان میکند.
استفاده از ابزارهای واقعی
| تسک | گزینهی برتر 2026 |
|---|---|
| پرسش و پاسخ صوتی آزاد (متنباز) | Qwen2.5-Omni-7B |
| بهترین مدل متنباز برای صوتهای طولانی | Audio Flamingo Next |
| بهترین مدل اختصاصی | Gemini 2.5 Pro |
| ایجنت ورودی صدا / خروجی صدا | Qwen2.5-Omni یا GPT-4o Audio |
| استدلال موسیقایی | Audio Flamingo 3 یا 2 (با AF-CLAP تخصصی برای موسیقی) |
| ممیزی مرکز تماس | Gemini 2.5 Pro از طریق API، همراه با RAG روی اسناد خطمشی سازمان |
چالشها و دامها
- اعتماد بیش از حد به تسکهای چندصوتی. اگر کار شما نیازمند پاسخ به پرسشی مثل «کدام قطعه حاوی X است» باشد، عملکرد مدل عملاً در سطح شانس تصادفی خواهد بود.
- افت کیفیت در صوتهای طولانی. بعد از 10 دقیقه، تفکیک گوینده در اکثر مدلها به هم میریزد. ابتدا تفکیک گوینده (درس 6) را انجام دهید، سپس سراغ خلاصهسازی بروید.
- توهم در بخشهای سکوت. این همان چالش شناختهشدهی سبک Whisper است که به LALMهای مبتنی بر انکودر Whisper هم ارث میرسد. از تشخیص فعالیت صوتی (VAD) بهعنوان فیلتر دروازهای استفاده کنید.
- گزینش جانبدارانهی بنچمارکها (Cherry-picking). پستهای وبلاگی شرکتها بهترین دستهبندیهای مدل را برجسته میکنند. زیرمجموعهی چندصوتی MMAU-Pro را حتماً خودتان شخصاً اجرا و ارزیابی کنید.
خروجی این درس
خروجی را در فایلی با نام outputs/skill-alm-picker.md ذخیره کنید. در آن برای یک تسک درک صوت مشخص، ترکیب مناسب LALM + زیرمجموعهی بنچمارک ارزیابی + مُدالیتهی خروجی (متن در برابر گفتار) را انتخاب کنید.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید تا عملکرد یک پروجکتور ساده و مسیریابی شبیهسازیشدهی یک LALM برای تبدیل (امبدینگ صوت، توکنهای متن) به توکنهای خروجی را ببینید. - متوسط. عملکرد Qwen2.5-Omni-7B را روی 100 نمونه از بخش گفتار MMAU-Pro ارزیابی کنید و نمرهی بهدستآمده را با عدد گزارششده در مقالهی اصلی مقایسه کنید.
- پیشرفته. یک مدل پایهی حداقلی برای کپشننویسی صوتی بسازید: انکودر BEATs + پروجکتور 2 لایهای + مدل فریزشدهی Llama-3.2-1B. فقط پروجکتور را روی دیتاست AudioCaps فاینتیون کنید و خروجی آن را با SALMONN روی بنچمارک Clotho-AQA مقایسه کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوهای عامیانه | معنای دقیق فنی |
|---|---|---|
| LALM | چتجیپیتیِ صوتی | انکودر صوتی + پروجکتور + دیکودر مدل زبانی بزرگ. |
| Projector | آداپتور | یک شبکهی MLP کوچک که ویژگیهای صوتی را به فضای امبدینگ LLM مینگارد. |
| MMAU | بنچمارک مرجع | 10 هزار جفت پرسش و پاسخ صوتی در زمینههای گفتار، صدا و موسیقی. |
| MMAU-Pro | نسخهی دشوارتر MMAU | 1800 پرسش چالشبرانگیزِ نیازمند استدلال عمیق یا پردازش چند فایل صوتی. |
| LongAudioBench | بنچمارک صوتهای طولانی | ارزیابی روی کلیپهای صوتی چنددقیقهای با پرسشهای معنایی. |
| Voice-in / voice-out | گفتارمحور (Speech-native) | مدلی که بدون نیاز به واسطهی متن، مستقیماً گفتار میگیرد و گفتار تولید میکند. |
برای مطالعهی بیشتر
- Chu et al. (2024). Qwen2-Audio — معماری مرجع.
- Alibaba (2025). Qwen2.5-Omni — مدل ورودی صدا و خروجی صدا.
- NVIDIA (2025). Audio Flamingo 3 — مدل متنباز پیشرو در پردازش صوت طولانی.
- NVIDIA (2026). Audio Flamingo Next — بهترین رکورد ثبتشده در LongAudioBench.
- Tang et al. (2023). SALMONN — پیشگام در معماری دو انکودره.
- MMAU-Pro leaderboard — جدول رتبه zنده در سال 2026.