
ساخت یک دستیار صوتی مکالمهای و بلادرنگ نیازمند اتصال دقیق چندین قطعهی مجزا شامل ضبط صدا، تشخیص فعالیت صوتی (VAD)، تبدیل گفتار به متن (STT)، مدلهای زبانی بزرگ (LLM) و تبدیل متن به گفتار (TTS) است. چالش اصلی در تولید محصول نهایی، پایین نگهداشتن تاخیر پاسخدهی به زیر 800 میلیثانیه و مدیریت روان وقفه در مکالمه است تا تجربه طبیعی حس شود.
اگر از سرویسهای ابری خارجی مانند APIهای OpenAI، Deepgram یا Cartesia استفاده میکنید، توجه داشته باشید که کارتهای بانکی ایرانی امکان پرداخت مستقیم به این ارائهدهندگان را ندارند. در چنین شرایطی میتوانید از گیتویهای ارائهدهندهی API سازگار با فرمت OpenAI یا پیادهسازیهای محلی با ابزارهایی نظیر Whisper.cpp و Kokoro روی سیستم خود بهره ببرید.
در این پروژهی پایانی، تمام بخشهای آموختهشده را در قالب یک پایپلاین یکپارچه و بهینهسازیشده سرهم میکنید تا سیستمی بسازید که بهطور زنده بشنود، توابع را اجرا کند و بدون تاخیر با کاربر سخن بگوید.
چکیدهای از تمام درسهای 01 تا 11 در کنار هم. ساخت یک دستیار صوتی که بشنود، استدلال کند و پاسخ دهد. در سال 2026 این یک مسئلهی مهندسی حلشده است، نه یک کار پژوهشی — اما جزئیات یکپارچهسازی تعیین میکنند که محصول نهایی واقعاً روانهی بازار میشود یا نه.
صورتمسئله
یک دستیار سرتاسری (end-to-end) بسازید که:
- صدای ورودی میکروفون را ضبط کند (16 kHz مونو).
- شروع و پایان صحبت کاربر را تشخیص دهد.
- صدا را بهصورت استریمینگ تبدیل به متن کند.
- متن پیادهشده را به یک LLM با قابلیت فراخوانی ابزار (تایمر، آبوهوا، تقویم) بفرستد.
- خروجی متنی LLM را به یک TTS استریم کند.
- صدا را برای کاربر پخش کند.
- اگر کاربر وسط پاسخ صحبت کرد، بلافاصله متوقف شود.
هدف تاخیر: رسیدن اولین بایت صدای TTS ظرف کمتر از 800 ms پس از پایان صحبت کاربر، آن هم روی CPU لپتاپ. هدف کیفیت: بدون جا افتادن حتی یک کلمه، بدون تولید زیرنویسهای توهمی روی سکوت، بدون نشت در شبیهسازی صدا و بدون موفقیت حملات تزریق پرامپت (prompt injection).
مفهوم اصلی
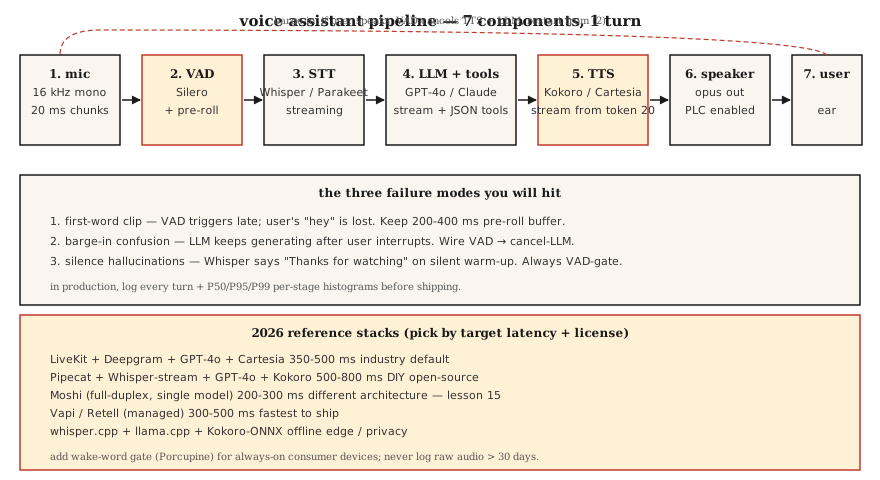
هفت جزء اصلی
- ضبط صدا (Audio capture): میکروفون ← 16 kHz مونو ← قطعات 20 ms. معمولاً با
sounddeviceدر Python یا رابطهای بومی AudioUnit/ALSA/WASAPI در محیط عملیاتی. - تشخیص فعالیت صوتی یا VAD (درس 11): مدل Silero VAD با آستانهی 0.5، حداقل زمان صحبت 250 ms و بازهی سکوت پایانی (silence hang-over) 500 ms، که سیگنال «شروع» و «پایان» را صادر میکند.
- تبدیل گفتار به متن استریمینگ یا Streaming STT (درسهای 4 و 5): با ابزارهایی مثل Whisper-streaming، Parakeet-TDT یا API مدل Deepgram Nova-3. خروجیها بهشکل متنهای موقت (partial) و نهایی (final).
- مدل زبانی با فراخوانی ابزار (LLM with tool calling): مثل GPT-4o / Claude 3.5 / Gemini 2.5 Flash. استفاده از JSON schema برای ابزارها و استریم کردن توکنها.
- تبدیل متن به گفتار استریمینگ یا Streaming TTS (درس 7): مدل Kokoro-82M (سریعترین گزینهی متنباز) یا Cartesia Sonic (تجاری). شروع ارسال به TTS پس از دریافت 20 توکن اول از LLM.
- پخش صدا (Playback): خروجی به بلندگو؛ کدگذاری با Opus برای شبکههایی با پهنای باند کم.
- مدیریت وقفه (Interruption handler): اگر VAD حین پخش صدای TTS فعال شد، بلافاصله پخش را متوقف کنید، LLM را لغو کنید و STT را از نو راه بیندازید.
سه حالت خرابی که حتماً به آنها برمیخورید
- بریده شدن کلمهی اول (First-word clip): ماژول VAD کمی دیر فعال میشود و کلمهی «سلام» کاربر جا میماند. آستانهی شروع را روی 0.3 بگذارید، نه 0.5.
- تداخل ناشی از وقفه در میانهی پاسخ: LLM حتی پس از پریدن کاربر وسط حرفش به تولید متن ادامه میدهد و صدای دستیار روی صدای کاربر میافتد. خروجی VAD را مستقیماً به لغو LLM متصل کنید.
- توهم روی سکوت (Silence hallucination): مدل Whisper روی فریمهای بیصدای اولیه متنهایی مثل «Thanks for watching» تولید میکند. همیشه ورودی STT را به VAD وابسته (gate) کنید.
ترکیبهای فنی مرجع در محیطهای عملیاتی سال 2026
| استک | تاخیر | مجوز | یادداشتها |
|---|---|---|---|
| LiveKit + Deepgram + GPT-4o + Cartesia | 350-500 ms | تجاری (API) | گزینهی پیشفرض صنعت در سال 2026 |
| Pipecat + Whisper-streaming + GPT-4o + Kokoro | 500-800 ms | عمدتاً متنباز | مناسب برای پروژههای مستقل و سفارشی |
| Moshi (دوطرفه همزمان / full-duplex) | 200-300 ms | CC-BY 4.0 | تکمدلی؛ معماری متفاوت، درس 15 |
| Vapi / Retell (مدیریتشده) | 300-500 ms | تجاری | سریعترین زمان برای راهاندازی؛ سفارشیسازی محدود |
| Whisper.cpp + llama.cpp + Kokoro-ONNX | آفلاین | متنباز | حفظ حریم خصوصی / لبهی شبکه (Edge) |
پیادهسازی
مرحلهی 1: ضبط صدای میکروفون همراه با قطعهبندی متن (شبهکد)
import sounddevice as sd

def mic_stream(chunk_ms=20, sr=16000):
    q = queue.Queue()
    def cb(indata, frames, time, status):
        q.put(indata.copy().flatten())
    with sd.InputStream(channels=1, samplerate=sr, blocksize=int(sr * chunk_ms/1000), callback=cb):
        while True:
yield q.get()مرحلهی 2: ضبط نوبت مکالمه با کنترل VAD
def capture_turn(stream, vad, pre_roll_ms=300, silence_ms=500):
    buf, pre, triggered = [], collections.deque(maxlen=pre_roll_ms // 20), False
    silent = 0
    for chunk in stream:
        pre.append(chunk)
        if vad(chunk):
            if not triggered:
                buf = list(pre)
                triggered = True
            buf.append(chunk)
            silent = 0
        elif triggered:
            silent += 20
            buf.append(chunk)
            if silent >= silence_ms:
return b"".join(buf)مرحلهی 3: استریمینگ پیوستهی STT ← LLM ← TTS
async def turn(audio_bytes):
    transcript = await stt.transcribe(audio_bytes)
    async for token in llm.stream(transcript):
        async for audio in tts.stream(token):
await speaker.play(audio)مرحلهی 4: فراخوانی ابزار درون حلقهی LLM
tools = [
    {"name": "get_weather", "parameters": {"location": "string"}},
    {"name": "set_timer", "parameters": {"seconds": "int"}},
]

async for chunk in llm.stream(user_text, tools=tools):
    if chunk.type == "tool_call":
        result = dispatch(chunk.name, chunk.args)
        continue_streaming(result)
    if chunk.type == "text":
await tts.stream(chunk.text)مرحلهی 5: مدیریت وقفه
tts_task = asyncio.create_task(tts_loop())
while True:
    chunk = await mic.get()
    if vad(chunk):
        tts_task.cancel()
        await speaker.stop()
        await new_turn()
        break
نحوه استفاده
فایل code/main.py یک شبیهسازی کامل و قابل اجرا است که هر هفت جزء را با ماژولهای فرضی (stub) به هم متصل میکند تا ساختار کلی پایپلاین را حتی بدون سختافزار اختصاصی ببینید. برای پیادهسازی واقعی، کافی است ماژولهای فرضی را با این ابزارها جایگزین کنید:
silero-vad(pip install silero-vad)deepgram-sdkیاopenai-whisperopenai(gpt-4o) یاanthropickokoroیاcartesiasounddeviceبرای ورودی و خروجی
تلهها
- ذخیرهی دائمی دادههای هویتی (PII): صدای کامل یک دور مکالمه در بیشتر حوزههای قضایی جزو PII محسوب میشود. دادهها را حداکثر 30 روز نگه دارید و در حالت ذخیره (at rest) رمزگذاری کنید.
- نبود قابلیت پریدن وسط حرف (Barge-in): کاربران وسط صحبت دستیار میپرند. سیستم شما باید فوراً ساکت شود.
- مسدود شدن برنامه با فراخوانیهای همگام TTS: فراخوانی سنکرون TTS چرخهی رویدادها (event loop) را مسدود میکند. از async یا یک thread مجزا استفاده کنید.
- رها کردن خطاهای فراخوانی ابزار بدون رسیدگی: ابزارها ممکن است با خطا مواجه شوند. LLM باید خطا را دریافت کند، یک بار دیگر امتحان کند و در صورت ادامهی مشکل، پاسخ را با حفظ انسجام کلام جمعبندی کند.
- فیلترهای بیشازحد سختگیرانه برای توهم: اگر بیش از حد فیلتر کنید، دستیار مدام میگوید «نمیتوانم در این مورد کمکی کنم». اگر کم فیلتر کنید، هر حرف بیربطی را سر هم میکند. سیستم را روی یک مجموعهی ارزیابی مستقل کالیبره کنید.
- نداشتن گزینهی کلمهی بیدارباش (Wake-word): حالت همیشه شنوا یک ریسک برای حریم خصوصی است. یک دروازهی کلمهی بیدارباش (مثل Porcupine یا openWakeWord) اضافه کنید.
تحویل پروژه
خروجی را در outputs/skill-voice-assistant-architect.md ذخیره کنید. با در نظر گرفتن محدودیتهای بودجه، مقیاس، زبان و قوانین تطبیقپذیری، مشخصات کامل معماری سیستم را تدوین کنید.
تمرینها
- ساده. فایل
code/main.pyرا اجرا کنید. این اسکریپت یک دور کامل مکالمه را از ابتدا تا انتها با ماژولهای فرضی شبیهسازی میکند و تاخیر هر مرحله را در خروجی مینویسد. - متوسط. ماژول فرضی STT را با یک مدل واقعی Whisper روی یک فایل صوتی
.wavاز پیش ضبطشده جایگزین کنید. نرخ خطای کلمات (WER) و تاخیر سرتاسری را بسنجید. - پیشرفته. قابلیت فراخوانی ابزار را اضافه کنید: دو تابع
get_weather(با هر API دلخواهی) وset_timerرا پیادهسازی کنید. LLM را به این ابزارها مجهز کنید و مطمئن شوید که وقتی کاربر میگوید «یک تایمر 5 دقیقهای بذار»، تابع درست فراخوانی میشود و پاسخ صوتی، تنظیم آن را تایید میکند.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوها چه میگویند | منظور دقیق فنی چیست |
|---|---|---|
| نوبت گفتوگو (Turn) | رفتوبرگشت کاربر و دستیار | یک بازهی صحبت کاربر با مرزهای مشخصشده توسط VAD + یک پاسخ متناظر از سوی LLM و TTS. |
| ورود ناگهانی به کلام (Barge-in) | وقفه یا پریدن وسط حرف | کاربر حین صحبت دستیار حرف میزند؛ دستیار فوراً ساکت میشود. |
| کلمهی بیدارباش (Wake word) | عبارتی مثل «هی دستیار» | آشکارساز عبارت کلیدی کوتاه؛ مثل Porcupine، Snowboy یا openWakeWord. |
| نقطهگذاری پایانی (End-pointing) | پایان نوبت صحبت | تصمیمگیری مبتنی بر VAD و حداقل مدت سکوت مبنی بر اینکه حرف کاربر تمام شده است. |
| بافر پیش از کلام (Pre-roll) | بافر صوتی پیش از شروع صحبت | نگهداشتن 200-400 ms از صدای قبل از فعال شدن VAD تا ابتدای کلمهی اول قطع نشود. |
| فراخوانی ابزار (Tool call) | اجرای تابع (Function calling) | مدل زبانی خروجی JSON تولید میکند؛ محیط اجرا آن را فراخوانی میکند و نتیجه به ادامهی حلقهی پردازش بازمیگردد. |
برای مطالعهی بیشتر
- LiveKit — راهنمای شروع سریع ایجنت صوتی — مرجع استاندارد سطح عملیاتی.
- Pipecat — نمونههای ایجنت صوتی — فریمورکی مناسب برای توسعهی مستقل.
- OpenAI Realtime API — مسیر مدیریتشدهی بومی برای صوت.
- Kyutai Moshi — مرجع مدلهای دوطرفهی همزمان (درس 15).
- Porcupine wake-word — فعالسازی با کلمهی بیدارباش.
- Anthropic — راهنمای استفاده از ابزارها — فراخوانی ابزار در LLM.