
بسیاری از مهندسانی که وارد حوزهی پردازش صوت و یادگیری ماشین میشوند، مدلها را بینقص آموزش میدهند اما با خطاهای خاموش روبهرو میشوند؛ خطاهایی مانند دو برابر شدن نرخ خطای کلمات در مدلهای تشخیص گفتار یا تولید نویزهای غیرعادی در مدلهای تبدیل متن به گفتار. ریشهی تمام این مشکلات به پیشپردازش سیگنال و درک نادرست از چگونگی تبدیل صدای پیوسته به دادههای عددی بازمیگردد.
در این درس پایهای، فاصلهی میان ارتعاشات فیزیکی هوا و تنسورهای مورد نیاز مدلهای هوش مصنوعی را پر میکنیم. یاد میگیرید که نرخ نمونهبرداری و عمق بیتی دقیقاً چه تاثیری روی داده دارند، چگونه با پدیدهی الیاسینگ مقابله کنید و چگونه با تبدیل فوریه، سیگنال صوتی را از حوزهی زمان به فرکانس ببرید.
تمام کدهای این درس سبک هستند و برای پیادهسازی و اجرای آنها به پردازندههای گرافیکی ابری یا ابزارهای پیچیده نیازی ندارید؛ محاسبات مستقیماً روی پردازندهی استاندارد سیستم شخصی شما قابل اجراست.
شکل موجها همان سیگنال خام هستند. طیفنگاشتها (Spectrograms) بازنمایی آن به شمار میروند. ویژگیهای مل (Mel features) نیز فرم سازگار با یادگیری ماشین هستند. هر پایپلاین مدرن بازشناسی گفتار (ASR) و تبدیل متن به گفتار (TTS) از همین پلهها بالا میرود، و اولین پله، درک نمونهبرداری و فوریه است.
صورت مسئله
میکروفون سیگنالی از تغییرات فشار بر حسب زمان تولید میکند؛ در حالی که شبکهی عصبی شما تنسور مصرف میکند. میان این دو، مجموعهای از قراردادها قرار دارد که اگر رعایت نشوند، به باگ خاموش ختم میشوند: مدل بدون خطا آموزش میبیند ولی نرخ خطای کلمات (WER) دو برابر میشود، صدای خروجی مدل TTS همراه با صدای «هیس» است، یا سیستم شبیهسازی صدا به جای ویژگیهای گوینده، مشخصات آکوستیک میکروفون را حفظ میکند.
هر باگی در سیستمهای صوتی در نهایت به یکی از این سه پرسش برمیگردد:
- دادهها با چه نرخ نمونهبرداری ضبط شدهاند و مدل چه نرخی را انتظار دارد؟
- آیا سیگنال دچار الیاسینگ (تداخل فرکانسی) شده است؟
- آیا محاسبات را روی نمونههای خام انجام میدهید یا روی بازنمایی فرکانسی؟
اگر این موارد را درست متوجه شوید، بقیهی مسیر فاز 6 برایتان روان خواهد شد. اگر این مبانی را اشتباه متوجه شوید، حتی مدلی مثل Whisper-Large-v4 هم خروجی بیکیفیت و غیرقابل استفادهای تولید خواهد کرد.
مفهوم
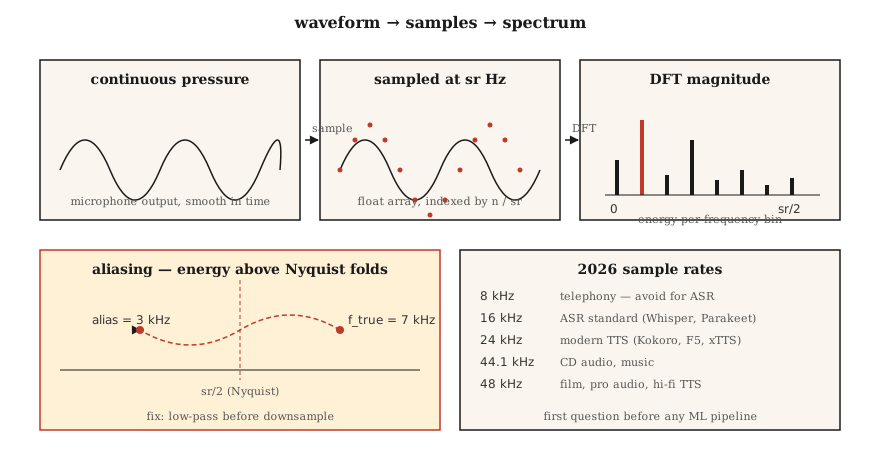
شکل موج (Waveform). آرایهای یکبعدی از اعداد اعشاری در بازهی [-1.0, 1.0]. ایندکسهای آن بر اساس شمارهی نمونه هستند. برای تبدیل به ثانیه، آن را بر نرخ نمونهبرداری تقسیم میکنیم: t = n / sr. یک قطعهصوت 10 ثانیهای با نرخ 16 kHz آرایهای شامل 160,000 عدد اعشاری است.
نرخ نمونهبرداری (Sampling rate یا sr). تعداد نمونهها در هر ثانیه. نرخهای رایج در سال 2026:
| نرخ | کاربرد |
|---|---|
| 8 kHz | تلفنهای قدیمی و سیستمهای VOIP قدیمی. نایکویست در 4 kHz حروف بیصدا را از بین میبرد؛ برای ASR مناسب نیست. |
| 16 kHz | استاندارد رایج ASR. مدلهایی مثل Whisper، Parakeet و SeamlessM4T v2 همگی از ورودی 16 kHz استفاده میکنند. |
| 22.05 kHz | آموزش ووکودر برای مدلهای TTS قدیمیتر. |
| 24 kHz | مدلهای مدرن TTS (مانند Kokoro، F5-TTS و xTTS v2). |
| 44.1 kHz | دیسکهای صوتی CD و موسیقی. |
| 48 kHz | سینما، تجهیزات حرفهای صدا، و مدلهای TTS با وضوح بالا (مانند VALL-E 2 و NaturalSpeech 3). |
نایکویست-شنون (Nyquist-Shannon). با نرخ نمونهبرداری sr میتوان فرکانسها را دقیقاً تا سقف sr/2 بدون ابهام بازنمایی کرد. مرز sr/2 را فرکانس نایکویست مینامند. انرژی فرکانسهای فراتر از نایکویست دچار الیاسینگ میشود — یعنی روی فرکانسهای پایینتر تا میخورد — و سیگنال را خراب میکند. پیش از کاهش نرخ نمونهبرداری، همیشه باید فیلتر پایینگذر اعمال کنید.
عمق بیتی (Bit depth). فرمت 16-bit PCM (عدد صحیح علامتدار 16 بیتی، با بازهی ±32,767) فرمت استانداردی برای انتقال فایل صوتی است. عمق 24 بیتی برای موسیقی و اعشاری 32 بیتی برای پردازش سیگنال دیجیتال (DSP) در حافظه به کار میرود. کتابخانههایی مانند soundfile دادهها را به صورت int16 میخوانند اما آنها را در قالب آرایههای float32 در بازهی [-1, 1] تحویل میدهند.
تبدیل فوریه (Fourier Transform). هر سیگنال متناهی از مجموع چند موج سینوسی با فرکانسهای مختلف تشکیل میشود. تبدیل فوریهی گسسته (DFT) برای N نمونه، N ضریب مختلط به دست میدهد؛ یعنی یک ضریب برای هر خانهی فرکانسی. bin k به فرکانس k · sr / N هرتز نگاشت میشود. اندازهی این ضریب بیانگر دامنهی آن فرکانس و زاویهاش نشاندهندهی فاز است.
تبدیل فوریهی سریع (FFT). الگوریتمی با پیچیدگی O(N log N) برای محاسبهی تبدیل فوریهی گسسته (DFT) در شرایطی که N توانی از 2 باشد. تمام کتابخانههای صوتی در پشتصحنه از FFT استفاده میکنند. یک FFT با 1024 نمونه در نرخ 16 kHz، دقیقاً 512 خانهی فرکانسی کاربردی در بازهی 0 تا 8 kHz با وضوح 15.6 هرتز در اختیارتان میگذارد.
فریمبندی و پنجرهگذاری (Framing + window). ما تبدیل فوریه را روی کل یک فایل صوتی به یکباره اعمال نمیکنیم. ابتدا صوت را به فریمهای همپوشان (معمولاً 25 میلیثانیهای با گام 10 میلیثانیه) خرد میکنیم، هر فریم را در یک تابع پنجره (مثل Hann یا Hamming) ضرب میکنیم تا ناپیوستگیهای لبهها حذف شوند، و سپس روی هر فریم FFT میزنیم. این همان تبدیل فوریهی کوتاهمدت (STFT) است. در درس 02 ادامهی همین مسیر را پی میگیریم.
پیادهسازی از صفر
مرحلهی 1: خواندن یک فایل صوتی و رسم شکل موج
کد code/main.py تنها از ماژول استاندارد wave استفاده میکند تا وابستگی جانبی نداشته باشد. در محیطهای پروداکشن، باید از soundfile یا torchaudio.load استفاده کنید (هر دو تاپل (waveform, sr) برمیگردانند):
import soundfile as sf
waveform, sr = sf.read("clip.wav", dtype="float32") # shape (T,), sr=intمرحلهی 2: سنتز موج سینوسی از اصول اولیه
import math

def sine(freq_hz, sr, seconds, amp=0.5):
    n = int(sr * seconds)
    return [amp * math.sin(2 * math.pi * freq_hz * i / sr) for i in range(n)]
یک موج سینوسی 440 هرتز (نت لا در اکتاو چهارم) با نرخ 16 kHz به مدت 1 ثانیه، 16,000 عدد اعشاری دارد. آن را با wave.open(..., "wb") و با کدگذاری 16-bit PCM ذخیره کنید.
مرحلهی 3: محاسبهی تبدیل فوریهی گسسته به صورت دستی
def dft(x):
    N = len(x)
    out = []
    for k in range(N):
        re = sum(x[n] * math.cos(-2 * math.pi * k * n / N) for n in range(N))
        im = sum(x[n] * math.sin(-2 * math.pi * k * n / N) for n in range(N))
        out.append((re, im))
    return out
پیچیدگی این کد O(N²) است؛ برای N=256 جهت اعتبارسنجی کارکرد مناسب است، اما برای صوت واقعی کارایی ندارد. در کدهای واقعی از numpy.fft.rfft یا torch.fft.rfft استفاده میشود.
مرحلهی 4: یافتن فرکانس غالب
ایندکس بیشینهی دامنه (k_star) به فرکانس k_star * sr / N نگاشت میشود. اگر این محاسبه را روی موج سینوسی 440 هرتز اجرا کنید، قلهی نمودار در خانهی فرکانسی 440 * N / sr دیده خواهد شد.
مرحلهی 5: مشاهدهی عینی الیاسینگ
یک موج سینوسی 7 kHz را با نرخ 10 kHz نمونهبرداری کنید (نایکویست برابر است با 5 kHz). از آنجا که فرکانس 7 kHz بالاتر از نایکویست است، روی فرکانس 10 − 7 = 3 kHz تا میخورد. در نتیجه، قلهی FFT در 3 kHz نمایان میشود. این همان آزمایش کلاسیک الیاسینگ است و دلیل اینکه همهی مبدلهای دیجیتال به آنالوگ و آنالوگ به دیجیتال (DAC/ADC) یک فیلتر پایینگذر پرشیب دارند.
استفاده از ابزارهای واقعی
پشتهی ابزارهایی که در سال 2026 در محیط عملیاتی به کار خواهید برد:
| تسک | کتابخانه | دلیل انتخاب |
|---|---|---|
| خواندن/نوشتن فرمتهای WAV/FLAC/OGG | soundfile (رپر libsndfile) |
سریعترین، پایدار، بازگرداندن دادهها به شکل float32. |
| بازنمونهبرداری (Resample) | torchaudio.transforms.Resample یا librosa.resample |
مجهز به فیلتر استاندارد حذف الیاسینگ (anti-aliasing). |
| STFT / مِل | torchaudio یا librosa |
بهینهشده برای GPU؛ سازگاری با اکوسیستم PyTorch. |
| استریمینگ بیدرنگ | sounddevice یا pyaudio |
بایندینگهای چندسکویی برای PortAudio. |
| بررسی مشخصات فایل | ffprobe یا soxi |
ابزار خط فرمانی، بسیار سریع برای مشاهدهی نرخ، تعداد کانال و کدک. |
یک قانون کلی: پیش از هر کاری، نرخ نمونهبرداری را هماهنگ کنید. مدلی مثل Whisper به ورودی تککاناله (mono) با نرخ 16 kHz و فرمت float32 نیاز دارد. اگر صوتی با نرخ 44.1 kHz و دوکاناله (stereo) به آن بدهید، خروجیهای نامربوطی تولید میکند که ممکن است شما را به اشتباه بیندازد و فکر کنید مدل باگ دارد.
خروجی این درس
کد را در مسیر outputs/skill-audio-loader.md ذخیره کنید. این مهارت به شما کمک میکند مطابقت ورودی صوتی با فرضیات مدل پاییندستی را بسنجید و در صورت لزوم، نرخ نمونهبرداری آن را به درستی تغییر دهید.
تمرینها
- ساده. ترکیبی 1 ثانیهای از فرکانسهای 220 هرتز، 440 هرتز و 880 هرتز با نرخ نمونهبرداری 16 kHz بسازید. روی آن تبدیل فوریهی گسسته (DFT) بزنید و ببینید آیا سه قله در خانههای فرکانسیِ مورد انتظار ظاهر میشوند یا نه.
- متوسط. یک فایل WAV صوتی 3 ثانیهای از صدای خودتان با نرخ 48 kHz ضبط کنید. سپس یک بار با
torchaudio.transforms.Resample(که فیلتر ضد الیاسینگ دارد) و یک بار با روش تقلیل ساده (انتخاب یکی از هر سه نمونه) آن را به 16 kHz کاهش دهید. روی هر دو تبدیل FFT بزنید. الیاسینگ دقیقاً در کدام فرکانسها خودش را نشان میدهد؟ - سخت. با استفاده از کتابخانهی
mathو تابع DFT پیادهشده در مرحلهی 3، یک STFT کامل از صفر بنویسید. طول فریم را 400، گام فریم (hop) را 160 و پنجره را Hann در نظر بگیرید. ماتریس دامنهها را باmatplotlib.pyplot.imshowرسم کنید. این همان طیفنگاشتی است که در درس 02 بررسی خواهیم کرد.
اصطلاحات کلیدی
| اصطلاح | معنای عامیانه | تعریف دقیق فنی |
|---|---|---|
| نرخ نمونهبرداری (Sample rate) | چند بار در ثانیه صدا را میخوانیم | فرکانسی بر حسب هرتز که مبدل آنالوگ به دیجیتال سیگنال را بر اساس آن میسنجد. |
| نایکویست (Nyquist) | بالاترین فرکانس قابل تشخیص | برابر با sr/2؛ انرژی فرکانسهای بالاتر به فرکانسهای پایینتر برمیگردد. |
| عمق بیتی (Bit depth) | کیفیت تفکیک هر نمونه | فرمت int16 یعنی 65,536 پله؛ فرمت float32 یعنی 24 بیت دقت برای اعداد در بازهی [-1, 1]. |
| تبدیل فوریهی گسسته (DFT) | فوریه برای دادههای گسسته | N نمونهی صوتی → N ضریب فرکانسی مختلط. |
| FFT | نسخهی سریع DFT | الگوریتمی با پیچیدگی O(N log N) که شرط اجرای آن توان دو بودن N است. |
| خانهی فرکانسی (Bin) | یک ستون از طیف فرکانسها | برابر با فرکانس k · sr / N هرتز؛ میزان وضوح فرکانسی نیز sr / N است. |
| تبدیل فوریهی کوتاهمدت (STFT) | موتوری که پشت طیفنگاشت کار میکند | اعمال تبدیل FFT روی فریمهای پنجرهگذاریشده در طول زمان. |
| الیاسینگ (Aliasing) | خطاهای فرکانسی ناخواسته | تاخوردن انرژی فرکانسهای فراتر از نایکویست روی خانههای فرکانسی پایینتر. |
برای مطالعهی بیشتر
- شنون (1949). ارتباطات در حضور نویز (Communication in the Presence of Noise) — مقالهی پایهای قضیهی نمونهبرداری.
- اسمیت — راهنمای دانشمندان و مهندسان برای پردازش سیگنال دیجیتال — یک کتاب مرجع و رایگان در حوزهی پردازش سیگنال دیجیتال.
- مستندات librosa — مبانی پردازش صوت — آموزش عملی همراه با نمونهکدها.
- هاینریش کوتروف — آکوستیک اتاقها (ویرایش ششم) — مرجعی برای درک اینکه چرا صوت واقعی هرگز یک موج سینوسی خالص نیست.
- استیو ادینز — یادداشتی دربارهی تحلیل خروجیهای FFT — راهنمایی کوتاه برای شناخت دقیق مفهوم خانههای فرکانسی.