
در سیستمهای پردازش صوتی آفلاین، میتوانید یک فایل ضبطشده را بدون دغدغهی زمان به مدل بدهید و متن تحویل بگیرید؛ اما در دستیارهای مکالمهای و باتهای تماس تلفنی، تاخیر بالای 500 میلیثانیه حس تعامل طبیعی را نابود میکند. اگر پاسخی فراتر از 1.5 ثانیه طول بکشد، کاربر تصور میکند دستیار متوقف شده یا صدای او را نشنیده است.
رسیدن به تاخیر ایدهآل حدود 400 میلیثانیه برای چرخهی کامل شنیدن، پردازش در مدل زبانی و پخش پاسخ صوتی، نیازمند معماری استریمینگ دقیق، بافرهای حلقوی (Ring Buffer)، تشخیص فوری فعالیت صوتی (VAD) و مکانیزم قطع آنی کلام (Barge-in) است. این درس پایههای مهندسی پردازش استریمینگ صدا را برای دستیارهای تعاملی مدرن باز میکند.
اگر برای بخش هوش مصنوعی و مدلهای زبانی قصد استفاده از APIهای خارجی مثل OpenAI Realtime API را دارید، توجه داشته باشید که کارتهای بانکی ایرانی برای پرداخت مستقیم ارزی قابل استفاده نیستند و برخی ارائهدهندگان ابری نیز دسترسی از IPهای داخلی را محدود کردهاند. با این حال، هستهی اصلی این پایپلاینها مانند بافرینگ و VAD روی CPU محلی اجرا میشوند و میتوانید زیرساخت انتقال صدا را با ابزارهای متنباز پایهریزی کنید.
پایپلاینهای دستهای (Batch) یک فایل را پردازش میکنند. پایپلاینهای بلادرنگ (Real-time)، 20 میلیثانیهی بعدی را پیش از رسیدن 20 میلیثانیهی پس از آن پردازش میکنند. تمام هوشهای مصنوعی مکالمهای، استودیوهای پخش زنده و باتهای تلفنی با همین سقف تاخیر (Latency budget) زنده میمانند یا میمیرند.
صورت مسئله
میخواهید دستیار صوتیتان حس زنده بودن را منتقل کند. تاخیر جابهجایی نوبت صحبت میان انسانها (فاصلهی سکوت تا شروع پاسخ) حدود 230 میلیثانیه است. هر تاخیری بالاتر از 500 میلیثانیه حس رباتیک ایجاد میکند و فراتر از 1500 میلیثانیه کاملاً خراب به نظر میرسد. سقف تاخیر مجاز برای یک چرخهی کامل شنیدن ← فهمیدن ← پاسخ دادن ← گفتن در سال 2026 به این صورت است:
| مرحله | سقف تاخیر |
|---|---|
| میکروفون ← بافر | 20 میلیثانیه |
| VAD | 10 میلیثانیه |
| ASR استریمینگ | 150 میلیثانیه |
| مدل زبانی بزرگ (اولین توکن) | 100 میلیثانیه |
| TTS استریمینگ (اولین چانک) | 100 میلیثانیه |
| رندر ← اسپیکر | 20 میلیثانیه |
| مجموع | ~400 میلیثانیه |
مدل Moshi (تیم Kyutai، سال 2024) تاخیر دوطرفهی کامل (Full-duplex) را به 200 میلیثانیه رساند. مدل GPT-4o-realtime (سال 2024) تاخیری حدود 320 میلیثانیه ثبت کرده است. پایپلاینهای آبشاری در سال 2022 با تاخیر 2500 میلیثانیهای عرضه میشدند. این بهبود 10 برابری حاصل سه تکنیک است: (1) استریمینگ در تمام بخشها، (2) پایپلاینبندی ناهمگام با استفاده از نتایج جزئی، و (3) تولید قابل توقف و قطعشدن.
مفاهیم پایه
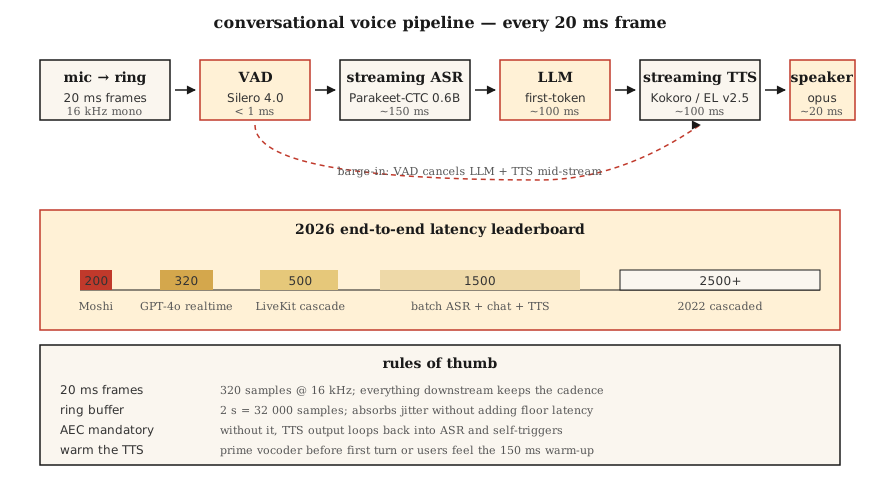
فریم / چانک / پنجره (Frame / chunk / window). صدای بلادرنگ در قالب بلوکهایی با اندازهی ثابت جریان پیدا میکند. یک انتخاب رایج: 20 میلیثانیه (320 نمونه در نرخ نمونهبرداری 16 کیلوهرتز). تمام بخشهای بعدی باید بتوانند پا به پای این ریتم پیش بروند.
بافر حلقوی (Ring buffer). یک بافر چرخشی با اندازهی ثابت است. تردِ تولیدکننده (Producer thread) فریمهای جدید را مینویسد و تردِ مصرفکننده (Consumer thread) آنها را میخواند. این ساختار مانع از تخصیص حافظه در مسیر بحرانی و پرمصرف (Hot path) میشود. اندازه ≈ سقف تاخیر × نرخ نمونهبرداری؛ بنابراین یک بافر حلقوی 2 ثانیهای با نرخ 16 کیلوهرتز برابر با 32,000 نمونه خواهد بود.
تشخیص فعالیت صوتی (Voice Activity Detection یا VAD). وقتی کسی صحبت نمیکند، جلوی پردازشهای مراحل بعدی را میگیرد. مدل Silero VAD 4.0 (سال 2024) به ازای هر فریم 30 میلیثانیهای، کمتر از 1 میلیثانیه زمان روی CPU میبرد. کتابخانهی webrtcvad گزینهی قدیمیتر آن است.
تبدیل گفتار به متن استریمینگ (Streaming ASR). مدلهایی که همزمان با رسیدن دادههای صوتی، متنهای پیادهشدهی جزئی را تولید میکنند. مدل Parakeet-CTC-0.6B در حالت استریمینگ (از فریمورک NeMo، سال 2024) با تاخیر 320 میلیثانیه به نرخ خطای کلمات (WER) 2 تا 5 درصد میرسد. مدل Whisper-Streaming (توسط Macháček و همکاران، 2023) با تکهتکه کردن ورودیهای Whisper به تاخیر شبهاستریمینگ حدود 2 ثانیه دست مییابد.
وقفه و پریدن در صحبت (Interruption یا Barge-in). وقتی کاربر وسط صحبت دستیار شروع به حرف زدن میکند، سیستم باید (الف) این ورود را تشخیص دهد، (ب) خروجی TTS را متوقف کند، و (ج) بقیهی خروجی مدل زبانی را دور بریزد. همهی این کارها باید ظرف 100 میلیثانیه انجام شوند، وگرنه کاربر احساس میکند دستیار کر است و صدایش را نمیشنود.
بستر انتقال WebRTC Opus. فریمهای 20 میلیثانیهای، نرخ نمونهبرداری 48 کیلوهرتز و بیتریت تطبیقی بین 8 تا 128 کیلوبیت بر ثانیه. این استاندارد وب و موبایل است. در سال 2026 ابزارهای LiveKit، Daily.co و Pion استکهای اصلی ساخت اپلیکیشنهای صوتی هستند.
بافر لرزش (Jitter buffer). بستههای شبکه معمولاً با تاخیر یا نامرتب به مقصد میرسند. بافر لرزش این بستهها را بازآرایی و هموار میکند؛ اگر خیلی کوچک باشد به وقفههای صوتی شنیدنی میانجامد، و اگر خیلی بزرگ باشد تاخیر ایجاد میکند. بازهی معمولی آن 60 تا 80 میلیثانیه است.
خطاهای رایج
- تداخل تردها (Thread contention). قفل مفسر سراسری (GIL) در پایتون در کنار مدلهای سنگین میتواند ترد پردازش صدا را از منابع محروم کند. از کتابخانههای صوتی مبتنی بر کالبکهای C (مانند sounddevice یا PortAudio) استفاده کنید و پایتون را از مسیر بحرانی دور نگه دارید.
- تاخیر تبدیل نرخ نمونهبرداری (Sample-rate conversion latency). تغییر نرخ نمونهبرداری در میانهی پایپلاین بین 5 تا 20 میلیثانیه تاخیر اضافه میکند. این تبدیل را در همان مرحلهی اول ورودی انجام دهید یا از نمونهگیرهایی با تاخیر صفر (مثل PolyPhase یا
soxr_hq) استفاده کنید. - آمادهسازی اولیه (TTS priming). حتی موتورهای سریع TTS مثل Kokoro هم در اولین درخواست 100 تا 200 میلیثانیه زمان برای گرم شدن مدل هدر میدهند. مدل را کَش کنید و پیش از اولین نوبت واقعی مکالمه، با یک اجرای آزمایشی گرم نگهاش دارید.
- حذف اکو (Echo cancellation). بدون AEC (حذف اکوی صوتی)، صدای خروجی اسپیکر دوباره وارد میکروفون میشود و مدل ASR شروع به پیادهسازی صدای خودِ بات میکند. کتابخانهی WebRTC AEC3 گزینهی استاندارد متنباز برای این کار است.
پیادهسازی از صفر
مرحلهی 1: بافر حلقوی
import collections

class RingBuffer:
    def __init__(self, capacity):
        self.buf = collections.deque(maxlen=capacity)
    def write(self, frame):
        self.buf.extend(frame)
    def read(self, n):
        return [self.buf.popleft() for _ in range(min(n, len(self.buf)))]
    def level(self):
        return len(self.buf)
ظرفیت این بخش سقف تاخیر بافرسازی را مشخص میکند. 32,000 نمونه در نرخ 16 کیلوهرتز معادل 2 ثانیه است.
مرحلهی 2: گیت VAD
def simple_energy_vad(frame, threshold=0.01):
    return sum(x * x for x in frame) / len(frame) > threshold ** 2
در محیط عملیاتی آن را با Silero VAD جایگزین کنید:
import torch
vad, _ = torch.hub.load("snakers4/silero-vad", "silero_vad")
is_speech = vad(torch.tensor(frame), 16000).item() > 0.5مرحلهی 3: ASR استریمینگ
# استریمینگ Parakeet-CTC-0.6B از طریق NeMo
from nemo.collections.asr.models import EncDecCTCModelBPE
asr = EncDecCTCModelBPE.from_pretrained("nvidia/parakeet-ctc-0.6b")
# chunk_ms=320 ms, look_ahead_ms=80 ms
for chunk in audio_stream():
    partial_text = asr.transcribe_streaming(chunk)
print(partial_text, end="\r")مرحلهی 4: مدیریت وقفه و پریدن در صحبت
class Dialog:
    def __init__(self):
        self.tts_task = None

    def on_user_speech(self, frame):
        if self.tts_task and not self.tts_task.done():
            self.tts_task.cancel()   # barge-in
        # سپس ورودی به ASR استریمینگ داده شود

    def on_final_user_utterance(self, text):
        self.tts_task = asyncio.create_task(self.reply(text))

    async def reply(self, text):
        async for tts_chunk in llm_then_tts(text):
speaker.write(tts_chunk)پیادهسازی این بخش کاملاً به ورودی/خروجی ناهمگام (Async I/O) و استریمینگ لغوپذیرِ TTS وابسته است. متد peerconnection.stop() روی ترک صوتی در WebRTC راهکار استاندارد این کار به شمار میرود.
استفاده از ابزارهای واقعی
استک پیشنهادی سال 2026:
| لایه | ابزار انتخابی |
|---|---|
| بستر انتقال داده | LiveKit (مبتنی بر WebRTC) یا Pion (زبان Go) |
| VAD | Silero VAD 4.0 |
| ASR استریمینگ | Parakeet-CTC-0.6B یا Whisper-Streaming |
| مدل زبانی (تولید اولین توکن) | Groq، Cerebras یا vLLM-streaming |
| TTS استریمینگ | Kokoro یا ElevenLabs Turbo v2.5 |
| حذف اکو | WebRTC AEC3 |
| سرتاسری و نیتیو (End-to-end) | OpenAI Realtime API یا Moshi |
دامهای رایج
- بافرسازی 500 میلیثانیهای برای اطمینان بیشتر. این بافر دقیقاً همان کف تاخیر سیستم شماست؛ آن را کاهش دهید.
- پین نکردن تردها. اجرای کالبک صدا روی تردی با اولویت کمتر از رابط کاربری (UI)، زیر بار پردازشی باعث سکته و پرش صدا میشود.
- چانکهای خیلی کوچک در TTS. قطعات صوتی کمتر از 200 میلیثانیه در مرحلهی وکودر (Vocoder) نویزهای صوتی محسوسی تولید میکنند. چانکهای 320 میلیثانیهای بهترین تعادل را دارند.
- نبود بافر لرزش. شبکههای واقعی همیشه لرزش دارند؛ بدون هموارسازی، صدا دچار صدای تَقتَق خواهد شد.
- مدیریت خطای سادهانگارانه. پایپلاینهای صوتی باید ضدکرش باشند. بروز یک خطا نباید کل نشست مکالمه را از بین ببرد.
خروجی این درس
نتیجه را در فایل outputs/skill-realtime-designer.md ذخیره کنید. یک پایپلاین صوتی بلادرنگ را همراه با مشخص کردن سقف تاخیر دقیق هر مرحله طراحی کنید.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. این کد یک بافر حلقوی همراه با VAD مبتنی بر سطح انرژی را شبیهسازی میکند و تاخیر هر مرحله را برای یک استریم آزمایشی 10 ثانیهای چاپ مینماید. - متوسط. با استفاده از کتابخانهی
sounddevice، یک حلقهی مستقیم (Passthrough) بسازید که صدای میکروفون را در قالب فریمهای 20 میلیثانیهای دریافت کند و وضعیت VAD را در هر فریم نمایش دهد. - دشوار. یک تست اکوی دوطرفهی کامل با
aiortcپیادهسازی کنید: مرورگر ← WebRTC ← پایتون ← WebRTC ← مرورگر. سپس تاخیر رفتوبرگشت صدا از خروجی تا ورودی (Glass-to-glass) را با ارسال یک پالس 1 کیلوهرتزی اندازهگیری کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوهای عامیانه | معنای دقیق فنی |
|---|---|---|
| بافر حلقوی (Ring buffer) | صف چرخشی | صف FIFO با اندازهی ثابت و بدون نیاز به قفل (یا با قفل SPSC) برای فریمهای صوتی. |
| VAD | فیلتر سکوت | مدل یا روش ابتکاری (Heuristic) که کلام را از سکوت یا نویز تفکیک میکند. |
| ASR استریمینگ | تبدیل گفتار به متن بلادرنگ | مدلی با پنجرهی پیشنگری محدود که همگام با دریافت صدا، متن جزئی را تولید میکند. |
| بافر لرزش (Jitter buffer) | هموارساز شبکه | صفی که بستههای نامرتب شبکه را مرتب میکند؛ عموماً بین 60 تا 80 میلیثانیه. |
| حذف اکو (AEC) | حذف بازگشت صدا | حذف سیگنال بازگشتی اسپیکر به میکروفون. |
| پریدن در صحبت (Barge-in) | قطع کردن توسط کاربر | قابلیتی که حین پخش TTS متوجه صحبت کاربر میشود و بلافاصله پخش را متوقف میکند. |
| دوطرفهی کامل (Full duplex) | مکالمهی همزمان دوطرفه | قابلیتی که در آن کاربر و بات میتوانند همزمان صحبت کنند؛ مثل مدل Moshi. |
برای مطالعهی بیشتر
- Macháček و همکاران (2023). Whisper-Streaming — استفاده از مدل Whisper در حالت تکهتکه و شبهاستریمینگ.
- تیم Kyutai (2024). Moshi — دستیار صوتی دوطرفهی کامل با تاخیر 200 میلیثانیه.
- فریمورک ایجنتهای LiveKit (سال 2024) — ارکستراسیون ایجنتهای صوتی در محیط عملیاتی.
- مخزن گیتهاب Silero VAD — ماژول تشخیص فعالیت صوتی با تاخیر زیر 1 میلیثانیه و تحت لایسنس Apache 2.0.
- مقالهی WebRTC AEC3 — الگوریتم متنباز حذف اکوی صوتی.