
تولید گفتار طبیعی از روی متن یکی از بخشهای مهم دستیارهای صوتی، سیستمهای پاسخگویی خودکار و تولید محتواست. در گذشته راهاندازی چنین سیستمهایی نیازمند مدلهای پیچیده و سرورهای مجهز به کارتهای گرافیک گرانقیمت بود. اما با پیشرفت معماریهای مدرن، اکنون میتوان مدلهای بهینهای مثل Kokoro را حتی روی پردازندههای معمولی (CPU) لپتاپ بهصورت محلی اجرا کرد.
اگر از داخل ایران قصد دانلود وزنهای مدل یا کتابخانههای مربوطه از مخازنی مانند Hugging Face یا PyPI را داشته باشید، ممکن است به دلیل اختلالات شبکه با کندی یا قطعی مواجه شوید؛ استفاده از ابزارهای مدیریت دانلود و میرورهای مطمئن میتواند این روند را پایدار کند. همچنین برای شبیهسازی پیشرفتهی صدا با مدلهایی مثل F5-TTS، شناخت کامل اجزای پایپلاین شامل فرانتاند متنی، مدل آکوستیک و ووکوودر به شما کمک میکند در کمترین زمان بهترین نتیجه را بگیرید.
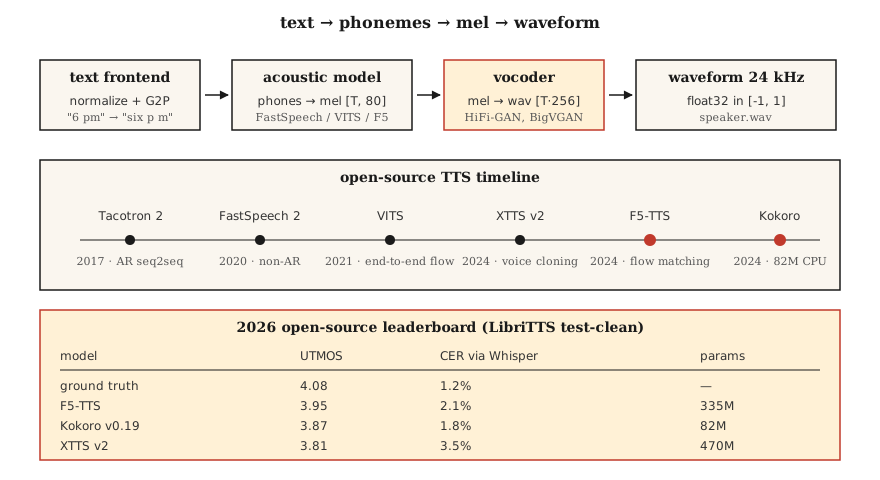
سیستم بازشناسی گفتار (ASR) صوت را به متن تبدیل میکند؛ در مقابل، تبدیل متن به گفتار (TTS) معکوس آن عمل میکند. معماری استاندارد سال 2026 از سه بخش تشکیل شده است: متن به توکن، توکن به مل، و مل به شکلموج (waveform). برای هر بخش، مدلی پیشفرض وجود دارد که بهراحتی روی یک لپتاپ اجرا میشود.
صورت مسئله
رشتهمتنی در دست دارید: «لطفاً ساعت 6 عصر به من یادآوری کن به گلدانها آب بدهم.» برای یک دستیار صوتی زنده، به قطعهصوتی 3 ثانیهای نیاز دارید که طبیعی به گوش برسد، آهنگ و پروزودی (prosody) درستی (مکثها و تکیهها) داشته باشد، کلمهی «plants» را با مصوت صحیح ادا کند و اجرای آن روی CPU کمتر از 300 میلیثانیه زمان ببرد. در کنار اینها، باید بتوانید صداها را عوض کنید، ورودیهای دوزبانه (code-switching) مثل «remind me at 6 pm, daijoubu?» را مدیریت کنید و در تلفظ اسامی خاص هم خرابکاری نکنید.
پایپلاینهای مدرن TTS چنین ساختاری دارند:
- فرانتاند متنی (Text frontend): نرمالسازی متن (تاریخها، اعداد، ایمیلها)، تبدیل به واجها یا توکنهای زیرکلمه (subword tokens)، و پیشبینی ویژگیهای پروزودی.
- مدل آکوستیک (Acoustic model): تبدیل متن به طیفنگار مل (mel spectrogram). Tacotron 2 (سال 2017)، FastSpeech 2 (سال 2020)، VITS (سال 2021)، F5-TTS (سال 2024) و Kokoro (سال 2024).
- ووکوودر (Vocoder): تبدیل مل به شکلموج. WaveNet (سال 2016)، WaveRNN، HiFi-GAN (سال 2020)، BigVGAN (سال 2022) و ووکوودرهای عصبی مبتنی بر کدک از سال 2024 به بعد.
در سال 2026، با ظهور مدلهای دیفیوژن سرتاسری و تطبیق جریان (flow-matching)، مرز میان مدل آکوستیک و ووکوودر کمرنگ شده است؛ اما مدل ذهنی سهبخشی همچنان بهترین ابزار برای خطایابی است.
مفاهیم پایه
مدل Tacotron 2 (سال 2017): معماری Seq2seq؛ شامل امبدینگ کاراکتر، انکودر BiLSTM، اتنشن حساس به مکان (location-sensitive attention)، و دکودر اتورگرسیو LSTM که فریمهای مل را خروجی میدهد. این مدل به دلیل ماهیت اتورگرسیو کند است و روی متنهای طولانی نوسان دارد، اما هنوز به عنوان یک خط پایهی مقایسهای به آن ارجاع داده میشود.
مدل FastSpeech 2 (سال 2020): غیراتورگرسیو. پیشبین مدتزمان (duration predictor) مشخص میکند که به هر واج چند فریم مل اختصاص یابد. پردازش در یک گذر (1-pass) انجام میشود و 10 برابر سریعتر از Tacotron است. اگرچه به دلیل همترازی یکنواخت (monotonic alignment) کمی از لحن طبیعی صدا کاسته میشود، اما همهجا به کار گرفته شده است.
مدل VITS (سال 2021): انکودر، بخش تخمین دیرش مبتنی بر جریان، و ووکوودر HiFi-GAN را بهصورت سرتاسری و به کمک استنتاج متغیری (variational inference) همزمان آموزش میدهد. کیفیت بالا در قالب مدلی یکپارچه، آن را به مدل غالب متنباز بین سالهای 2022 تا 2024 تبدیل کرد. نسخههای مشتقشده: YourTTS (چندگویندهی زیروشات) و XTTS v2 (سال 2024، Coqui).
مدل F5-TTS (سال 2024): ترنسفورمر دیفیوژن بر پایهی تطبیق جریان. پروزودی طبیعی دارد و با تنها 5 ثانیه فایل مرجع، کلونینگ زیروشات صدا را انجام میدهد. این مدل 335 میلیون پارامتری، در صدر جدولهای ارزیابی متنباز سال 2026 قرار دارد.
مدل Kokoro (سال 2024): کوچک (82 میلیون پارامتر)، قابل اجرا روی CPU و بهترین TTS انگلیسی برای کاربردهای بلادرنگ. واژگان بسته (closed-vocabulary)، ویژهی زبان انگلیسی و تحت مجوز Apache-2.0.
مدلهای OpenAI TTS-1-HD، ElevenLabs v2.5 و Google Chirp-3: مدلهای تجاری پیشرو (SOTA). برچسبهای احساسی ElevenLabs v2.5 (مانند «[whispered]» یا «[laughing]») و صداهای شخصیتی، بخش اعظم تولید کتابهای صوتی سال 2026 را تسخیر کردهاند.
سیر تکامل ووکوودرها
| دوره | ووکوودر | تاخیر | کیفیت |
|---|---|---|---|
| 2016 | WaveNet | فقط آفلاین | بهترین کیفیت زمان عرضه |
| 2018 | WaveRNN | نزدیک به بلادرنگ | خوب |
| 2020 | HiFi-GAN | 100 برابر سریعتر از بلادرنگ | بسیار نزدیک به انسان |
| 2022 | BigVGAN | 50 برابر سریعتر از بلادرنگ | قابلیت تعمیم بالا به گویندگان و زبانهای گوناگون |
| 2024 | SNAC, DAC (کدکهای عصبی) | یکپارچهشده با مدلهای اتورگرسیو | توکنهای گسسته و کارآمد از نظر بیتریت |
تا سال 2026، اغلب مدلهای TTS بهصورت سرتاسری از متن به شکلموج میرسند و طیفنگار مل یک بازنمایی درونی است.
ارزیابی
- شاخص MOS (امتیاز میانگین نظرات): مقیاس 1 تا 5 بر پایهی جمعسپاری انسانی. همچنان استاندارد طلایی اما فوقالعاده کند است.
- شاخص CMOS (امتیاز MOS مقایسهای): ترجیح مدل A در برابر B با بازههای اطمینان دقیقتر در هر برچسبگذاری.
- معیارهای UTMOS و DNSMOS: پیشبینهای عصبی MOS بدون نیاز به صوت مرجع؛ مورد استفاده در لیدربوردها.
- نرخ خطای کاراکتر (CER) از طریق ASR: عبور دادن خروجی صوتی TTS از Whisper و محاسبهی CER نسبت به متن ورودی؛ معیاری برای وضوح کلام.
- شباهت کسینوسی امبدینگ گوینده (SECS): ارزیابی کیفیت کلونینگ صدا.
آمارهای سال 2026 روی مجموعهدادهی LibriTTS (مجموعهی آزمون test-clean):
| مدل | UTMOS | CER (از طریق Whisper) | حجم مدل |
|---|---|---|---|
| دادهی واقعی | 4.08 | 1.2% | — |
| F5-TTS | 3.95 | 2.1% | 335M |
| XTTS v2 | 3.81 | 3.5% | 470M |
| VITS | 3.62 | 3.1% | 25M |
| Kokoro v0.19 | 3.87 | 1.8% | 82M |
| Parler-TTS Large | 3.76 | 2.8% | 2.3B |
پیادهسازی از صفر
گام 1: واجنگاری متن ورودی
from phonemizer import phonemize
ph = phonemize("Hello world", language="en-us", backend="espeak")
# 'həloʊ wɜːld'واجها پل ارتباطی جهانی متن با صوت هستند. هرگز متن خام را به مدلهایی با کیفیت کمتر از VITS ورودی ندهید.
گام 2: اجرای Kokoro (انتخاب پیشفرض CPU در سال 2026)
from kokoro import KPipeline
tts = KPipeline(lang_code="a")  # "a" = American English
audio, sr = tts("Please remind me to water the plants at 6 pm.", voice="af_bella")
# audio: float32 tensor, sr=24000
کاملاً آفلاین، در قالب یک فایل تکی و با 82 میلیون پارامتر اجرا میشود.
گام 3: اجرای F5-TTS با کلونینگ صدا
from f5_tts.api import F5TTS
tts = F5TTS()
wav = tts.infer(
    ref_file="my_voice_5s.wav",
    ref_text="The quick brown fox jumps over the lazy dog.",
    gen_text="Please remind me to water the plants.",
)
تنها یک قطعهی مرجع 5 ثانیهای و متن آن را بدهید؛ F5 پروزودی و طنین صدا (timbre) را بازسازی میکند.
گام 4: ووکوودر HiFi-GAN از پایه
این کد کامل در یک فایل آموزشی نمیگنجد، اما ساختار کلی آن به این شکل است:
class HiFiGAN(nn.Module):
def __init__(self, mel_channels=80, upsample_rates=[8, 8, 2, 2]):
super().__init__()
# 4 بلوک بیشنمونهبرداری (upsample)، مجموعاً 256x برای رفتن از نرخ مل به نرخ صدا
...
def forward(self, mel):
return self.blocks(mel) # -> waveformآموزش مدل به این صورت است: تمایزدهنده (discriminator روی پنجرههای کوتاه) + تابع زیان (loss) بازسازی طیفنگار مل + تابع زیان تطبیق ویژگی (feature-matching loss). این فناوری تجاریسازی شده و از مد افتاده است؛ بهجای بازنویسی، از چکپوینتهای از پیشآموزشدیدهی مخزن hifi-gan یا nvidia-NeMo استفاده کنید.
گام 5: پایپلاین کامل (شبهکد)
text = "Please remind me at 6 pm."
phones = phonemize(text)
mel = acoustic_model(phones, speaker=alice)      # [T, 80]
wav = vocoder(mel)                                # [T * 256]
soundfile.write("out.wav", wav, 24000)
استفاده از ابزارهای واقعی
پشتهی فناوری در سال 2026:
| موقعیت | ابزار انتخابی |
|---|---|
| دستیار صوتی بلادرنگ انگلیسی | Kokoro (روی CPU) یا XTTS v2 (روی GPU) |
| کلونینگ صدا از فایل 5 ثانیهای | F5-TTS |
| صداهای شخصیتی تجاری | ElevenLabs v2.5 |
| روخوانی کتاب صوتی | ElevenLabs v2.5 یا XTTS v2 به همراه فاینتیون |
| زبانهای کممنبع | آموزش VITS روی 5 تا 20 ساعت داده از زبان هدف |
| صداهای احساسی و بیانگر | ElevenLabs v2.5 یا فاینتیون StyleTTS 2 |
بهترین گزینههای متنباز در سال 2026: F5-TTS برای کیفیت و Kokoro برای کارایی. سراغ Tacotron نروید مگر اینکه بخواهید تاریخچه مرور کنید.
دامهای رایج
- نداشتن ابزار نرمالسازی متن: کلمهی «.Dr» باید «Doctor» خوانده شود یا نام خیابان («Drive»)؟ «2026» به چه شکل ادا شود؛ «twenty twenty six» یا «two zero two six»؟ حتماً متن را پیش از واجنگار نرمالسازی کنید.
- اسامی خاص خارج از واژگان (OOV): کلمهای مانند «Ghumare» چطور تلفظ میشود؛ «ghyu-mair»؟ همیشه یک مدل کمکی نویسه به واج (grapheme-to-phoneme) برای توکنهای ناشناخته کنار پایپلاین داشته باشید.
- برش دامنهی صوت (Clipping): ووکوودر بهندرت صدا را کلیپ میکند، اما ناهماهنگی در مقیاس مل در زمان استنتاج، خروجی را از محدودهی 1.0± فراتر میبرد. همیشه از
np.clip(wav, -1, 1)استفاده کنید. - ناهماهنگی نرخ نمونهبرداری: خروجی Kokoro نرخ نمونهبرداری 24 کیلوهرتز دارد، اما شاید پایپلاین بعدی شما 16 کیلوهرتز بخواهد؛ در این صورت باید بازنمونهبرداری (resample) کنید، وگرنه دچار الیاسینگ (تداخل فرکانسی) میشوید.
تحویل پروژه
این سند را با نام outputs/skill-tts-designer.md ذخیره کنید. بر اساس صدا، تاخیر و زبان مدنظرتان، یک پایپلاین تبدیل متن به گفتار طراحی کنید.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. این برنامه یک دیکشنری واج از واژگانی ساده میسازد، مدتزمان هر واج را تخمین میزند و زمانبندی ساختگی یک «مل» را چاپ میکند. - متوسط. Kokoro را نصب کنید، یک جملهی یکسان را با دو صدای
af_bellaوam_adamبسازید و طول مدت فایلهای صوتی و کیفیت حسی آنها را با هم مقایسه کنید. - سخت. صدایی 5 ثانیهای از خودتان ضبط کنید. با F5-TTS آن را شبیهسازی کنید و شباهت کسینوسی امبدینگ گوینده (SECS) بین صدای مرجع و صدای شبیهسازیشده را گزارش دهید.
اصطلاحات کلیدی
| اصطلاح | در گفتگوی روزمره | معنای دقیق فنی |
|---|---|---|
| Phoneme (واج) | واحد صوتی | ردهی صوتی انتزاعی؛ شامل 39 واج در زبان انگلیسی (ARPABet). |
| Duration predictor (پیشبین مدتزمان) | طول زمان ادای هر واج | خروجی مدل غیراتورگرسیو؛ فریمهای صحیح به ازای هر واج. |
| Vocoder (ووکوودر) | تبدیل مل به شکلموج | شبکهی عصبی که طیفنگار مل را به نمونههای صوتی خام نگاشت میکند. |
| HiFi-GAN | ووکوودر استاندارد | مبتنی بر شبکههای GAN؛ ساختار مسلط بین سالهای 2020 تا 2024. |
| MOS | کیفیت شنیداری حسی | میانگین امتیاز 1 تا 5 بر اساس نظر ارزیابهای انسانی. |
| SECS | معیار کلونینگ صدا | شباهت کسینوسی بین امبدینگ گویندهی هدف و خروجی مدل. |
| F5-TTS | پیشتاز متنباز سال 2024 | دیفیوژن با تطبیق جریان؛ کلونینگ زیروشات. |
| Kokoro | پیشتاز پردازندههای CPU برای انگلیسی | مدلی با 82 میلیون پارامتر و مجوز Apache 2.0. |
برای مطالعهی بیشتر
- Shen et al. (2017). Tacotron 2 — مدل پایهی Seq2seq.
- Kim, Kong, Son (2021). VITS — مدل سرتاسری مبتنی بر جریان.
- Chen et al. (2024). F5-TTS — مدل پیشتاز متنباز فعلی.
- Kong, Kim, Bae (2020). HiFi-GAN — ووکوودری که تا سال 2026 همچنان استفاده میشود.
- مدل Kokoro-82M روی HuggingFace — مدل سبک انگلیسی سازگار با CPU محصول سال 2024.