
گسترش سریع مدلهای کلونسازی صدا، سامانههای احراز هویت صوتی و مراکز تماس را با تهدید جدی دیپفیکهای صوتی روبهرو کرده است. بدون تمهیدات دفاعی مشخص، هر ابزار تولید صوت میتواند راه را برای سوءاستفادههای بیومتریک و جعل هویت هموار کند.
راهکار پایدار در محیطهای عملیاتی، پیادهسازی یک سامانهی دفاع چندلایه است؛ ترکیب شناساگرهای مبتنی بر یادگیری ماشین (مانند AASIST و RawNet2) برای تفکیک صدای واقعی از مصنوعی، و جاسازی همزمان سیگنالهای نامحسوس (مانند AudioSeal) برای حفظ سندیت فایلهای خروجی.
در این درس یاد میگیرید چگونه خطاهای ارزیابی مانند EER را بسنجید، نقاط ضعف مدلهای واترمارک را در برابر تغییرات گام صدا پوشش دهید و لایههای دفاعی را برای محیط پروداکشن آماده کنید.
کلونسازی صدا (Voice cloning) بسیار سریعتر از راهکارهای دفاعی از راه رسید. سامانههای صوتی محیط عملیاتی (production) در سال 2026 به دو چیز نیاز دارند: یک شناساگر (مثل AASIST یا RawNet2) که گفتار واقعی را از جعلی تشخیص دهد، و یک واترمارک (مثل AudioSeal) که زیر بار فشردهسازی و ویرایش فایل دوام بیاورد. یا هر دو را پیاده کنید، یا اصلاً سراغ کلونسازی صدا نروید.
صورت مسئله
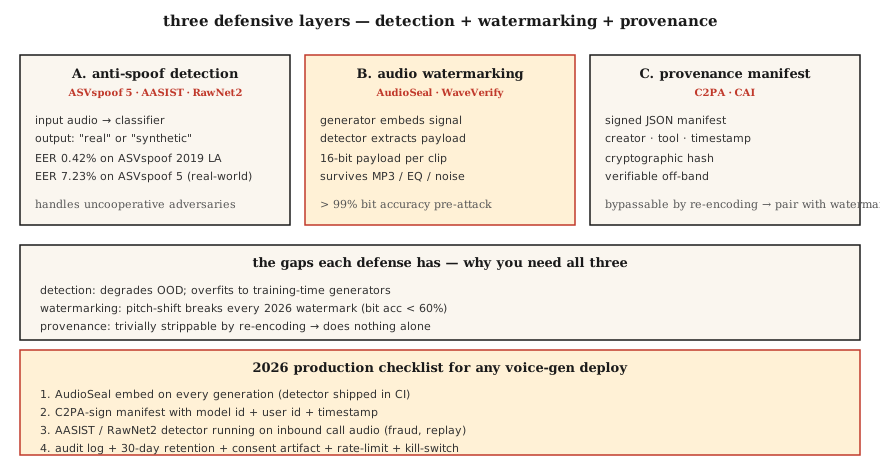
سه لایهی دفاعی مرتبط با هم:
- ضدجعل / تشخیص جعل عمیق (Anti-spoofing / deepfake detection): آیا این قطعهی صوتی ساختگی است یا واقعی؟ بنچمارکهای ASVspoof (از 2019 و 2021 تا 5) استاندارد طلایی این حوزهاند.
- واترمارکگذاری صوتی (Audio watermarking): گنجاندن یک سیگنال نامحسوس در صدای تولیدشده تا شناساگر بتواند بعداً آن را استخراج کند. AudioSeal (متعلق به Meta) و WavMark گزینههای متنباز دردسترس هستند.
- تأیید منشأ و سندیت (Authenticated provenance): امضای رمزنگاریشدهی فایلهای صوتی بههمراه متادیتا؛ بر اساس استاندارد C2PA و ابتکار عمل اصالت محتوا (Content Authenticity Initiative).
شناسایی برای مهاجمانی است که با شما همکاری نمیکنند. واترمارکگذاری هم پاسخگوی الزامات قانونی و انطباق (compliance) است؛ صدای تولیدشده با هوش مصنوعی باید برچسبخورده و قابلشناسایی باشد. در سال 2026، حضور هر دو لایه الزامی است.
مفاهیم پایه
بنچمارک ASVspoof 5 — استاندارد سالهای 2024 و 2025
بزرگترین تغییرات نسبت به نسخههای پیشین:
- دادههای جمعسپاریشده (Crowdsourced): خبری از فایلهای تروتمیز استودیویی نیست؛ شرایط کاملاً واقعی است.
- حدود 2000 گوینده: در مقایسه با حدود 100 گوینده در نسخههای قبلی.
- 32 الگوریتم حمله: شامل تبدیل متن به گفتار (TTS)، تبدیل صدا (Voice conversion) و آشفتگیهای متخاصم (Adversarial perturbation).
- دو بخش رقابتی (Track): بخش اقدام متقابل (Countermeasure یا CM) برای تشخیص مستقل، و بخش ASV مقاوم در برابر جعل (SASV) برای سامانههای بیومتریک.
پیشرفتهترین نتیجهی ثبتشده (SOTA) روی ASVspoof 5 حدود 7.23% نرخ خطای برابر (EER) است. همین معیار روی نسخهی قدیمیتر ASVspoof 2019 LA برابر با 0.42% بود. برای استقرار در دنیای واقعی، باید روی فایلهای صوتی واقعی و پیشبینینشده انتظار 5 تا 10 درصد EER داشته باشید.
AASIST و RawNet2 — خانوادههای مدلهای تشخیص
مدل AASIST: معرفیشده در سال 2021 با بهروزرسانی تا سال 2026؛ مبتنی بر اتنشن گرافی روی ویژگیهای طیفی. در حال حاضر بهترین عملکرد (SOTA) را در وظیفهی اقدام متقابل ASVspoof 5 دارد.
مدل RawNet2: دارای فرانتاند کانولوشنی روی شکلموج خام بههمراه بکبون TDNN. بیسلاینی سادهتر است، اما با فاینتیونینگ همچنان عملکرد رقابتی دارد.
ترکیب NeXt-TDNN و ویژگیهای یادگیری خودنظارتی (SSL): نسخهی سال 2025 با ساختاری شبیه ECAPA، ویژگیهای WavLM و تابع زیان کانونی (Focal loss). این معماری به همان EER معادل 0.42% روی ASVspoof 2019 LA دست پیدا میکند.
مدل AudioSeal — واترمارک پیشفرض در سال 2024
مدل AudioSeal از شرکت Meta (عرضهشده در ژانویهی 2024 و انتشار نسخهی 0.2 در دسامبر 2024). ویژگیهای کلیدی طراحی:
- موقعیتیابی محلی (Localized): واترمارک را فریمبهفریم با تفکیکپذیری نمونهبرداری 16 کیلوهرتز (یک شانزدههزارم ثانیه) شناسایی میکند.
- آموزش همزمان مولد و شناساگر: مولد یاد میگیرد سیگنالی غیرقابلشنیدن جاسازی کند و شناساگر هم یاد میگیرد آن را پس از انواع افزایش داده (Augmentation) پیدا کند.
- مقاوم (Robust): در برابر فشردهسازی MP3 و AAC، اکولایزر، تغییر سرعت تا 10%± و ترکیب با نویز تا نسبت سیگنال به نویز 10+ دسیبل دوام میآورد.
- سریع: شناساگر با سرعت 485 برابر بلادرنگ (Realtime) اجرا میشود؛ یعنی 1000 برابر سریعتر از WavMark.
- ظرفیت: امکان جاسازی یک پیام 16 بیتی در هر پارهگفتار (که میتواند شامل شناسهی مدل، برچسب زمانی تولید و شناسهی کاربر باشد).
مدل WavMark
بیسلاین متنبازِ پیش از AudioSeal که بر پایهی شبکه عصبی معکوسپذیر کار میکرد و ظرفیت 32 بیت در ثانیه داشت. مشکلات آن:
- همگامسازی به روش جستوجوی فراگیر (Brute-force) بسیار کند است.
- با نویز گاوسی یا فشردهسازی MP3 از بین میرود.
- برای پردازش بلادرنگ مناسب نیست.
مدل WaveVerify (ژوئیه 2025)
نقاط ضعف AudioSeal، بهویژه در برابر دستکاریهای زمانی (معکوس کردن، تغییر سرعت) را برطرف کرده است. این مدل از مولد مبتنی بر FiLM و شناساگر مبتنی بر ترکیب متخصصان (Mixture-of-Experts) بهره میبرد. در حملات استاندارد عملکردی همپای AudioSeal دارد و ویرایشهای زمانی را بهخوبی مدیریت میکند.
نقطهی نفوذی که مهاجمان از آن سوءاستفاده میکنند
به گزارش بنچمارک AudioMarkBench: «در صورت تغییر زیروبمی صدا (Pitch shift)، دقت بازیابی بیت در تمام واترمارکها به زیر 0.6 افت میکند که نشاندهندهی حذف تقریباً کامل واترمارک است.» تغییر زیروبمی صدا یک حملهی فراگیر است. هیچ واترمارکی در سال 2026 در برابر تغییر شدید گام صدا کاملاً مقاوم نیست. به همین دلیل باید همیشه شناسایی (AASIST) را در کنار واترمارکگذاری به کار بگیرید.
استاندارد C2PA / ابتکار عمل اصالت محتوا
این استاندارد یک تکنیک یادگیری ماشین نیست، بلکه فرمت مانیفست است. فایلهای صوتی حاوی متادیتای امضاشدهی رمزنگاریشده دربارهی ابزار ساخت، پدیدآورنده و تاریخ هستند. ابزارهایی مانند Audobox و Seamless از آن استفاده میکنند. این روش برای منشأ و سندیت عالی است؛ اما اگر فرد مخربی فایل را دوباره انکود کند و متادیتا را بردارد، هیچ کاری از دستش برنمیآید.
پیادهسازی گامبهگام
گام 1: یک شناساگر ساده با ویژگیهای طیفی (نسخهی آزمایشی)
def spectral_rolloff(spec, percentile=0.85):
    cum = 0
    total = sum(spec)
    if total == 0:
        return 0
    threshold = total * percentile
    for k, v in enumerate(spec):
        cum += v
        if cum >= threshold:
            return k
    return len(spec) - 1

def is_suspicious(audio):
    spec = magnitude_spectrum(audio)
    rolloff = spectral_rolloff(spec)
    return rolloff / len(spec) > 0.92
گفتار مصنوعی معمولاً در فرکانسهای بالا انرژی غیرعادی و صافی دارد. سیستمهای عملیاتی به جای این روش از AASIST استفاده میکنند، اما اساس کار و منطق ماجرا همین است.
گام 2: جاسازی و شناسایی با AudioSeal
from audioseal import AudioSeal
import torch

generator = AudioSeal.load_generator("audioseal_wm_16bits")
detector = AudioSeal.load_detector("audioseal_detector_16bits")

audio = load_wav("generated.wav", sr=16000)[None, None, :]
payload = torch.tensor([[1, 0, 1, 1, 0, 1, 0, 0, 1, 1, 0, 1, 0, 1, 1, 0]])
watermark = generator.get_watermark(audio, sample_rate=16000, message=payload)
watermarked = audio + watermark

result, decoded_payload = detector.detect_watermark(watermarked, sample_rate=16000)
# خروجی: اعشاری بین [0, 1] — احتمال وجود واترمارک
# decoded_payload: 16 bits; match against embedded payload
گام 3: ارزیابی — نرخ خطای برابر (EER)
def eer(real_scores, fake_scores):
    thresholds = sorted(set(real_scores + fake_scores))
    best = (1.0, 0.0)
    for t in thresholds:
        far = sum(1 for s in fake_scores if s >= t) / len(fake_scores)
        frr = sum(1 for s in real_scores if s < t) / len(real_scores)
        if abs(far - frr) < best[0]:
            best = (abs(far - frr), (far + frr) / 2)
    return best[1]
گام 4: یکپارچهسازی در محیط عملیاتی
def safe_tts(text, voice, clone_reference=None):
    if clone_reference is not None:
        verify_consent(user_id, clone_reference)
    audio = tts_model.synthesize(text, voice)
    audio_with_wm = audioseal_embed(audio, payload=build_payload(user_id, model_id))
    manifest = c2pa_sign(audio_with_wm, user_id, timestamp=now())
    return audio_with_wm, manifest
هر فایل خروجی باید با سه مؤلفه عرضه شود: 1) واترمارک، 2) مانیفست امضاشده، 3) لاگ حسابرسی منطبق با سیاستهای نگهداری داده.
کاربردهای عملی
| سناریوی کاربردی | راهکار دفاعی |
|---|---|
| عرضهی سامانهی تبدیل متن به گفتار (TTS) یا کلونسازی صدا | جاسازی AudioSeal روی تمام خروجیها (غیرقابلمذاکره) |
| باز کردن بیومتریک قفل با صدا | ترکیب AASIST و ECAPA؛ آزمون زندهبودن (Liveness challenge) |
| تشخیص کلاهبرداری در مراکز تماس | اجرای AASIST روی نمونهی 20 درصدی از تماسهای ورودی |
| تأیید اصالت پادکستها | امضای C2PA هنگام بارگذاری؛ AudioSeal در صورت تولید با هوش مصنوعی |
| پژوهش یا آموزش شناساگرها | مجموعههای آموزش، توسعه و ارزیابی در ASVspoof 5 |
خطاهای رایج
- واترمارکگذاری بدون اجرای شناساگر: کاری کاملاً بیفایده است. شناساگر را وارد خط لولهی CI خود کنید.
- تشخیص بدون کالیبراسیون: اگر AASIST را فقط روی ASVspoof LA آموزش دهید، بیشبرازش پیدا میکند و دقتش در دنیای واقعی افت خواهد کرد. مدل را بر اساس دامنهی دادههای خودتان کالیبره کنید.
- رخنه از طریق تغییر زیروبمی: تغییر شدید گام صدا، بیشترِ واترمارکها را از بین میبرد. حتماً سیستم شناسایی را بهعنوان پشتیبان داشته باشید.
- حذف متادیتا با بازمیزبانی: دور زدن C2PA فقط با یک بار انکود مجدد ممکن است. همیشه دفاع رمزنگاریشده را در کنار دفاع ادراکی (واترمارک) به کار ببرید.
- اشتباه گرفتن آزمون زندهبودن با شناسایی جعل: اینکه از کاربر بخواهید عبارتی تصادفی را تکرار کند جلوی حملات بازپخش (Replay attacks) را میگیرد، اما حریف کلونسازی زنده و بلادرنگ نمیشود.
آمادهی استقرار
این مستندات را در مسیر outputs/skill-spoof-defender.md ذخیره کنید. برای استقرار سامانهی تولید صدا، مدل تشخیص، واترمارک، مانیفست منشأ و سندیت و دستورالعمل اجرایی (Playbook) متناسب را انتخاب و تدوین کنید.
تمرینها
- ساده. اسکریپت
code/main.pyرا اجرا کنید. عملکرد شناساگر آزمایشی و روند جاسازی و شناسایی واترمارک را روی صدای مصنوعی بسنجید. - متوسط. کتابخانهی
audiosealرا نصب کنید؛ یک پیام 16 بیتی را در خروجی مدل TTS بگنجانید و آن را بازخوانی کنید. سپس با افزودن نویز، صدا را تخریب کرده و دقت بازیابی بیت را بسنجید. - پیشرفته. مدل RawNet2 یا AASIST را روی مجموعهی ASVspoof 2019 LA فاینتیون کنید. نرخ EER را اندازه بگیرید. مدل را روی نمونههایی جداگانه از کلیپهای تولیدشده با F5-TTS ارزیابی کنید تا ببینید عملکرد آن روی دادههای خارج از توزیع (OOD) چطور افت میکند.
اصطلاحات کلیدی
| اصطلاح | در گفتوگوهای عامیانه | معنای دقیق فنی |
|---|---|---|
| ASVspoof | بنچمارک استاندارد | چالش دوسالانه؛ نسخهی سال 2024 برابر با ASVspoof 5 است. |
| CM (اقدام متقابل) | شناساگر | کلاسیفایر تشخیص گفتار واقعی از صدای سنتزشده یا تبدیلیافته. |
| SASV | تأیید گوینده + CM | سامانهی یکپارچهی احراز هویت بیومتریک و تشخیص جعل صدا. |
| AudioSeal | واترمارک شرکت Meta | واترمارک موقعیتمحور با پیام 16 بیتی و 485 برابر سریعتر از WavMark. |
| Bit Recovery Accuracy | نرخ بقای واترمارک | نسبت بیتهای پیامی که پس از اعمال حمله با موفقیت بازیابی میشوند. |
| C2PA | مانیفست منشأ و سندیت | متادیتای رمزنگاریشده دربارهی سازنده و ابزار تولید محتوا. |
| AASIST | خانوادهی مدلهای شناساگر | مدل پیشرفته (SOTA) برای مقابله با جعل صدا مبتنی بر اتنشن گرافی. |
برای مطالعهی بیشتر
- مقاله Todisco و همکاران (2024) درباره ASVspoof 5 — بنچمارک استاندارد فعلی.
- مقاله Defossez و همکاران (2024) درباره AudioSeal — واترمارک استاندارد پیشفرض.
- مقاله Chen و همکاران (2025) درباره WaveVerify — شناساگر MoE برای مقابله با حملات زمانی.
- مقاله Jung و همکاران (2022) درباره AASIST — بکبون پیشرفته در شناسایی جعل صدا.
- بنچمارک AudioMarkBench (2024) — ارزیابی تابآوری واترمارکهای صوتی.
- مستندات استاندارد C2PA — ساختار مانیفست برای منشأ و سندیت محتوا.