
آموزش مستقیم الگوریتمهای یادگیری تقویتی روی رباتهای واقعی پرهزینه، خطرناک و بسیار کند است. شبیهسازها بستری امن و مقیاسپذیر برای جمعآوری داده فراهم میکنند، اما بهمحض انتقال مدل به سختافزار فیزیکی، تفاوتهای اصطکاک، تاخیر موتورها و خطای حسگرها باعث سقوط عملکرد خطمشی میشوند؛ پدیدهای که آن را «شکاف واقعیت» (Reality Gap) مینامیم.
در این درس یاد میگیرید که چطور با تکیه بر تصادفیسازی دامنه (Domain Randomization)، شناسایی سیستم (System Identification) و الگوی استاد-شاگرد، کنترلکنندههایی آموزش دهید که نسبت به خطاهای شبیهساز مقاوم باشند و بدون آسیب زدن به تجهیزات فیزیکی، در دنیای واقعی مستقر شوند.
خطمشیای (policy) که در شبیهساز آموزش دیده اما روی سختافزار واقعی شکست میخورد، صرفاً شبیهساز را حفظ کرده است. تصادفیسازی دامنه (domain randomization)، انطباق دامنه (domain adaptation) و شناسایی سیستم (system identification) سه ابزاری هستند که به کنترلکنندههای آموزشدیده امکان میدهند از شکاف واقعیت عبور کنند.
مسئله
آموزش روی ربات واقعی کُند، خطرناک و پرهزینه است. یک ربات دوپا برای یادگیری راهرفتن به میلیونها اپیزود آموزشی نیاز دارد؛ در حالی که حتی یک بار زمینخوردن ربات واقعی، سختافزار را از کار میاندازد. شبیهسازی امکان بازنشانیهای نامحدود، بازتولیدپذیری قطعی، محیطهای موازی و آسودگی از آسیب فیزیکی را فراهم میکند.
اما شبیهسازها دقیق نیستند. اصطکاک یاتاقانها از مدلهای MuJoCo بیشتر است. دوربینها اعوجاج لنزی دارند که در شبیهساز لحاظ نشده است. موتورها دچار تاخیر، لقی (backlash) و اشباعی (saturation) هستند که 99% از مدلهای شبیهسازی نادیدهشان میگیرند. باد، گردوغبار و نور متغیر میتوانند خطمشی آموزشدیده در یک محیط رندرینگ بینقص و ایزوله را کاملاً ناکارآمد کنند. شکاف واقعیت (reality gap) — یعنی تفاوت سیستماتیک میان توزیع شبیهساز و توزیع دنیای واقعی — چالش بنیادین استقرار یادگیری تقویتی در رباتیک است.
به خطمشیای نیاز دارید که در برابر تغییر توزیع از شبیهساز به دنیای واقعی (sim-to-real distribution shift) مقاوم باشد. از گذشته تاکنون سه رویکرد برای این کار وجود داشته است: تصادفیسازی شبیهساز (تصادفیسازی دامنه)، تطبیق خطمشی با مقدار کمی دادهی واقعی (انطباق دامنه / فاینتیونینگ)، یا اندازهگیری پارامترهای سیستم واقعی و تنظیم دقیق شبیهساز بر اساس آنها (شناسایی سیستم). در سال 2026، رویکرد غالب ترکیبی از هر سه روش همراه با شبیهسازی موازی در مقیاس انبوه است (Isaac Sim، Isaac Lab، Mujoco MJX روی GPU).
مفاهیم کلیدی
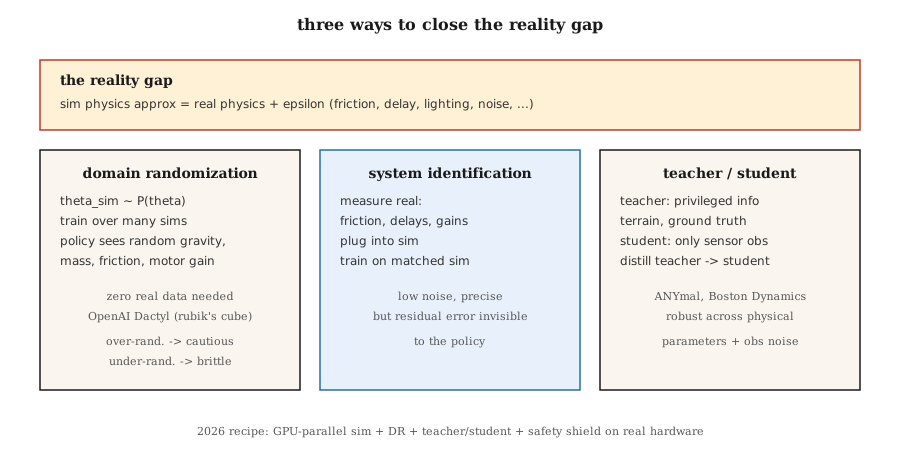
تصادفیسازی دامنه (Domain Randomization - DR). توبین و همکاران 2017، پنگ و همکاران 2018. در طول آموزش، تمام پارامترهای شبیهساز را که ممکن است روی ربات واقعی تفاوت داشته باشند تصادفی کنید: جرمها، ضرایب اصطکاک، بهرههای کنترلکنندهی PD موتورها، نویز حسگرها، موقعیت دوربین، نورپردازی، بافتها و مدلهای برخورد. خطمشی یک توزیع شرطی یاد میگیرد که بفهمد «امروز در کدام شبیهساز است» و روی کل این دامنه تعمیم پیدا کند. اگر ربات واقعی در محدودهی این پوشش آموزشی قرار بگیرد، خطمشی کار خواهد کرد.
- مزیت: به دادهی واقعی نیازی نیست. یک دستورالعمل برای رباتهای متعدد.
- عیب: آموزش با تصادفیسازی بیشازحد، خطمشیای «همهمنظوره» اما بهشدت محتاط میسازد. نویز بیشازحد تقریباً معادل با منظمسازی (regularization) بیشازحد است.
شناسایی سیستم (System Identification - SI). پیش از آموزش، پارامترهای شبیهساز را متناسب با دادههای دنیای واقعی برازش دهید. اگر میتوانید اصطکاک مفاصل بازو را روی ربات واقعی اندازه بگیرید، همان عدد را به شبیهساز بدهید؛ سپس خطمشیای آموزش دهید که همان مقادیر را انتظار دارد. این روش به ربات واقعی نیاز دارد، اما شکاف واقعیت را مستقیماً کاهش میدهد.
- مزیت: هدف آموزشی دقیق با نویز کم.
- عیب: خطای بازماندهی مدل برای خطمشی نامرئی میماند؛ اثرات ریز شناسایینشده (مانند محدودهی مرده یا deadband موتور) همچنان میتوانند استقرار نهایی را با شکست مواجه کنند.
انطباق دامنه (Domain Adaptation). آموزش در شبیهساز و سپس فاینتیونینگ با مقدار اندکی از دادههای واقعی. دو حالت دارد:
- روش Real2Sim2Real: با دادههای اجرای واقعی، یک شبیهساز بازمانده را یاد بگیرید و سپس در این شبیهسازِ اصلاحشده آموزش دهید. این روش بدون نیاز به دادههای واقعی زیاد، شکاف را میبندد.
- انطباق مشاهدات (Observation adaptation): خطمشیای آموزش دهید که با یک استخراجکنندهی ویژگی یادگرفتهشده (مانند GAN تصویربهتصویر)، مشاهدات واقعی را به مشاهداتی شبیه شبیهساز تبدیل کند. کنترلکننده در این حالت درون شبیهساز باقی میماند.
یادگیری ممتاز / استاد-شاگرد (Privileged learning / teacher-student). میکی و همکاران 2022 (ربات چهارپای ANYmal). مدلی تحت عنوان استاد در شبیهساز آموزش دهید که به اطلاعات ممتاز (دادهی واقعی اصطکاک، ارتفاع پستیوبلندیها، رانش IMU) دسترسی دارد. سپس مدلی تحت عنوان شاگرد را که تنها مشاهدات حسگرهای واقعی را میبیند از روی استاد تقطیر کنید. شاگرد یاد میگیرد که این ویژگیهای ممتاز را از تاریخچهی مشاهدات استنتاج کند و در برابر پارامترهای فیزیکی گوناگون مقاوم بماند.
شبیهسازی موازی در مقیاس انبوه. 2024 تا 2026. Isaac Lab، Mujoco MJX و Brax همگی هزاران ربات موازی را روی یک GPU اجرا میکنند. PPO با 4,096 ربات انساننمای موازی، سالها تجربه را در چند ساعت جمع میکند. هر چه توزیع آموزشی گستردهتر شود، «شکاف واقعیت» کوچکتر میشود؛ وقتی هر یک از این 4,096 محیط با پارامترهای تصادفی متفاوتی اجرا شوند، تصادفیسازی دامنه تقریباً بدون هزینهی پردازشی اضافه انجام میپذیرد.
دستورالعمل اجرایی در دنیای واقعی سال 2026 (مثال راهرفتن ربات چهارپا):
- شبیهسازی موازی انبوه با تصادفیسازی دامنهی گرانش، اصطکاک، بهرههای موتور و بار مفید (payload).
- آموزش خطمشی استاد با اطلاعات ممتاز (نقشهی پستیوبلندیها، دادهی واقعی سرعت بدنه).
- تقطیر خطمشی شاگرد از روی استاد، تنها با استفاده از حس عمقی (انکودرهای مفاصل پا).
- انطباق اختیاری مشاهدات با خودکدگذار (autoencoder) روی دادههای واقعی IMU.
- استقرار روی سیستم واقعی. اجرای بدون آموزش قبلی (Zero-shot) در بیش از 10 محیط مختلف. در صورت شکست، چند دقیقه فاینتیونینگ در دنیای واقعی با الگوریتم PPO و اعمال قیدهای ایمنی.
پیادهسازی
کد این درس، دموی کوچکی از تصادفیسازی دامنه روی یک GridWorld با انتقالهای نویزدار است. خطمشیای آموزش میدهیم که در «شبیهساز»، احتمال لغزشهای متفاوتی را تصادفی تجربه میکند و سپس آن را در محیط «واقعی» با نرخ لغزشی میسنجیم که هرگز در طول آموزش ندیده است. این سازوکار مستقیماً متناظر با انتقال مدل از MuJoCo به سختافزار واقعی است.
مرحلهی 1: شبیهساز پارامتریک
def step(state, action, slip):
    if rng.random() < slip:
        action = random_perpendicular(action)
    ...
مقدار slip پارامتری است که شبیهساز در اختیار ما میگذارد. در رباتیک واقعی، این پارامتر میتواند اصطکاک، جرم، بهرهی موتور یا هر متغیری باشد که میان شبیهساز و دنیای واقعی تغییر میکند.
مرحلهی 2: آموزش با DR
در ابتدای هر اپیزود، مقدار slip ~ Uniform[0.0, 0.4] را نمونهبرداری کنید. مدل را با PPO، Q-learning یا هر روش دلخواهی آموزش دهید. این کار را در اپیزودهای پرتعداد تکرار کنید.
مرحلهی 3: ارزیابی Zero-shot روی لغزشهای «واقعی»
مدل را روی مقادیر slip ∈ {0.0, 0.1, 0.2, 0.3, 0.5, 0.7} ارزیابی کنید. چهار مقدار نخست درون بازهی دادههای آموزشی هستند؛ مقادیر 0.5 و 0.7 بیرون از این بازهاند. خطمشیِ آموزشدیده با DR باید درون بازه نزدیک به حالت بهینه بماند و بیرون از بازه نیز عملکردش با افت شدیدی روبهرو نشود. در مقابل، خطمشیای که فقط با یک نرخ لغزش ثابت آموزش دیده، بیرون از دامنهی آموزشیاش بسیار آسیبپذیر خواهد بود.
مرحلهی 4: مقایسه با آموزش در دامنهی محدود
خطمشی دوم را فقط با مقدار slip = 0.0 آموزش دهید. آن را روی همان بازهی مقادیر slip بسنجید. خواهید دید که بهمحض بزرگتر شدن لغزش واقعی از 0، کارایی مدل ناگهان سقوط میکند.
دامها و خطاها
- تصادفیسازی بیشازحد. اگر مدل را روی
slip ∈ [0, 0.9]آموزش دهید، خطمشی آنچنان محتاط میشود که هیچگاه مسیر بهینه را امتحان نمیکند. آموزش را متناسب با توزیع موردانتظار دنیای واقعی تنظیم کنید، نه با این فرض که «هر اتفاقی ممکن است بیفتد». - تصادفیسازی بسیار کم. آموزش روی یک بازهی بسیار محدود، توانایی تعمیم را از خطمشی میگیرد. از برنامهی آموزشی انطباقی (Automatic Domain Randomization) استفاده کنید که همگام با پیشرفت خطمشی، دامنهی تصادفیسازی را بازتر میکند.
- تشخیص نادرست فضای پارامترها. تصادفیسازی پارامتر اشتباه (مثلاً تغییر رنگ و نور دوربین وقتی مشکل اصلی تاخیر موتور است) کمکی به DR نمیکند. پیش از هر چیز، رفتار ربات واقعی را ارزیابی و مشخصهبندی کنید.
- نشت اطلاعات ممتاز. اگر استاد برای تصمیمگیری در مورد اکشنها (نه فقط مشاهدات) از وضعیت سراسری استفاده کند، شاگردی میسازد که هرگز به پای او نمیرسد. مطمئن شوید خطمشی استاد با تکیه بر تاریخچهی مشاهدات شاگرد، برای شاگرد هم دستیافتنی و قابلاجرا باشد.
- شکست در انتقال شبیهساز به شبیهساز (Sim-to-sim). اگر خطمشی در برابر نسخهی دشوارتری از خود شبیهساز دوام نیاورد، در دنیای واقعی هم دوام نخواهد آورد. همیشه پیش از استقرار، مدل را روی یک نسخهی مجزا از شبیهساز محک بزنید.
- نبود لایهی محافظتی در دنیای واقعی. خطمشیای که در شبیهساز و حتی در دنیای واقعی بدون لایهی محافظتی ایمنی خوب عمل کند، باز هم ممکن است به سختافزار صدمه بزند. محدودیت نرخ درخواست (rate limit)، محدودیت گشتاور و محدودیت زاویهی مفاصل را در قالب یک کنترلکنندهی غیروابسته به یادگیری اعمال کنید.
کاربردها
استک sim-to-real در سال 2026:
| دامنه | استک |
|---|---|
| حرکت رباتهای پادار (ANYmal، Spot، انساننما) | Isaac Lab + تصادفیسازی دامنه (DR) + روش استاد/شاگرد ممتاز |
| دستورزی رباتیک (دستهای ماهر، برداشتن و گذاشتن اشیا) | Isaac Lab + تصادفیسازی دامنه (DR) + مدل DR-GAN برای بینایی |
| خودروهای خودران | CARLA / NVIDIA DRIVE Sim + تصادفیسازی دامنه (DR) + فاینتیونینگ روی دادههای واقعی |
| مسابقات پهپادی | RotorS / Flightmare + تصادفیسازی دامنه (DR) + انطباق برخط (online adaptation) |
| دستورزی دقیق دروندستی | OpenAI Dactyl (تصادفیسازی دامنه در مقیاس بیسابقه) |
| بازوهای صنعتی | MuJoCo-Warp + شناسایی سیستم (SI) + فاینتیونینگ محدود در واقعیت |
برای کنترل سیستمها در هر مقیاسی، روند کار ثابت است: شبیهساز را تا حد ممکن به واقعیت نزدیک کنید، متغیرهایی را که نمیتوانید بسنجید تصادفی کنید، خطمشیهای غولپیکر آموزش دهید، آنها را تقطیر کنید و در نهایت همراه با یک لایهی محافظتی ایمنی روی سیستم بنشانید.
تحویل پروژه
این فایل را در مسیر outputs/skill-sim2real-planner.md ذخیره کنید:
---
name: sim2real-planner
description: Plan a sim-to-real transfer pipeline for a given robot + task, covering DR, SI, and safety.
version: 1.0.0
phase: 9
lesson: 11
tags: [rl, sim2real, robotics, domain-randomization]
---

Given a robot platform, a task, and access to real hardware time, output:

1. Reality gap inventory. Suspected sources ranked by expected impact (contact, sensing, actuation delay, vision).
2. DR parameters. Exact list, ranges, distribution. Justify each range against real measurements.
3. SI steps. Which parameters to measure; measurement method.
4. Teacher/student split. What privileged info the teacher uses; what obs the student uses.
5. Safety envelope. Low-level limits, emergency stops, backup controller.

Refuse to deploy without (a) a zero-shot sim-variant test, (b) a safety shield, (c) a rollback plan. Flag any DR range wider than 3× measured real variability as likely over-randomized.تمرینها
- ساده. یک ایجنت Q-learning را در محیط GridWorld با لغزش ثابت (slip=0.0) آموزش دهید. آن را روی ارزیابی کنید. نمودار بازده (return) بر حسب لغزش را رسم کنید.
- متوسط. یک ایجنت Q-learning را با DR و نمونهبرداری تصادفی
slip ~ Uniform[0, 0.3]آموزش دهید. همان بازهی لغزش را ارزیابی کنید. روش DR در لغزش slip=0.5 (خارج از توزیع) چقدر به کارایی مدل کمک میکند؟ - سخت. یک برنامهی آموزشی مرحلهبهمرحله پیادهسازی کنید: آموزش را با slip=0.0 آغاز کنید و هر بار که خطمشی به 90% مقدار بهینه رسید، دامنهی DR را گسترش دهید. تعداد کل گامهای محیطی لازم برای رسیدن به عملکرد zero-shot در slip=0.3 را بسنجید و با مدل پایهای که DR ثابت داشته مقایسه کنید.
اصطلاحات کلیدی
| اصطلاح | در گفتار عامیانه | معنای فنی دقیق |
|---|---|---|
| شکاف واقعیت (Reality gap) | «تفاوت شبیهساز با دنیای واقعی» | جابهجایی توزیع بین فیزیک و حسگرهای محیط آموزش و محیط استقرار نهایی. |
| تصادفیسازی دامنه (DR) | «آموزش در شبیهسازهای گوناگون» | تصادفیسازی پارامترهای شبیهساز در زمان آموزش برای بالا بردن تعمیمپذیری خطمشی. |
| شناسایی سیستم (SI) | «اندازهگیری واقعیت و شبیهسازی آن» | تخمین پارامترهای فیزیکی واقعی و تنظیم شبیهساز بر مبنای آنها. |
| انطباق دامنه (Domain adaptation) | «فاینتیونینگ روی دادههای واقعی» | فاینتیونینگ محدود در دنیای واقعی پس از آموزش در شبیهساز؛ با امکان انطباق مشاهدات یا دینامیک. |
| اطلاعات ممتاز (Privileged info) | «دادهی واقعی برای مدل استاد» | اطلاعاتی که فقط شبیهساز در اختیار دارد؛ شاگرد باید آن را از تاریخچهی مشاهدات حدس بزند. |
| استاد/شاگرد (Teacher/student) | «تقطیر اطلاعات ممتاز به دادههای دیدهشدنی» | آموزش استاد با میانبرها و یادگیری شاگرد برای تقلید از او بدون دسترسی به آن میانبرها. |
| تصادفیسازی خودکار دامنه (ADR) | «تصادفیسازی خودکار دامنه» | برنامهی آموزشی پویایی که با پیشرفت خطمشی، دامنهی DR را گستردهتر میکند. |
| مدل Real2Sim | «پر کردن شکاف با دادههای واقعی» | یادگیری مدل بازمانده برای اینکه شبیهساز رفتاری شبیه به خروجیهای واقعی پیدا کند. |
مطالعهی بیشتر
- Tobin et al. (2017). Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World — مقالهی اصلی تصادفیسازی دامنه (بینایی در رباتیک).
- Peng et al. (2018). Sim-to-Real Transfer of Robotic Control with Dynamics Randomization — تصادفیسازی دامنه برای دینامیک سیستم و گامبرداری رباتهای چهارپا.
- OpenAI et al. (2019). Solving Rubik's Cube with a Robot Hand — پروژهی Dactyl و استفاده از ADR در مقیاس بزرگ.
- Miki et al. (2022). Learning robust perceptive locomotion for quadrupedal robots in the wild — معماری استاد-شاگرد برای ربات ANYmal.
- Makoviychuk et al. (2021). Isaac Gym: High Performance GPU Based Physics Simulation for Robot Learning — شبیهسازی موازی انبوه که پایهگذار استقرارهای عملیاتی سالهای 2025 و 2026 است.
- Akkaya et al. (2019). Automatic Domain Randomization — روششناسی برنامهی آموزشی ADR.
- Sutton & Barto (2018). Ch. 8 — Planning and Learning with Tabular Methods — چارچوب الگوریتم Dyna (استفاده از مدل برای برنامهریزی و جمعآوری داده) که زیربنای پایپلاینهای مدرن sim-to-real به شمار میرود.
- Zhao, Queralta & Westerlund (2020). Sim-to-Real Transfer in Deep Reinforcement Learning for Robotics: a Survey — دستهبندی جامع روشهای sim-to-real همراه با نتایج ارزیابیها.